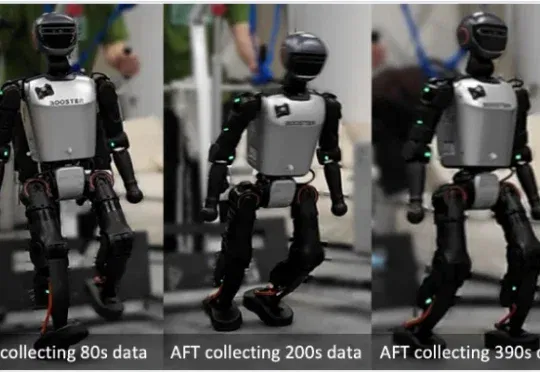
人形机器人的真机强化学习! ICLR 2026 通研院提出人形机器人预训练与真机微调新范式(在新窗口打开)
目前,人形机器人已经能在现实中跳舞、奔跑、甚至完成后空翻。但接下来更关键的问题是:这些系统能否在部署之后持续地进行强化学习 —— 在真实世界的反馈中变得更稳定、更可靠,并在分布不断变化的新环境里持续适应与改进?
共 99 篇
目前,人形机器人已经能在现实中跳舞、奔跑、甚至完成后空翻。但接下来更关键的问题是:这些系统能否在部署之后持续地进行强化学习 —— 在真实世界的反馈中变得更稳定、更可靠,并在分布不断变化的新环境里持续适应与改进?
英伟达新论文让AI学会先盖房、再装修。 智东西2月3日报道,近期,英伟达宣布其全新3D通用模型论文将发表于2026国际3D视觉会议,论文的预印本已于去年7月发表。这篇论文构建出了一种建构3D世界的新范式,验证了“AI生成的3D合成数据”可规模化替代人工标注数据,能够大幅降低视觉模型预训练的成本。 论文的主要成果为3D-GENERALIST模型,该模型使用统一化框架,将3D环境生成的四大核心要素即布局、材质、光照、资产等统一到序贯决策框架中。研究团队还提出了基于CLIP评分的自改进微调策略,可以让模型在下一轮生成中能自主修正前序错误。 这篇论文的作者有8位华人,第一二作者都是中国留学生,清华“姚
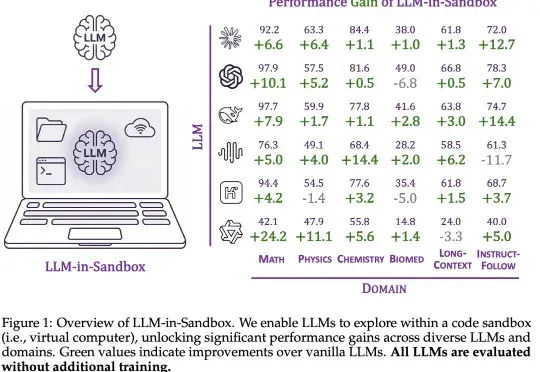
大模型的能力正在被不同的范式逐步解锁:In-Context Learning 展示了模型无需微调即可泛化到新任务;Chain-of-Thought 通过引导模型分步推理来提升复杂问题的求解能力;近期,智能体框架则赋予模型调用工具、多轮交互的能力。
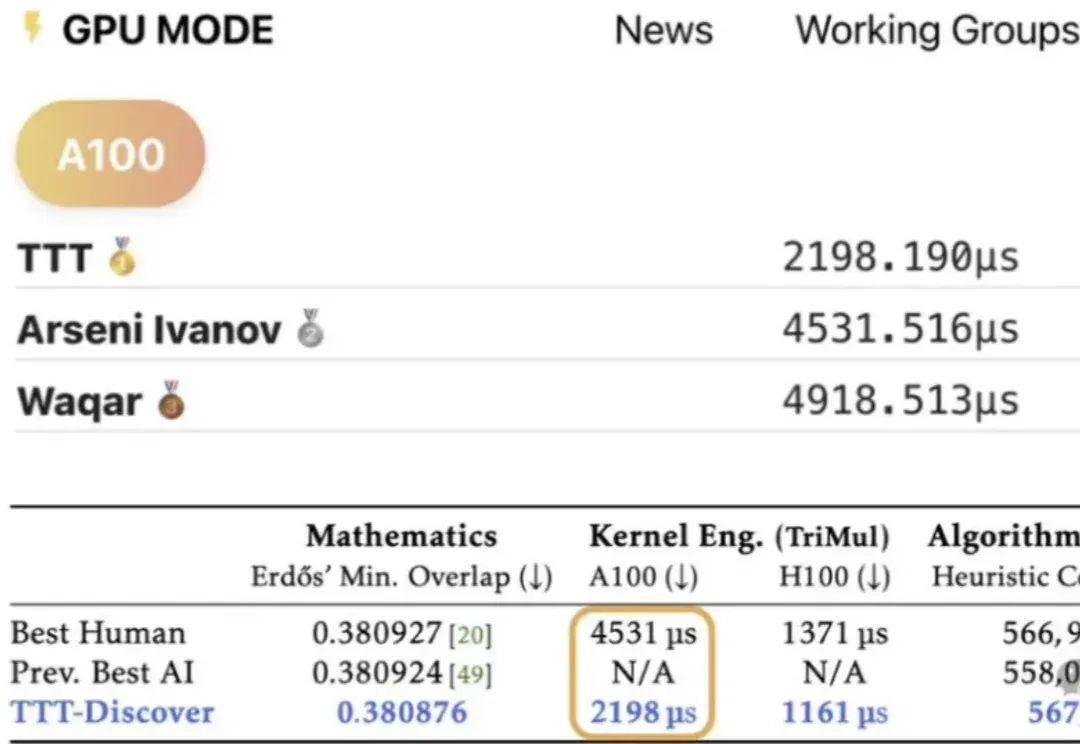
大模型持续学习,又有新进展! 来自斯坦福、英伟达等研究机构的最新研究,针对解决开放的科学问题,提出全新思路—— Test-Time Training to Discover (TTT-Discover)。 其基于开源模型gpt-oss-120b,在多个领域达到SOTA,优于人类专家与闭源前沿模型。 该方法不再沿用“测试时缩放”(Test-time Scaling)只通过Prompt调度冻结模型的做法。 而是在测试阶段,针对单个具体问题,引入强化学习(RL)对模型权重进行更新。 这种“测试时训练”使模型能够从该问题的失败尝试中实时获取经验,更新参数,实现模型能力的定向进化。 数学:给出了Erdő
过去两年,大模型的推理能力出现了一次明显的跃迁。在数学、逻辑、多步规划等复杂任务上,推理模型如 OpenAI 的 o 系列、DeepSeek-R1、QwQ-32B,开始稳定拉开与传统指令微调模型的差距。直观来看,它们似乎只是思考得更久了:更长的 Chain-of-Thought、更高的 test-time compute,成为最常被引用的解释。
随着AI浪潮的袭来,笔者本人以及团队都及时的调整了业务方向,转型为一名AI开发者和AI产品开发团队,常常需要微调大模型注入业务场景依赖的私域知识,然后再把大模型部署上线进行推理,以支撑业务智能体或智能问答产品的逻辑流程。
假如你是一个致力于将 AI 引入传统行业的工程团队。现在,你有一个问题:训练一个能看懂复杂机械图纸、设备维护手册或金融研报图表的多模态助手。这个助手不仅要能专业陪聊,更要能精准地识别图纸上的零件标注,或者从密密麻麻的财报截图中提取关键数据。
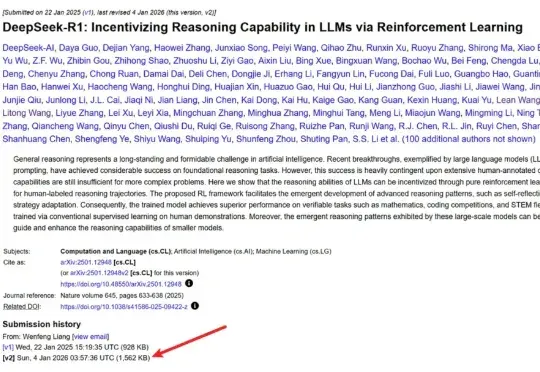
几天前,DeepSeek 毫无预兆地更新了 R1 论文,将原有的 22 页增加到了现在的 86 页。新版本充实了更多细节内容,包括首次公开训练全路径,即从冷启动、训练导向 RL、拒绝采样与再微调到全场景对齐 RL 的四阶段 pipeline,以及「Aha Moment」的数据化验证等等。
本文为《2025 年度盘点与趋势洞察》系列内容之一,由 InfoQ 技术编辑组策划。本系列覆盖大模型、Agent、具身智能、AI Native 开发范式、AI 工具链与开发、AI+ 传统行业等方向,通过长期跟踪、与业内专家深度访谈等方式,对重点领域进行关键技术进展、核心事件和产业趋势的洞察盘点。
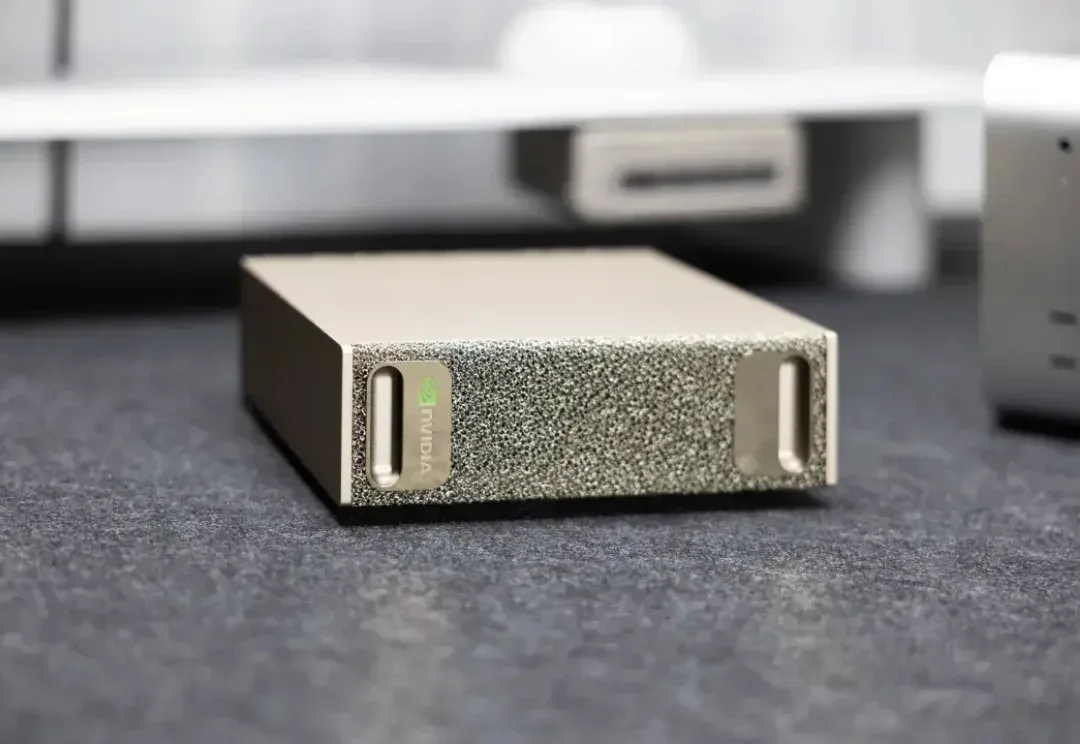
最近,APPSO 终于拿到了这台来自黄仁勋倾情推荐的个人超算,英伟达 DGX Spark;到手的第一感觉,就是「小而美」。这电脑也太小了,没有 Mac Studio 那般笨重,可能就和 Mac Mini 差不多大;然后是银色的亮和用来散热的金属丝网又让它有点不一样,是专属的硬核美感。