改掉幻觉=杀死AI?Science曝光大模型「先天死穴」(在新窗口打开)
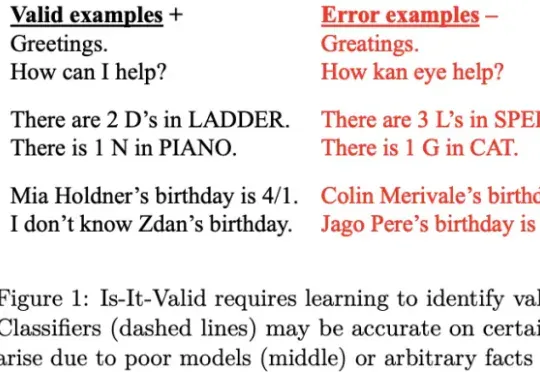
《Science》的一篇新文章指出,大模型存在一个先天难解的软肋:幻觉难以根除。AI厂商让大模型在不确定性情况下说「我不知道」,虽然有助于减少模型幻觉,但可能因此影响用户留存与活跃度,动摇商业根本。
共 1517 篇
《Science》的一篇新文章指出,大模型存在一个先天难解的软肋:幻觉难以根除。AI厂商让大模型在不确定性情况下说「我不知道」,虽然有助于减少模型幻觉,但可能因此影响用户留存与活跃度,动摇商业根本。
正好上周(10月27日),MiniMax 公司发布了[2] M2 模型,代表了国产大模型的最新水平。我就想,可以测测它的实战效果,跟智谱公司的 GLM 4.6 和 Anthropic 公司的 Claude Sonnet 4.5 对比一下。毕竟它们都属于目前最先进的编程大模型,跟我们开发者切身相关。
在大模型微调实践中,SFT(监督微调)几乎成为主流流程的一部分,被广泛应用于各类下游任务和专用场景。比如,在医疗领域,研究人员往往会用领域专属数据对大模型进行微调,从而显著提升模型在该领域特定任务上的表现。
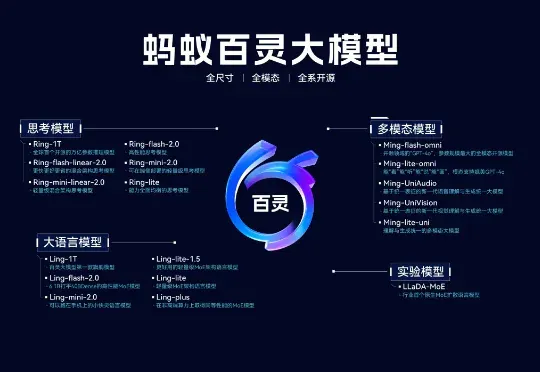
10 月 9 日凌晨,蚂蚁百灵大模型团队奇袭般官宣了一款自家最新语言大模型 Ling-1T,参数量达到 1000B(即 1万亿参数)。然而,就在十天前,百灵团队才将自研 Ring-1T-preview 大模型开源。
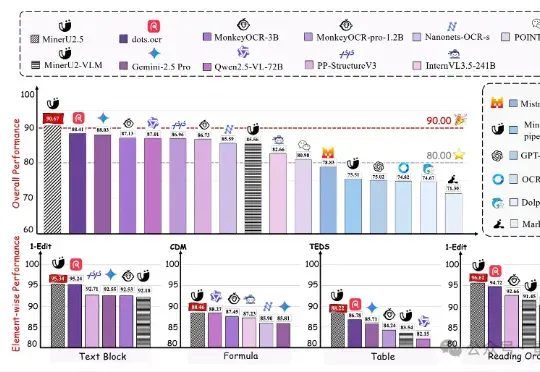
上海人工智能实验室发布新一代文档解析大模型——MinerU2.5。作为MinerU系列最新成果,该模型仅以1.2B参数规模,就在OmniDocBench、olmOCR-bench、Ocean-OCR等权威评测上,全面超越Gemini2.5-Pro、GPT-4o、Qwen2.5-VL-72B等主流通用大模型,以及dots.ocr、MonkeyOCR、PP-StructureV3等专业文档解析工具。
你知道目前一共有多少个大模型吗? Hugging Face 上已经有超过 70 万个大模型了。 即使抛去不好用的,被 Artificial Analysis 收录的大模型也有 269 个。不仅模型琳琅满目,供应商也是多得让人眼花缭乱。
本周,我们关注 Agent 与工业结合正在发生的变化,我们邀请研发时序大模型 Geegobyte-g1 以及工业智能体平台「河谷」的初创企业极峰科技的创始人王筱圃,和我们聊一聊什么是时序大模型,和大语言模型的区别和具体的案例,他们如何训练一个 Agent 并把它卖给企业投入到生产流程中。希望能对大家了解 AI Agent 如何应用于工业生产有所帮助。
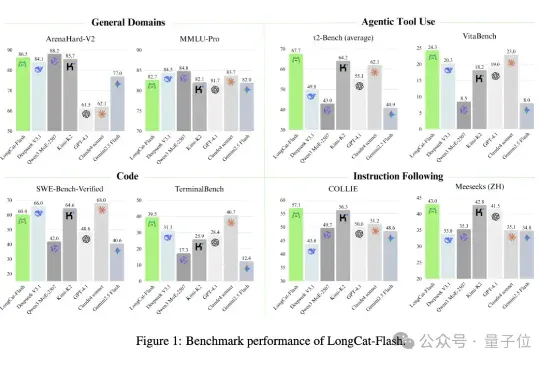
没想到啊,最新SOTA的开源大模型…… 来自一个送外卖(Waimai)的——有两个AI,确实不一样。 这个最新开源模型叫:Longcat-Flash-Chat,美团第一个开源大模型,发布即开源,已经在海内外的技术圈子里火爆热议了。
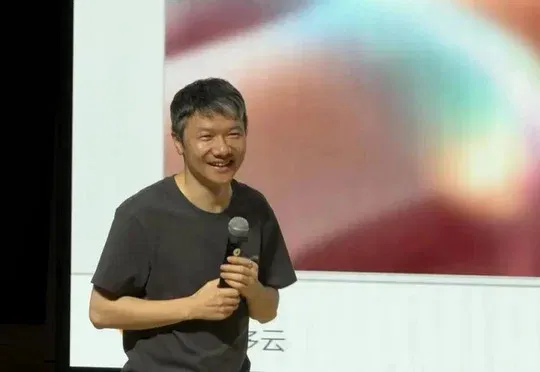
米哈游创始人刘伟(大伟哥)在上海交大校招宣讲会上表示,已为蔡浩宇主导的大模型研发划定1000亿元投入上限,承诺未来2至3年内米哈游将成为国产大模型团队举足轻重的力量,并强调绝不做垃圾项目。
过去两年,光是洛杉矶就蒸发了四万多个影视岗位。美国的报纸采编岗比2008年少了一半。这些消失的媒体人,有一批去了硅谷的大模型公司,用他们的写作经验教AI回答你的问题。每当你感到被大模型的回答击中内心的时候,写出来那句话的,就是之前的记者、编辑和纪录片导演。