业界首个视觉世界模型综述:迈向更高智能的视觉范式(在新窗口打开)
为了理清视觉与世界模型之间的深层联系,并为该领域的未来研究提供一张清晰的脉络图,北京交通大学靳潇杰、魏云超、赵耀等学者联合新加坡国立大学、腾讯、字节等国内外研究机构知名学者,发布了首篇视觉世界模型长篇综述:From Seeing to Knowing the World: A Survey of Vision World Models。
共 388 篇
为了理清视觉与世界模型之间的深层联系,并为该领域的未来研究提供一张清晰的脉络图,北京交通大学靳潇杰、魏云超、赵耀等学者联合新加坡国立大学、腾讯、字节等国内外研究机构知名学者,发布了首篇视觉世界模型长篇综述:From Seeing to Knowing the World: A Survey of Vision World Models。
就在刚刚,成立恰满一个月的阿里ATH(Alibaba Token Hub)事业群,发布全球首个主动式实时交互的世界模型产品。名也挺有趣的,叫HappyOyster(快乐生蚝)。HappyOyster搭载原生多模态架构,背后是支持多模态输入与音视频联合生成的流式生成世界模型,核心主打漫游(Wander)、导演(Direct)、创造(Create)、分享(Share)。
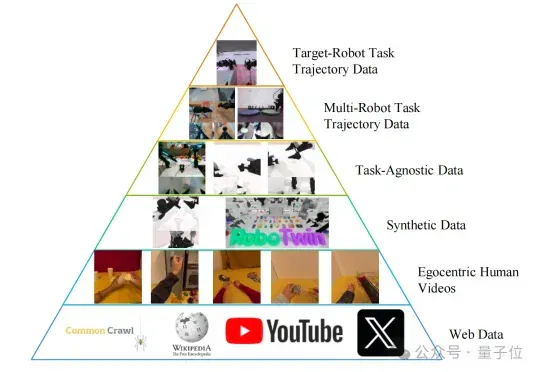
国产开源具身世界模型,直接秒了Pi-0.5,而且还是几位清华硕、博士研究生领衔推出的。这就是由生数科技联合清华大学,正式开源的大一统世界模型——Motus。
2025 年秋的具身智能赛道正被巨头动态点燃:特斯拉上海超级工厂宣布 Optimus 2.0 量产下线,同步开放开发者平台提供运动控制与环境感知 SDK,试图通过生态共建破解数据孤岛难题;英伟达则在 SIGGRAPH 大会抛出物理 AI 全栈方案,其 Omniverse 平台结合 Cosmos 世界模型可生成高质量合成数据,直指真机数据短缺痛点。
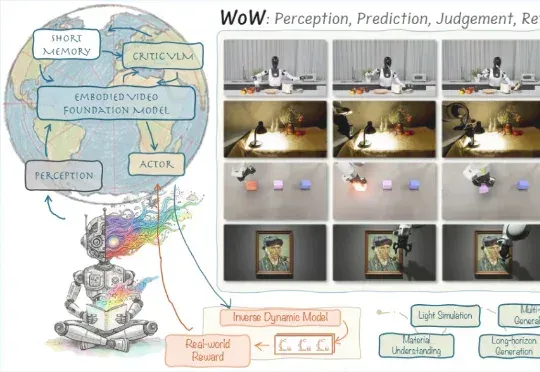
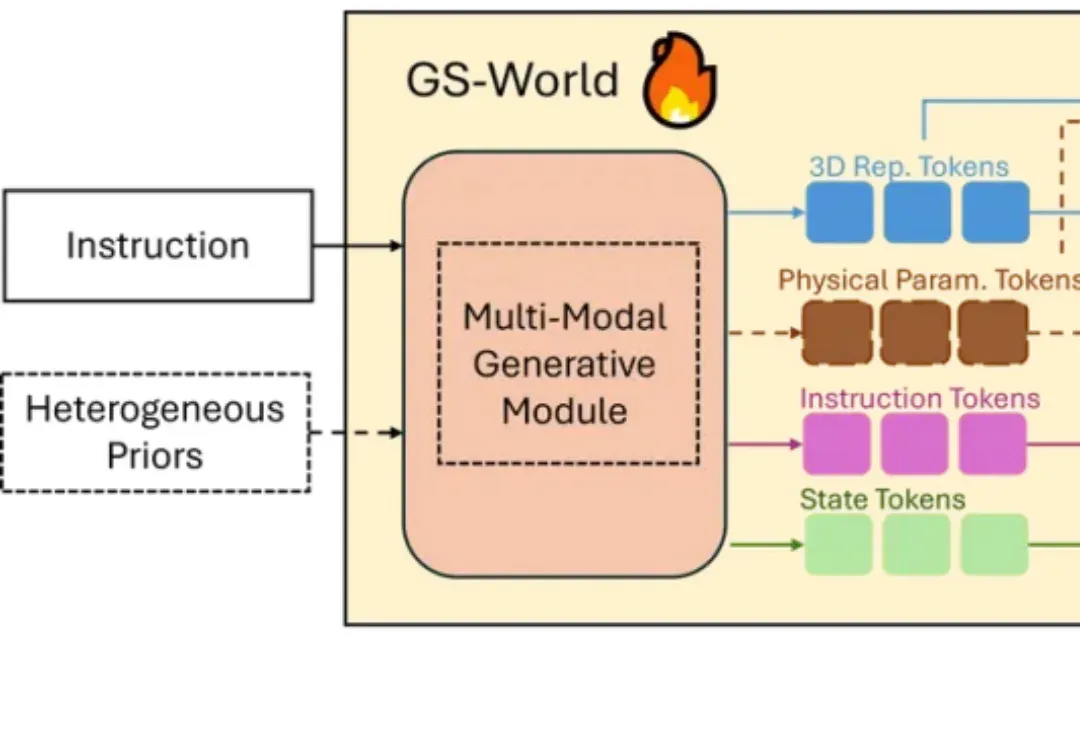
在「具身智能」与「世界模型」成为新一轮 AI 竞赛关键词的当下,来自北京人形机器人创新中心、北京大学多媒体信息处理国家重点实验室、香港科技大学的中国团队开源了全新的世界模型架构。
一张图,一个3D世界!今天,李飞飞团队重磅放出实时生成世界模型「RTFM」,通过端到端学习大规模视频数据,直接从输入2D图像生成同一场景下新视角的图像。值得一提的是,它仅需单块H100 GPU便能实时渲染出持久且3D一致的世界。
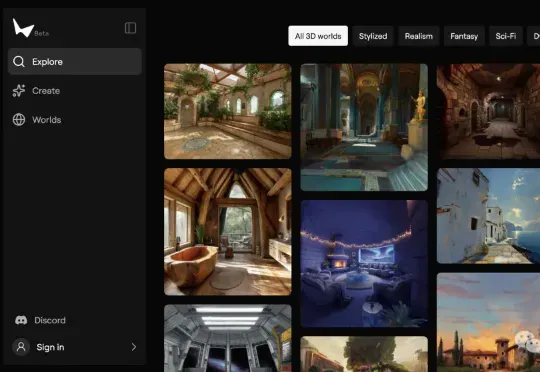
李飞飞创业公司世界模型新成果来了!只需要一个图像或者提示,就能构建出一个可以无限探索的3D世界——世界更大、风格更多样、3D几何结构更清晰,并且保持一致性、没有时间限制、没有奇怪的变形。
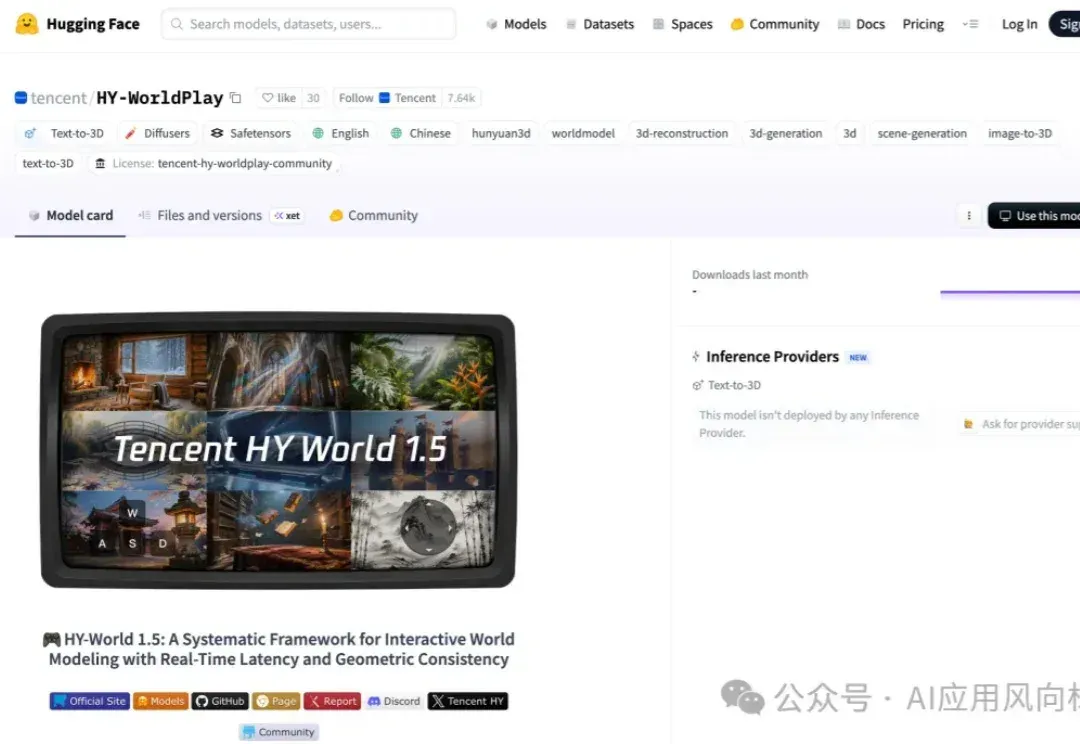
可支持24帧/秒的长时流式生成。 智东西12月17日报道,今天,腾讯混元发布并开源了最新的混元世界模型1.5(Tencent HY WorldPlay),用户输入文字指令或者图片即可创建可交互世界,该模型拥有空间记忆能力,能呈现出前后一致的场景,支持用户在生成的世界里随意移动探索。目前,这一模型可在腾讯混元3D官网申请体验。 这一模型支持生成第一视角和第三视角场景,能生成多种类型的风格化场景,还支持场景触发特定效果,可应用于AI游戏开发、影视制作和虚拟现实(VR)和具身智能训练等领域。从官方给出的效果图来看,仅通过输入“废弃游乐园,生锈的摩天轮,杂草丛生,怀旧忧伤”这一指令,该模型便生成了精度
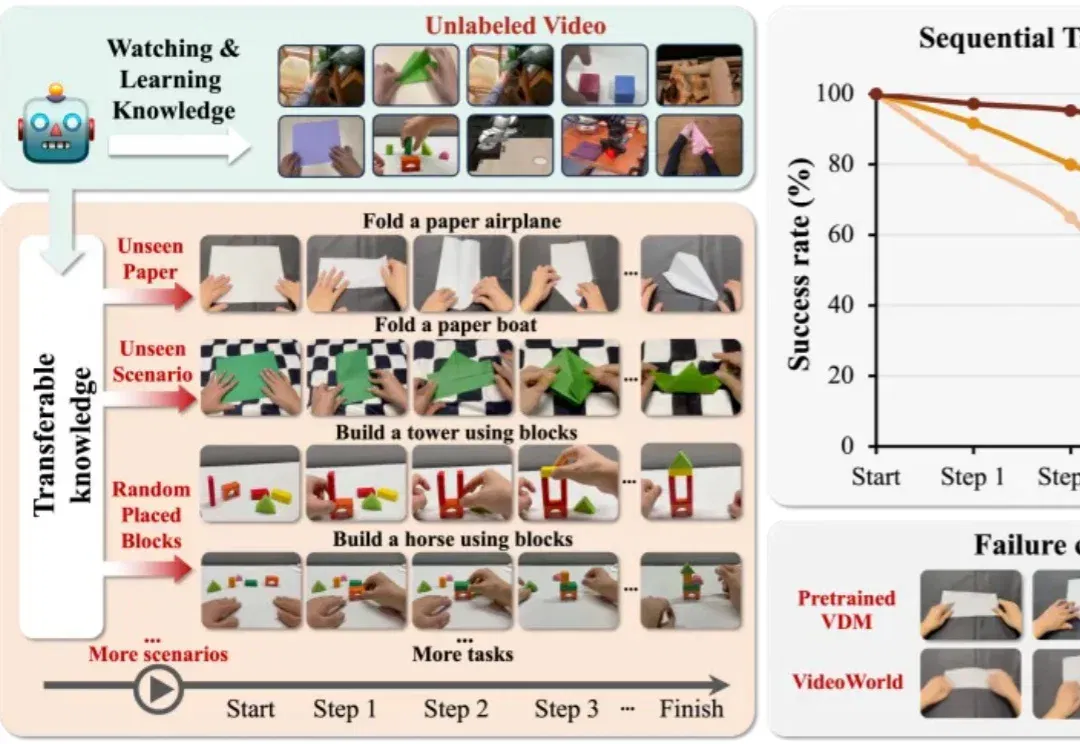
视觉世界模型 “VideoWorld 2” 由豆包大模型团队与北京交通大学联合提出。不同于 Sora 2 、Veo 3、Wan 2.2 等主流多模态模型,VideoWorld 系列工作在业界首次实现无需依赖语言模型,即可认知世界。
最近,来自牛津大学&莫纳什大学&布里斯托大学的团队提出了交互式视频世界模型 Oneira,将这类模型从开放式的生成走向开放世界的交互。