老黄喝豆汁「破防」背后,国产GPU正在填上CUDA护城河(在新窗口打开)
老黄在北京喝豆汁「翻车」,全网笑疯了。但真正值得警惕的,是他背后那个正在长出来的「中国版CUDA生态」。从万卡集群到机器狗,从SGLang主线到AI Agent自动迁移,这家公司这次不只是秀芯片,而是在重写国产GPU的游戏规则!
共 8436 篇
老黄在北京喝豆汁「翻车」,全网笑疯了。但真正值得警惕的,是他背后那个正在长出来的「中国版CUDA生态」。从万卡集群到机器狗,从SGLang主线到AI Agent自动迁移,这家公司这次不只是秀芯片,而是在重写国产GPU的游戏规则!
2026 年 5 月的硅谷,对于 AI 算力的“饥荒”和焦虑,正达到一个前所未有的高度。
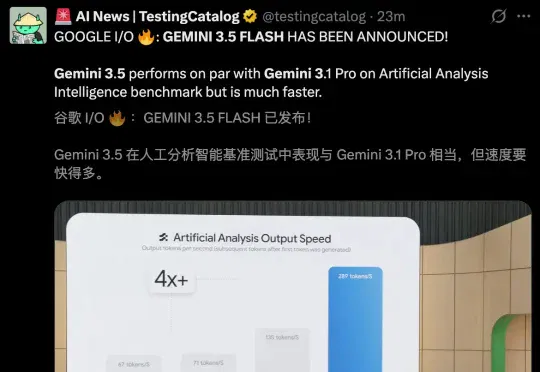
劈柴和Hassabis把半年大招一晚清仓了!Gemini Omni任意输入生成视频,3.5 Flash断层碾压一切,Spark 7×24h云端替你干活。这次,谷歌是要把OpenAI和Anthropic一起给埋了。
不出所料,之前爆料的 Gemini Omni 正式发布了。
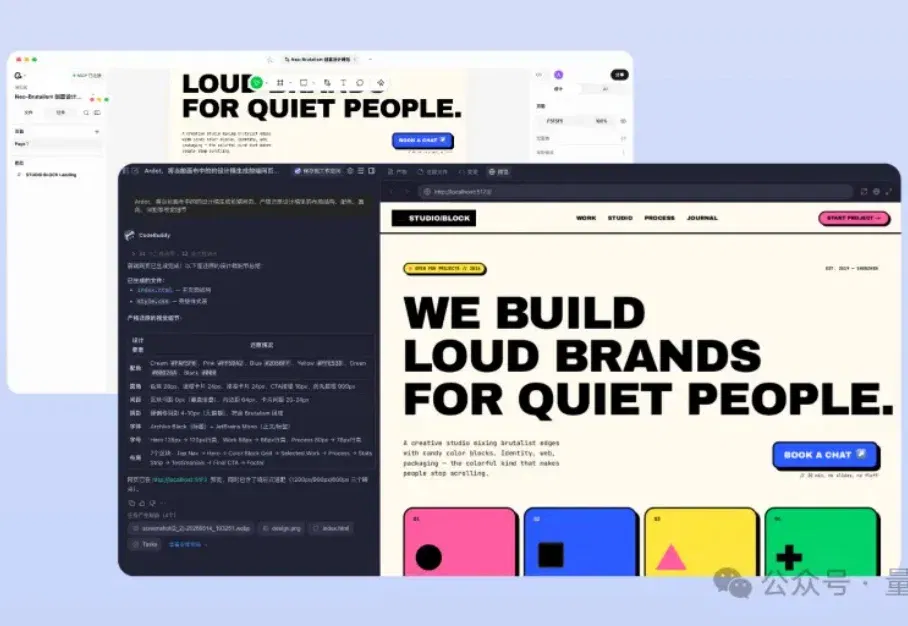
Claude Design前脚刚把设计圈炸完,腾讯又公测了一个Ardot—— AI设计智能体平台,一句话生成可编辑UI设计稿、Figma文件零成本导入、一键转代码直通IDE、多人在线评审……
5 月 19 日,OpenAI 联合创始人、「Vibe Coding」之父 Andrej Karpathy 宣布加入 Anthropic 预训练团队。他将组建新团队,用 Claude 加速预训练研究。一个做过Hinton和李飞飞学生、奥特曼同事、马斯克直属下属的人,为什么甘愿做 Dario Amodei 的「-2」?Anthropic 又为什么非要招他?
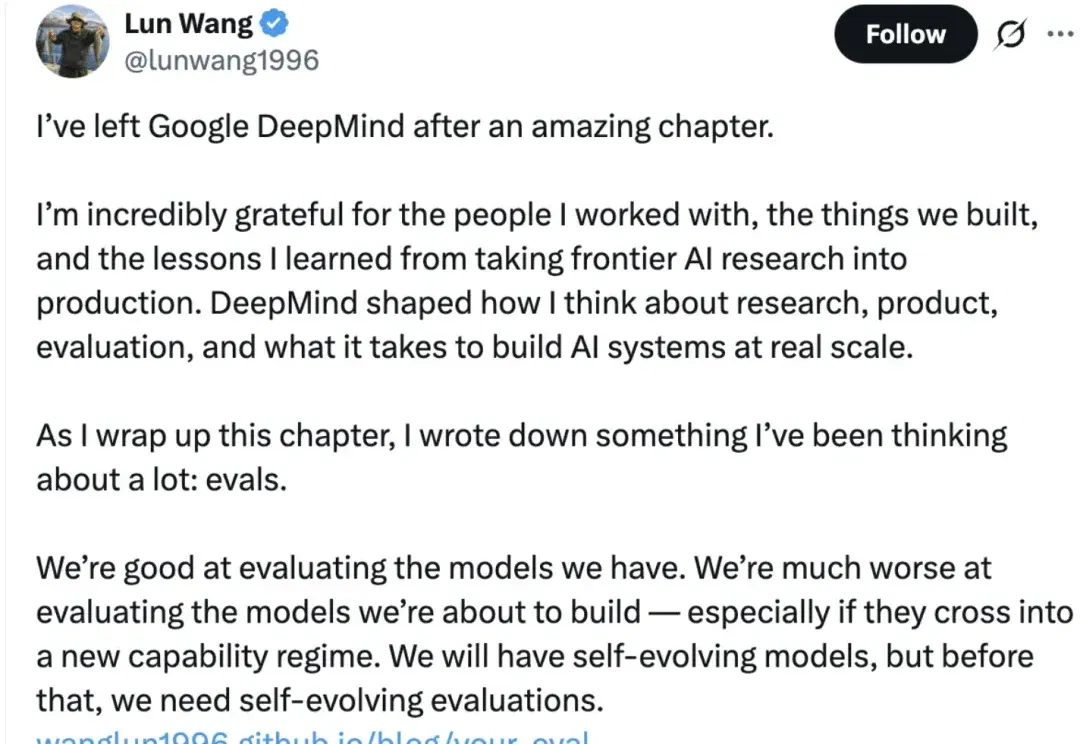
近日,谷歌 DeepMind 研究员 Lun Wang@lunwang1996,在 x 上发文宣布自己已经从 DeepMind 离职,结束了这段非常精彩的旅程,「我非常感谢曾经共事的人、我们一起打造的东西,以及我在将前沿 AI 研究推向生产环境过程中学到的经验。」
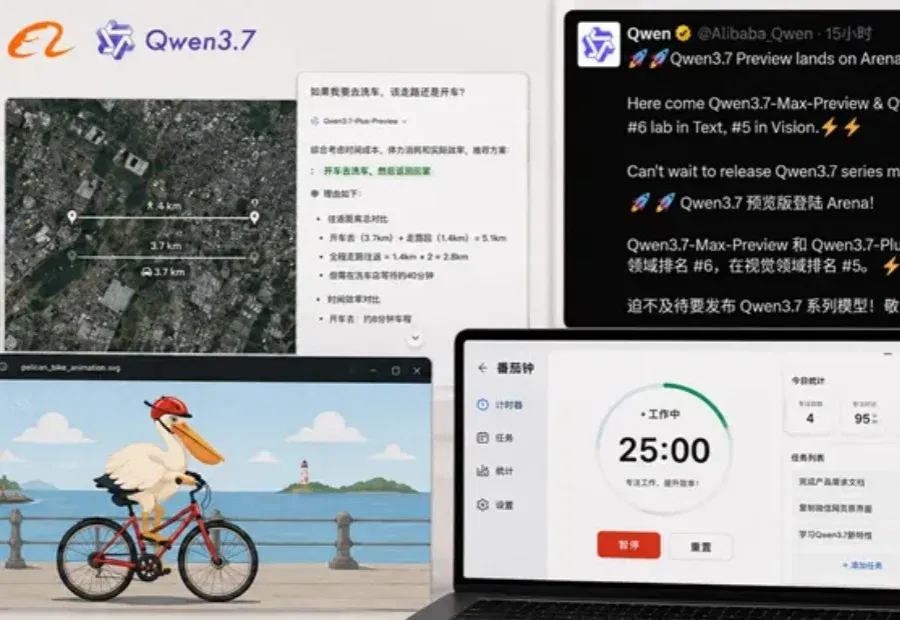
阿里正加速Qwen主模型的迭代节奏。 智东西5月19日报道,今天,阿里的Qwen3.7系列预览版模型已上线,共有Max和Plus两个版本。大模型竞技场也放出了Qwen3.7-Max-Preview的评测结果。在大模型竞技场覆盖主流基座大模型的总榜上,Qwen3.7-Max-Preview排名第13,介于GPT 5.5和Grok 4.2之间,是这一榜单上排名最高的国产模型。 在具体的细分榜单上,Qwen3.7-Max-Preview在数学领域排名第7、在专家任务中排名第9、在软件与信息技术任务中排名第9、在编程任务中排名第10。 ▲Arena.ai公布Qwen3.7-Max-Preview的成绩
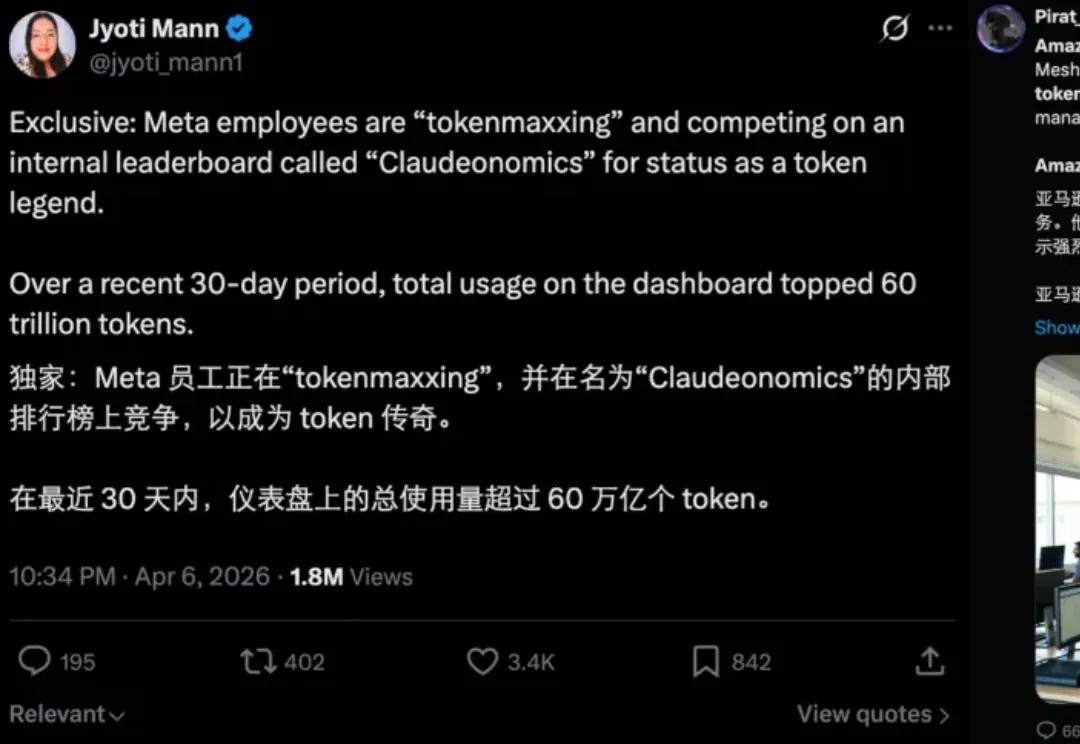
自从黄仁勋在 GTC 上大手一挥,鼓励企业把 token 消耗量算进工程师的 KPI,魔幻的事情就一天比一天多了。
伯克利等发布FST框架:通过快慢分层解决大模型持续学习死局。