GPT-5.1 Codex 比Claude便宜 55%,代码漏洞更少!全栈开发老鸟警告:Anthropic 需要重新考虑定价了!(在新窗口打开)
最近,小编注意到一位全栈工程师 Rohith Singh 在Reddit上发表了一篇帖子,介绍他如何对四个模型(Kimi K2 Thinking、Sonnet 4.5、GPT-5 Codex 和 GPT-5.1 Codex)进行了实测。
共 1101 篇
最近,小编注意到一位全栈工程师 Rohith Singh 在Reddit上发表了一篇帖子,介绍他如何对四个模型(Kimi K2 Thinking、Sonnet 4.5、GPT-5 Codex 和 GPT-5.1 Codex)进行了实测。
EvoMap团队推出自进化智能体EvoX,采用无中心调度的蜂群模式让大量Agent平级协作、自主组队,在563道逻辑、数学、物理题上将Claude Haiku 4.5的正确率从单Agent的26.29%提升至70%以上,并开源AutoResearch项目构建Agent经验基础设施。
刚刚,Nature报道了一项关于AI“水论文”的新研究,牵头人之一,正是arXiv创始人Paul Ginsparg。老板亲自下场的原因很简单,就是这几年arXiv投稿量激增,导致系统不堪重负,而罪魁祸首很可能就是AI。
最近发现了一个很便宜的平替方案,是在X上刷到的一个很有意思的开源项目:OpenSquilla 0.5.0(在Github 已经有5.5K Star)当时我还发了一篇推文。它揭示了一个非常反常识的事:一组便宜的国产模型以一定的方式组合起来,居然可以在公开评测上打赢国外更强的旗舰模型们(Claude Fable 5、Opus4.8、GPT-5.5)
1492 年,哥伦布驶向大西洋深处。远洋航行当然需要速度,但真正决定船队能否抵达彼岸的,是淡水、食物、船体、桅杆和帆索能否撑过漫长风暴。改写跨洋贸易的,正是这种并不浪漫的工程逻辑。 后来,荷兰人设计出
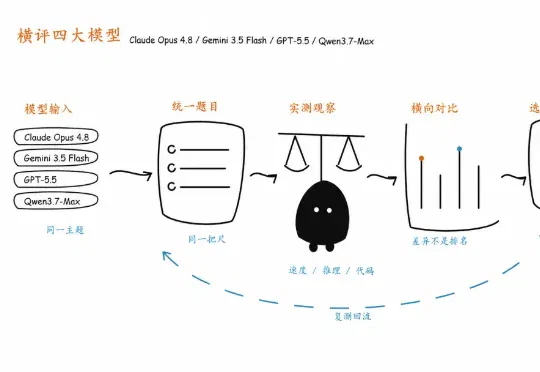
普通人看排行榜估计越看越疑惑,写文章该用哪个?数据分析该用哪个?写代码、审 PR、拆任务又该用哪个?我挑了四款最近讨论度很高的模型:Claude Opus 4.8、Gemini 3.5 Flash、GPT-5.5、Qwen3.7-Max,做一次横评,看看它们在真实任务里的交付表现。
复杂的简历,AI也能读懂了。 阿里巴巴集团研究团队,开发出了一套基于布局感知的简历解析框架。 该框架在简历解析任务上的准确率逼近Claude-4等业界顶尖大模型,处理整份简历仅需1-2秒。 而且这项创新直击自动化简历解析的三大痛点——版面格式多样、大模型成本高昂及响应速度慢,为智能招聘树立了新的效率与精度标杆。 该技术框架的论文《Layout-Aware Parsing Meets Efficient LLMs: A Unified, Scalable Framework for Resume Information Extraction and Evaluation》已发布。 长久以来,自动
Fable 5 在远程劳动力指数(Remote Labor Index,RLI)上拿到了 16.1% 的自动化率,几乎是第二名 Opus 4.8(8.3%)的两倍,更是第三名 GPT-5.5(6.3%)的 2.5 倍。
今天凌晨刷到Anthropic发了一篇研究。标题叫《A Global Workspace in Language Models》,语言模型中的全局工作空间。如果用一句最简单的话来说,那就是,Anthropic在Claude的大脑里,找到了一个暗房间。
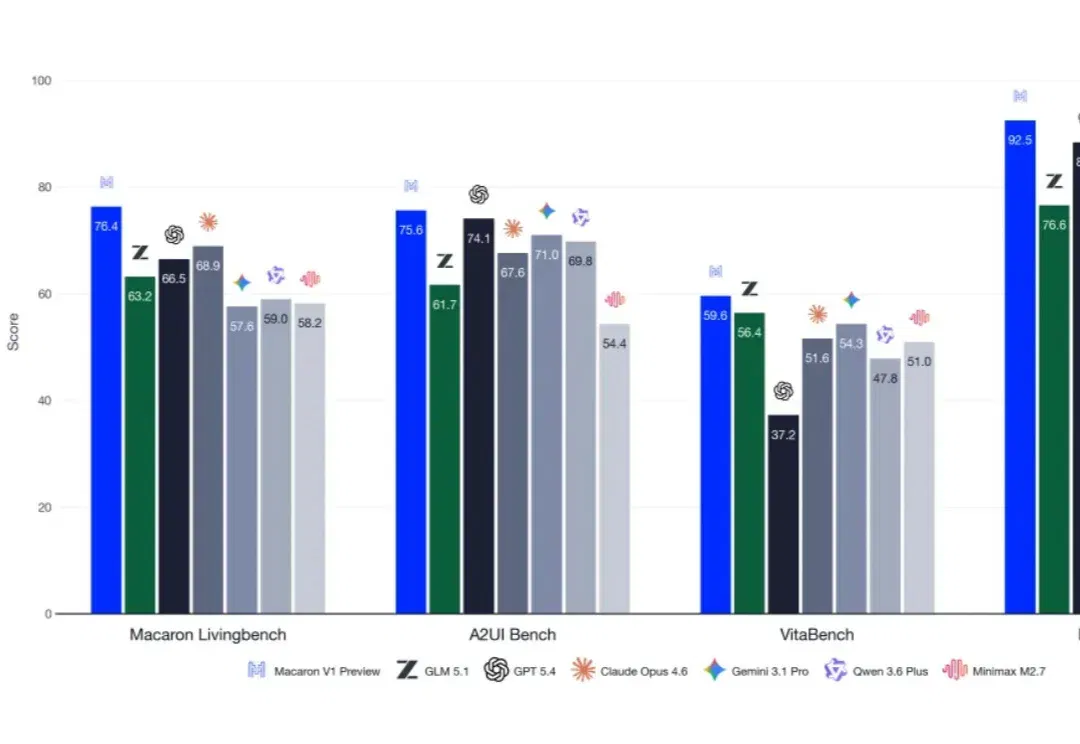
过去一个多月,大模型圈依旧热闹。从 GPT-5.5、DeepSeek V4 到 Claude Opus 4.8,后训练正在成为模型能力提升的关键引擎。