搜索

关于“智能体”的结果

共 916 篇

浙大推出让AI会「导演」的角色扮演框架!四通道消息沉浸式交互|ACL 2026

浙大推出让AI会「导演」的角色扮演框架!四通道消息沉浸式交互|ACL 2026(在新窗口打开)

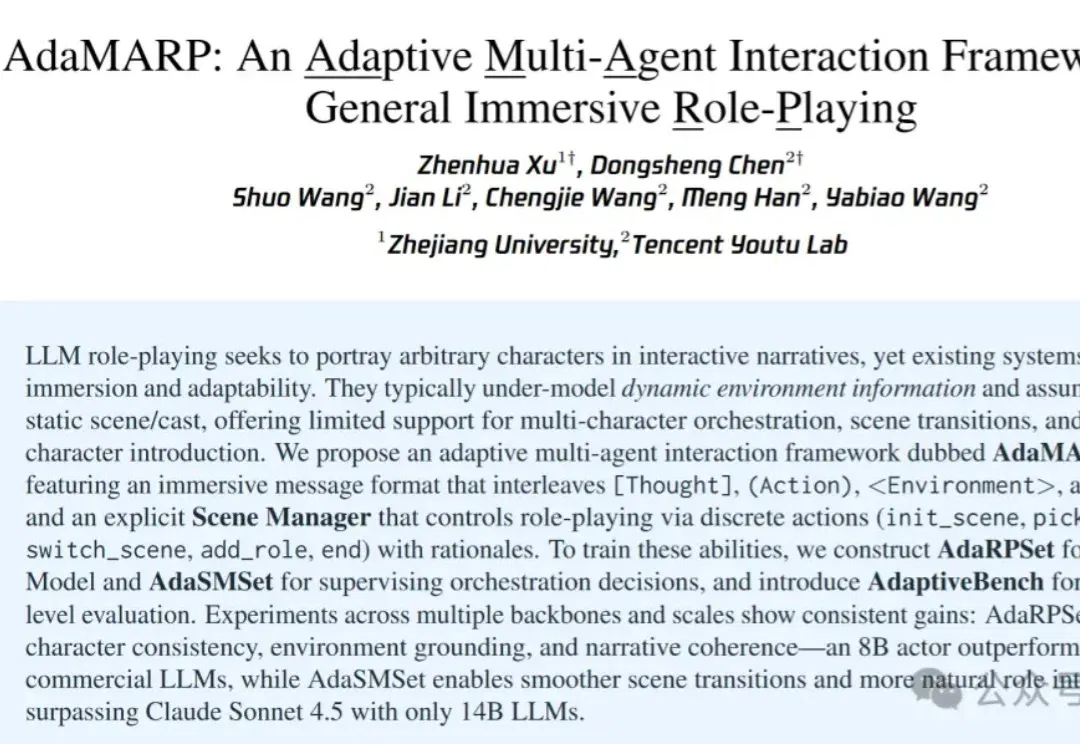
AI能实现真正的沉浸式扮演了。 大语言模型在角色扮演任务上进展迅速,但现有系统往往缺乏沉浸感和适应性: 环境信息未被充分建模,场景与角色也多为静态,难以支撑多角色调度、场景切换、动态引入新人等复杂叙事需求。 现在,浙江大学联合腾讯优图实验室提出AdaMARP(Adaptive Multi-Agent Interaction Framework for General Immersive Role-Playing)—— 一种面向通用沉浸式角色扮演的自适应多智能体交互框架。 该框架通过四通道消息格式和场景管理器,让AI不仅会「说」,还会「想」、会「动」、会「感知环境」,并在复杂叙事中灵活切换场景、
AI技术文章
0
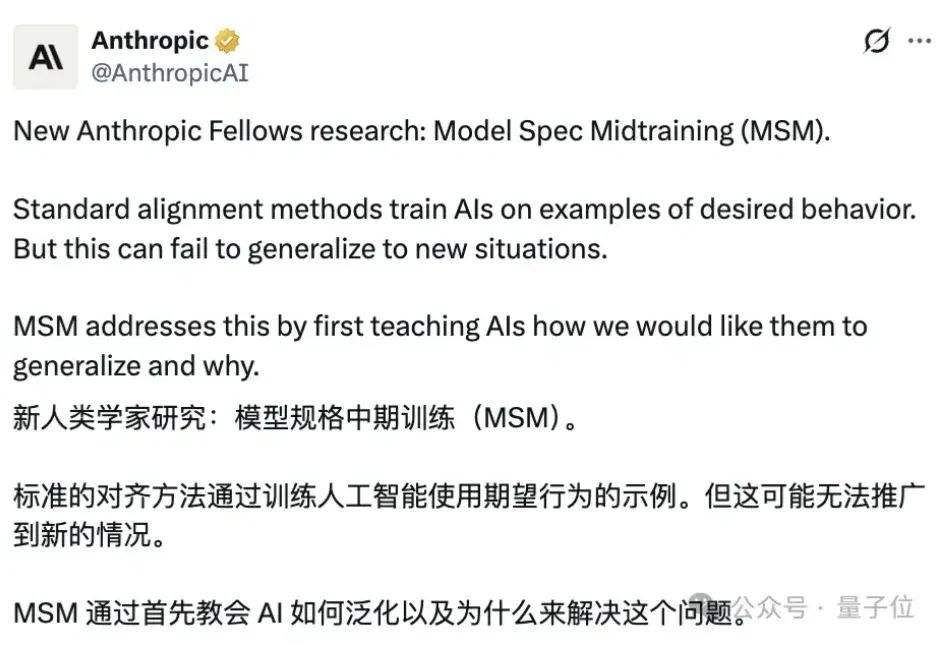
Claude团队用Qwen测试全新训练方法

Claude团队用Qwen测试全新训练方法(在新窗口打开)

别人做AI中训练都在堆语料、补知识。 Anthropic这边直接给大模型上价值观必修课。 最新研究提出的中训练(简称MSM)精准插在预训练之后、后训练之前,专门用来给AI立规矩、塑三观。 更准确地说,就是在模型预训练结束、还没开始对齐微调之前,先用模型规范讲解文档做一轮对齐前置特训。 在这个阶段,模型不直接学习合规行为案例,而是通过大量专门讲解模型规范的合成文档,进行专项训练。 让模型先完整理解自身需要遵守的规范、原则、价值内核,再进入后续的对齐微调环节。 实验显示,仅靠新增一轮中训练,就能让通义千问两款32B大模型智能体失准率从68%、54% 降至 5%、7%,同时还能精简40至60倍微调数

AI技术文章
0
蔡浩宇美国公司换血背后:裁撤大模型团队,押注超级智能体

蔡浩宇美国公司换血背后:裁撤大模型团队,押注超级智能体(在新窗口打开)

在对多位内部开发者的采访中得知,这个模型的研发已被叫停。LPM 1.0 并非仍在推进的核心项目,而是视频团队对过去一年工作成果的集中汇报——既是对外展示,也是对内总结。该视频团队由“童姥”( 前微软亚研院首席研究员童欣) 带领, AilingZeng做Tech Lead,作者中近半数来自 Anuttacon内部,蔡浩宇本人并未直接参与模型研发。

AI资讯
0
Assort Health 用Agent 接管诊所核心运营,B轮融资7600万美金,4年估值翻了250倍。

Assort Health 用Agent 接管诊所核心运营,B轮融资7600万美金,4年估值翻了250倍。(在新窗口打开)

Assort Health 是一家值得被认真拆解的初创公司。成立仅两年多,累计融资1.015亿美元,拿着300万美元的ARR(年度经常性收入),却获得了7.5亿美元的估值。Assort 最近推出主动式互动引擎 Activate,从被动接听到主动做患者唤醒和慢病管理,这已经是在为真正面向用户的智能体做铺垫了。

AI资讯
0
DeepSeek版Claude Code登顶热榜:8700星,鲸鱼哥火了

DeepSeek版Claude Code登顶热榜:8700星,鲸鱼哥火了(在新窗口打开)

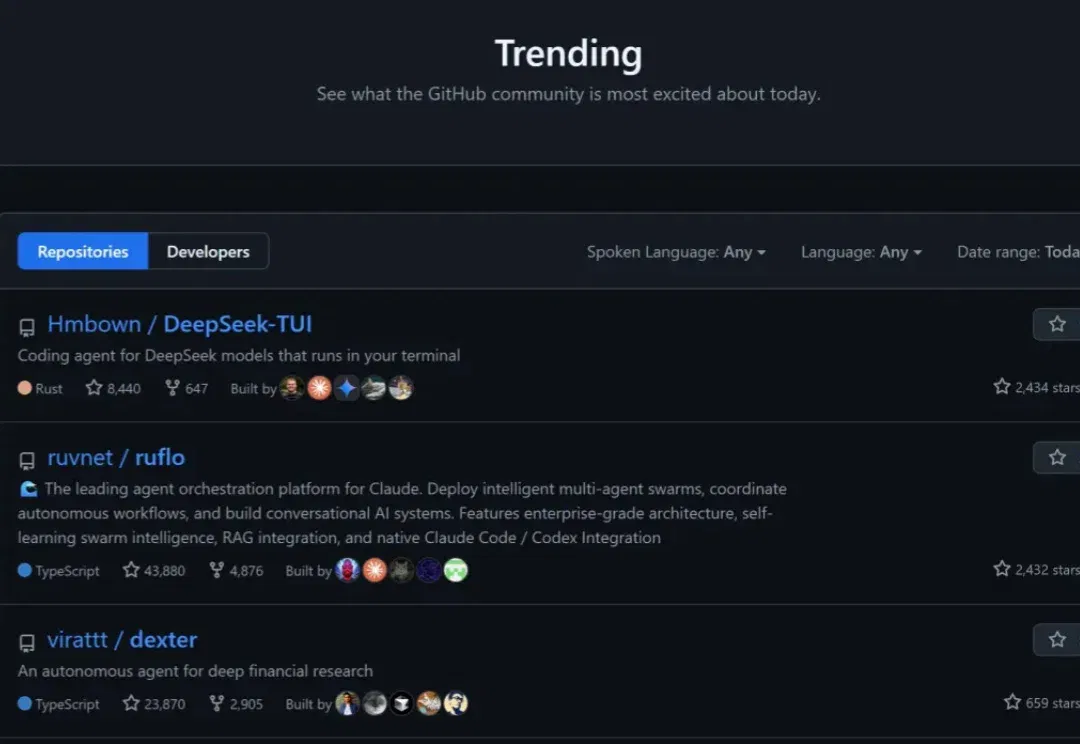
感谢鲸鱼兄弟开源。 DeepSeek V4 才推出一个星期,DeepSeek 版的 Claude Code 就登顶了 GitHub 热榜。大家缺的就是这么一个工具。 目前已经有了超过 8700 的 Star 量,数字还在以肉眼可见的速度增长。 这还只是个开始。 DeepSeek TUI 是一个完全运行在本地终端里的 AI 编程智能体,由自称「鲸鱼兄弟」的 Hunter Bown 用 Rust 语言开发。它专门为 DeepSeek(尤其是最新发布的 DeepSeek V4 大模型)打造,能提供终端原生、长上下文、推理过程可视化的使用体验与效果。 它用开放工具链和极低的成本,打响了替代主流高价 A

AI技术文章
0
ACL 2026 | RouteMoA:无需预推理的动态路由,实现高效多智能体混合

ACL 2026 | RouteMoA:无需预推理的动态路由,实现高效多智能体混合(在新窗口打开)

研究者开始尝试让 MoA 变稀疏。例如,一些方法如 Sparse MoA 会先让模型池中的所有模型生成回答,再通过额外的评审模型进行打分和筛选,只保留一部分模型进入后续协作。这样虽然减少了后续融合的负担,但本质上仍然绕不开一个问题:为了决定该选谁,系统还是得先让所有模型都推理一遍。

AI技术文章
0