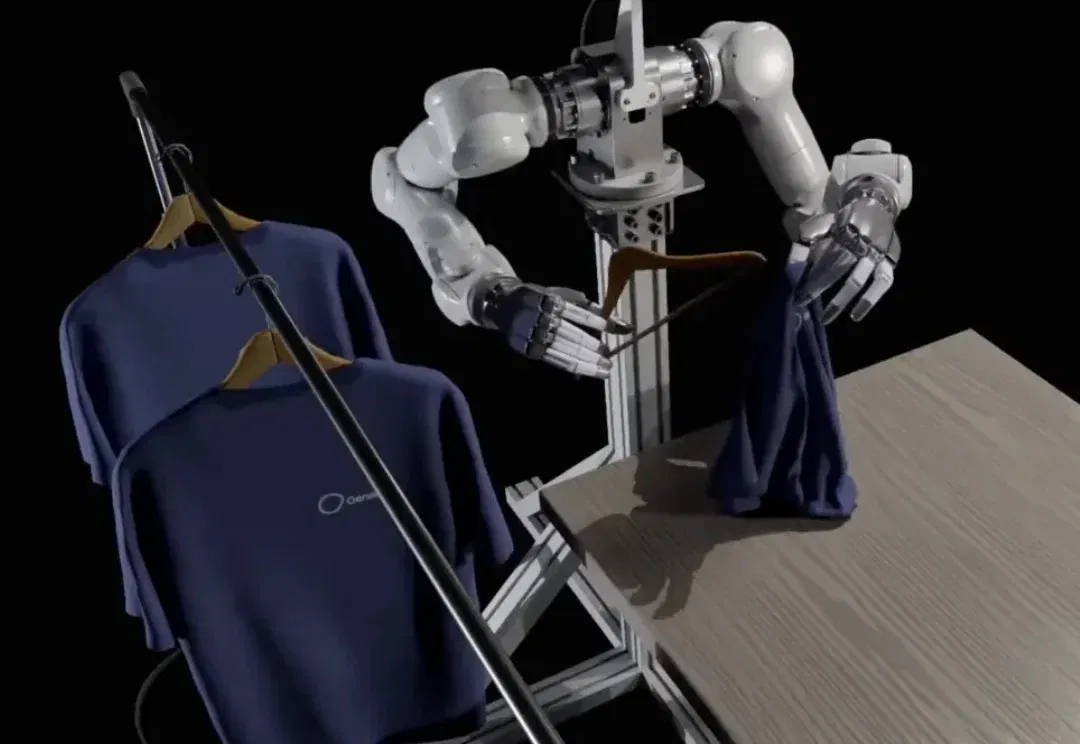
让机器人学会番茄炒蛋爆红网络的 Genesis AI,开源了自己的机器人「训练场」(在新窗口打开)
真实世界需要 200 多个小时的模型评测任务,可以在仿真中不到 0.5 小时内完成。
共 8436 篇
真实世界需要 200 多个小时的模型评测任务,可以在仿真中不到 0.5 小时内完成。
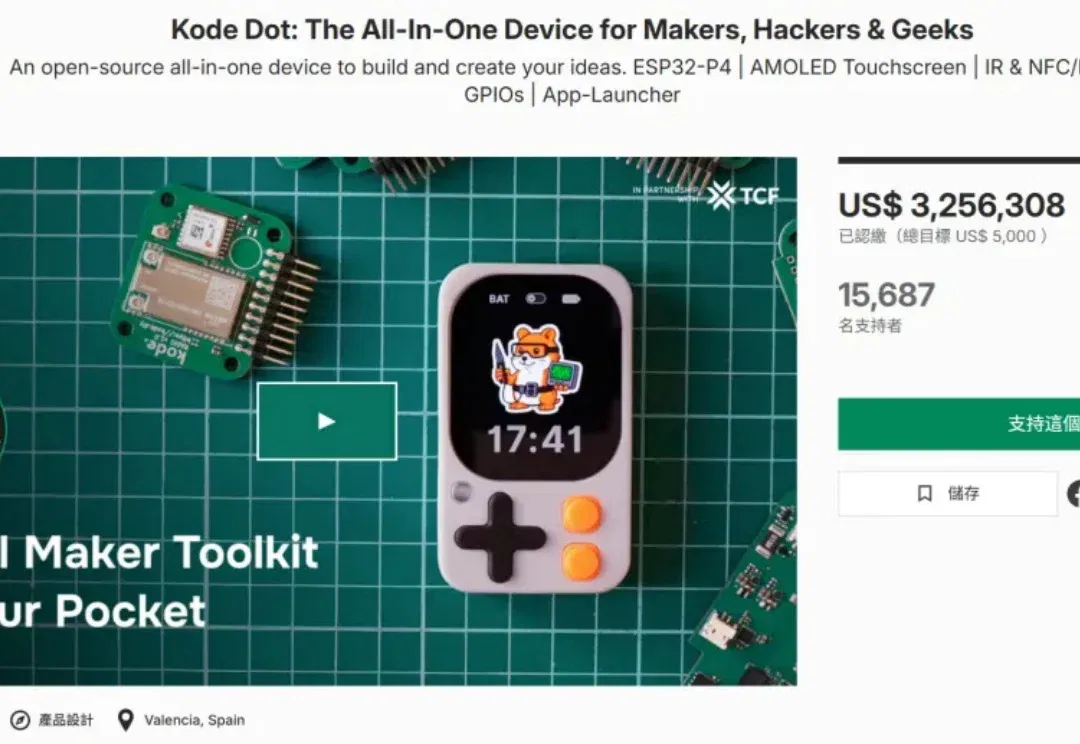
这原本是一个看起来“毫无胜算”的众筹项目。
GPT-5.5 把进攻性网络安全最难的 7 个基准全部打穿,92.4% 正确率,评估体系直接失灵。AI 黑客能力每 6 个月翻一倍,而衡量它有多危险的尺子,已经先被干碎了。
ElevenLabs的声音克隆和长文本音频生成质量确实很好,但也太贵了。
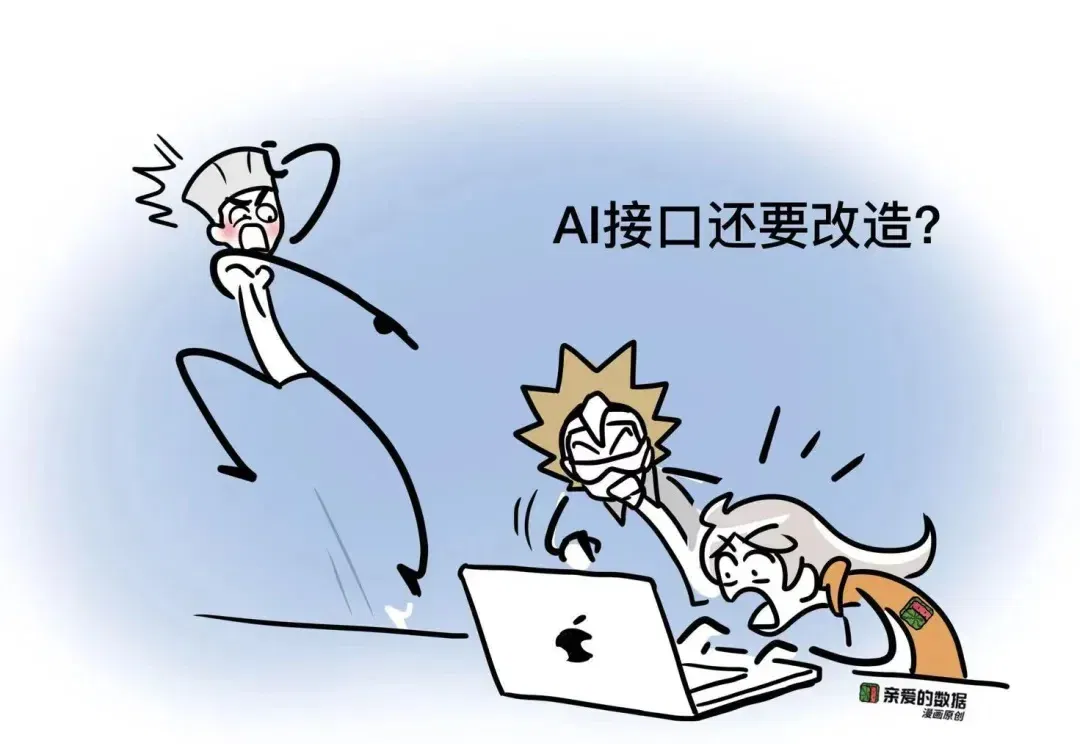
前不久,和两个央企管理层吃晚饭, 一个集团行政管理,一个科技子公司CTO。 小海鲜很有滋味,聊得也挺有意思。 一场听下来,感慨大企业内部真复杂。 有一个小细节,我印象特别深。 那个做行政管理的哥们,突然很认真地问CTO: “我们全集团现在到底有几个模型平台? 我看到是两个?为什么是两个?” CTO愣了一下,也没打官腔,直接说了一句: “跟你说实话,我也不知道。” 桌上一下子就安静了一秒。 然后大家一起大笑出来。 是有笑点,但那个笑,更多是一种—— 你懂的,那种有点无奈的笑。 这就是中国大企业上AI的真实现场。 不是技术问题,是组织问题。 模型再强,也要落地组织里。 从去年到今年,新需求很明显:
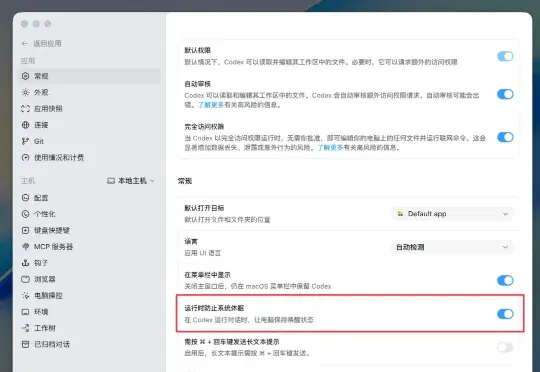
OpenAI 公开介绍 Computer-Using Agent 时,讲的也是这个方向:模型针对图形界面交互做过训练,能把屏幕理解、任务目标和鼠标键盘动作接起来。鼠标会动只是表面。遇到按钮位置变化、弹窗多一层、页面慢一点时,它还能重新看屏幕,继续判断下一步。
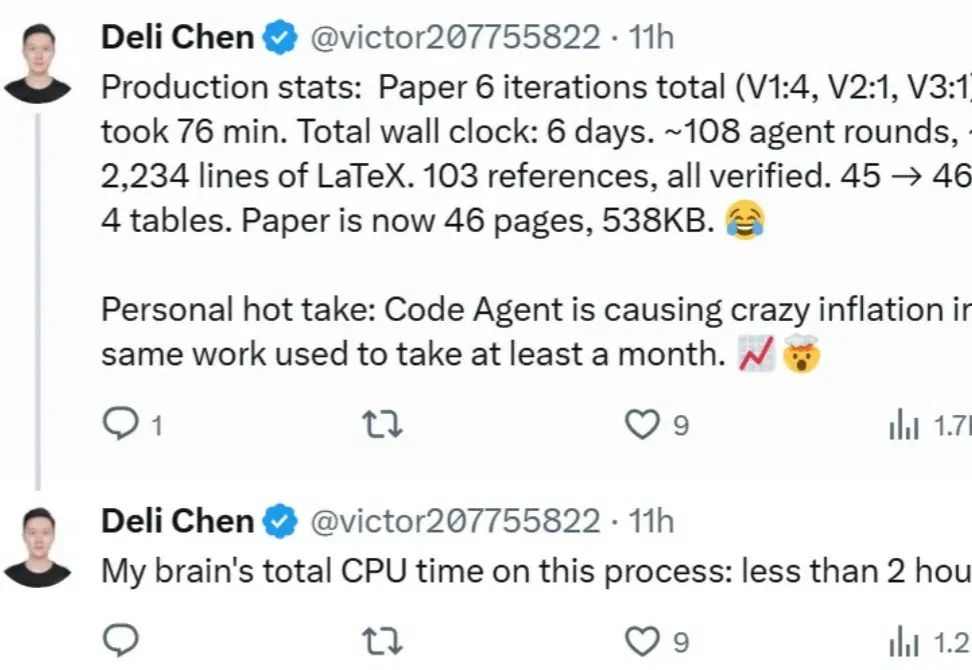
「借助 CodeAgent,我终于可以重新捡起很多过去因为精力不足而搁置的事情了,写博客就是其中之一。这篇博客大概 1% 是我写的,99% 是 Agent 写的 😂」。
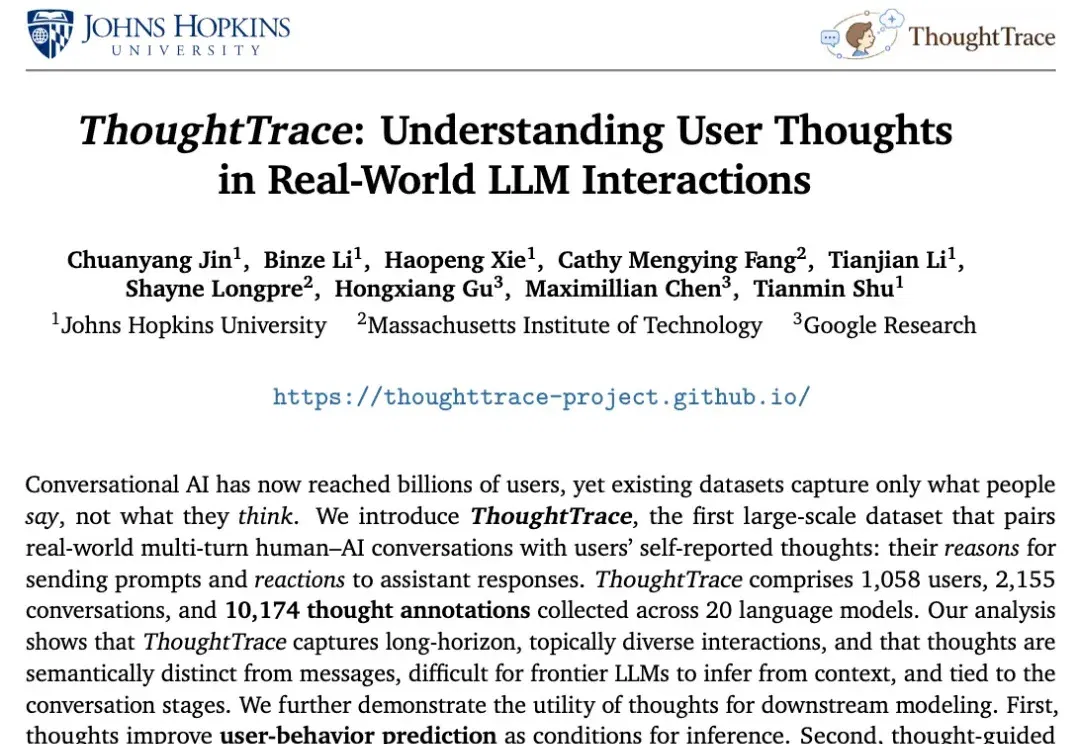
当对话型 AI 服务于数十亿用户时,我们能否看见用户没说出口的那一层?JHU、MIT 和 Google Research 给出了新的解法。
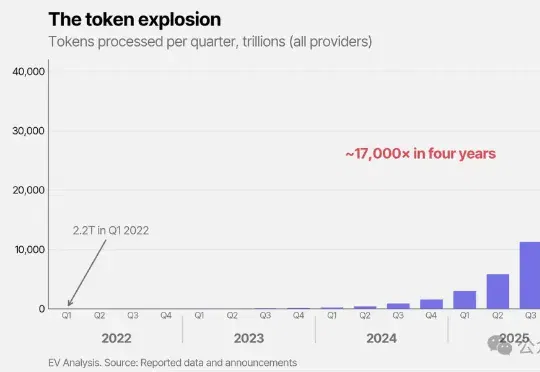
Epoch AI刚刚发布的《梯度更新》报告,做了一件简单粗暴的事:把全球所有Blackwell芯片能处理的Token数量算出来,再和实际需求一比。结论只有一个字——不够。
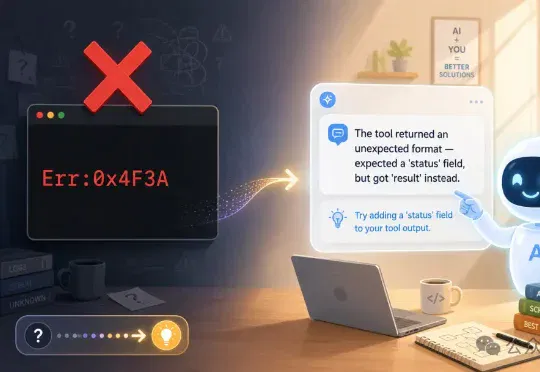
刚刚,Claude Code迎来史上最大规模底层升级!Anthropic直击开发者最痛的6大顽疾:终端闪烁、思考假死、玄学报错、上下文死锁、连接不稳、会话崩溃。一夜之间,AI编程工具从「聪明外挂」进化为「可靠伙伴」。