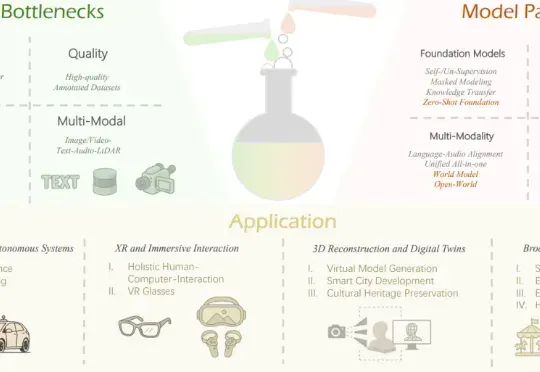
Insta360最新全景综述:全景视觉的挑战、方法与未来(在新窗口打开)
本文作者团队来自 Insta360 影石研究院及其合作高校。目前,Insta360 正在面向世界模型、多模态大模型、生成式模型等前沿方向招聘实习生与全职算法工程师,欢迎有志于前沿 AI 研究与落地的同
共 1519 篇
本文作者团队来自 Insta360 影石研究院及其合作高校。目前,Insta360 正在面向世界模型、多模态大模型、生成式模型等前沿方向招聘实习生与全职算法工程师,欢迎有志于前沿 AI 研究与落地的同
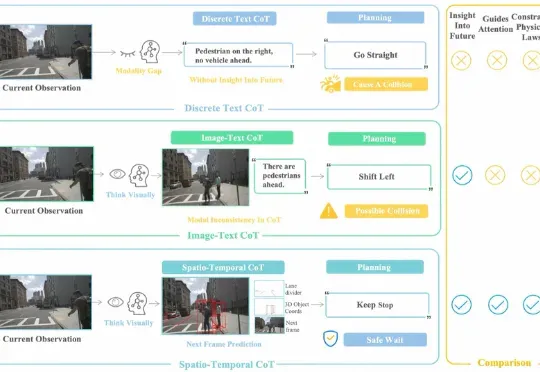
面向自动驾驶的多模态大模型在 “推理链” 上多以文字或符号为中介,易造成空间 - 时间关系模糊与细粒度信息丢失。FSDrive(FutureSightDrive)提出 “时空视觉 CoT”(Spatio-Temporal Chain-of-Thought),让模型直接 “以图思考”,用统一的未来图像帧作为中间推理步骤,联合未来场景与感知结果进行可视化推理。
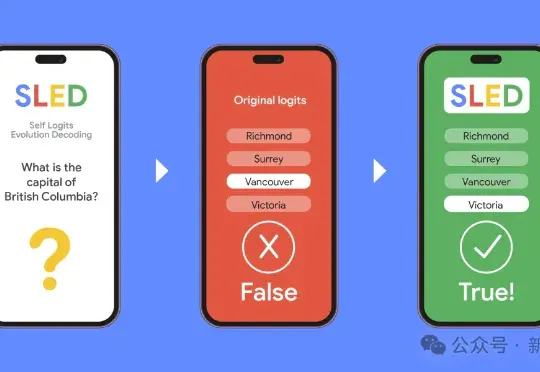
大模型最让人头疼的毛病,就是一本正经地「瞎编」。过去,只能靠检索补丁或额外训练来修。可在NeurIPS 2024 上,谷歌抛出的新方法SLED却告诉我们:模型其实知道,只是最后一步忘了。如果把每一层的「声音」都纳入考量,它就能从幻觉中被拉回到事实。
昨天,深度求索刚刚开源 DeepSeek-V3.2-Exp。今天,另一国产大模型之光智谱 AI 也正式发布了旗下新一代旗舰模型 GLM-4.6,刚好撞车 Claude Sonnet 4.5。但有一点不同,智谱的 GLM-4.6 会继续开源,它即将上线 Hugging Face、ModelScope 等平台,遵循 MIT 协议。
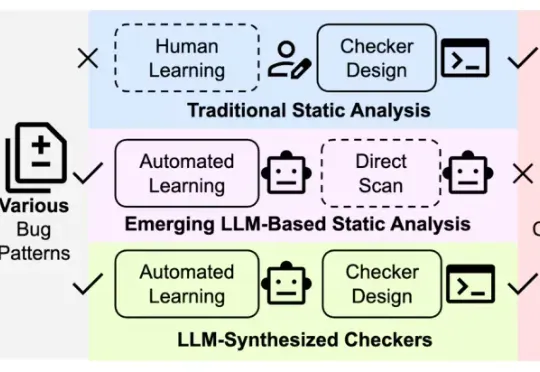
最近的报道指出,OpenAI 的 o3 模型已经在 Linux 内核中发现了一个零日漏洞;而本文的 KNighter 更进一步,通过自动生成静态分析检查器,把模型的洞察沉淀为工程可用、用户可见的逻辑规则,实现了规模化的软件漏铜、缺陷挖掘。
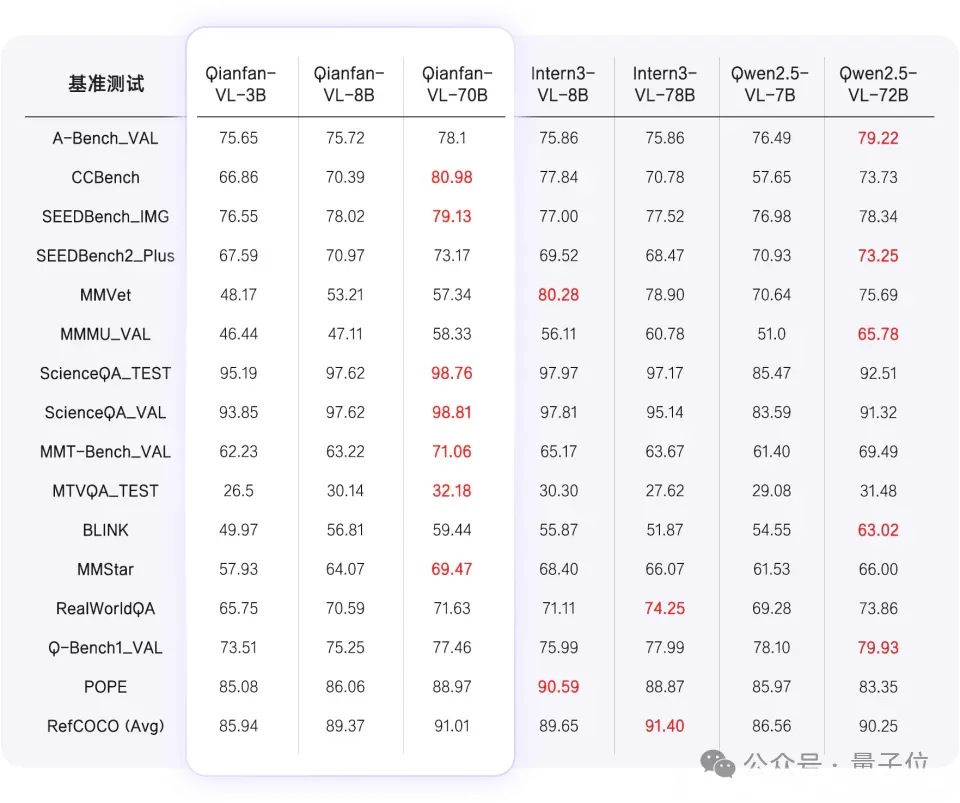
今天,百度智能云千帆正式推出全新视觉理解模型——Qianfan-VL,并全面开源!该系列包含3B、8B和70B三个尺寸版本,是面向企业级多模态应用场景,进行了深度优化的视觉理解大模型。
智东西9月15日报道,今天,阿里巴巴通义实验室推出了FunAudio-ASR端到端语音识别大模型。这款模型通过创新的Context模块,针对性优化了“幻觉”、“串语种”等关键问题,在高噪声的场景下,幻觉率从78.5%下降至10.7%,下降幅度接近70%。
北京深度逻辑智能科技有限公司推出了 LLaSO—— 首个完全开放、端到端的语音语言模型研究框架。LLaSO 旨在为整个社区提供一个统一、透明且可复现的基础设施,其贡献是 “全家桶” 式的,包含了一整套开源的数据、基准和模型,希望以此加速 LSLM 领域的社区驱动式创新。
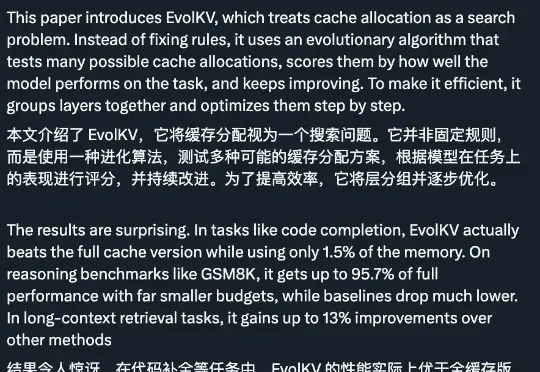
只用 1.5% 的内存预算,性能就能超越使用完整 KV cache 的模型,这意味着大语言模型的推理成本可以大幅降低。EvolKV 的这一突破为实际部署中的内存优化提供了全新思路。
机器具备意识吗?本文对AI意识(AI consciousness)进行了考察,特别是深入探讨了大语言模型作为高级计算模型实例是否具备意识,以及AI意识的必要和充分条件。