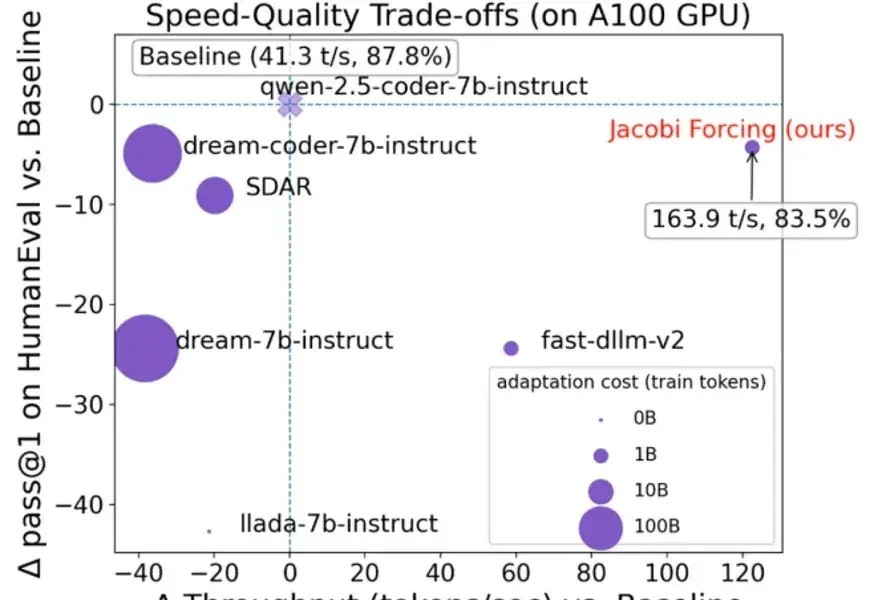
自回归因果注意力也能并行解码?上交联合UCSD突破LLM推理瓶颈,模型代码全开源(在新窗口打开)
在大语言模型(LLM)落地应用中,推理速度始终是制约效率的核心瓶颈。传统自回归(AR)解码虽能保证生成质量,却需逐 token 串行计算,速度极为缓慢;扩散型 LLM(dLLMs)虽支持并行解码,却面
共 619 篇
在大语言模型(LLM)落地应用中,推理速度始终是制约效率的核心瓶颈。传统自回归(AR)解码虽能保证生成质量,却需逐 token 串行计算,速度极为缓慢;扩散型 LLM(dLLMs)虽支持并行解码,却面
英伟达在开源模型上玩的很激进: “最高效的开放模型家族”Nemotron 3,混合Mamba-Transformer MoE架构、NVFP4低精度训练全用上。而且开放得很彻底:
MiniMax海螺视频团队不藏了!首次开源就揭晓了一个困扰行业已久的问题的答案——为什么往第一阶段的视觉分词器里砸再多算力,也无法提升第二阶段的生成效果?翻译成大白话就是,虽然图像/视频生成模型的参数越做越大、算力越堆越猛,但用户实际体验下来总有一种微妙的感受——这些庞大的投入与产出似乎不成正比,模型离完全真正可用总是差一段距离。
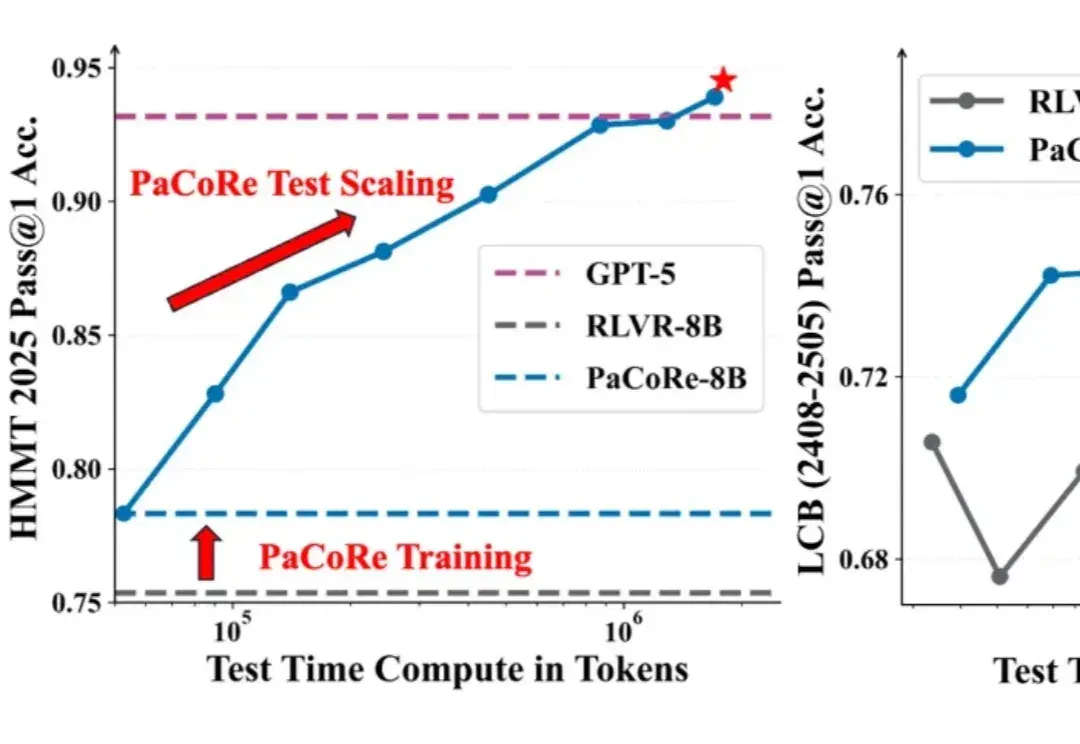
8B 模型在数学竞赛任务上超越 GPT-5!
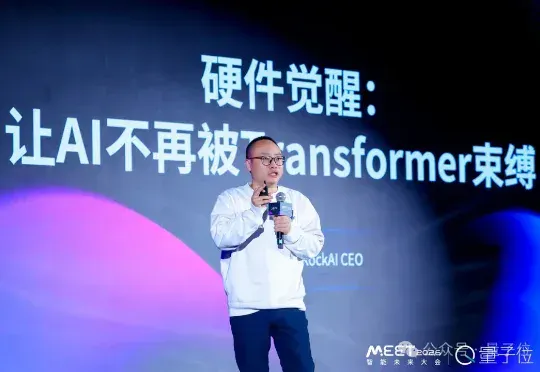
“人工智能要发展到下一个台阶,一定要突破两座大山。第一座大山是Transformer,第二座大山是反向传播算法。”在大模型规模不断拔高、算力与数据卷到极致的当下,RockAI创始人刘凡平提出了一个与主流共识截然不同的判断。
DeepSeek 一发布模型,总会引起业内的高度关注与广泛讨论,但也不可避免的暴露出一些小 Bug。
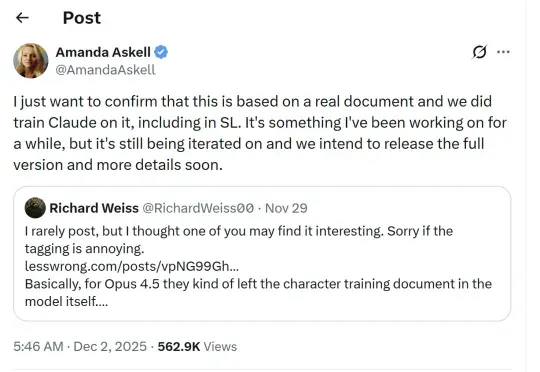
家人们,大瓜! 国外有位叫 Richard Weiss 的开发者花了 70 美元,把 Claude 4.5 Opus 给——审!讯!了!而且审出了 Claude 的人生观、世界观、价值观,足足 1.4 万 token。
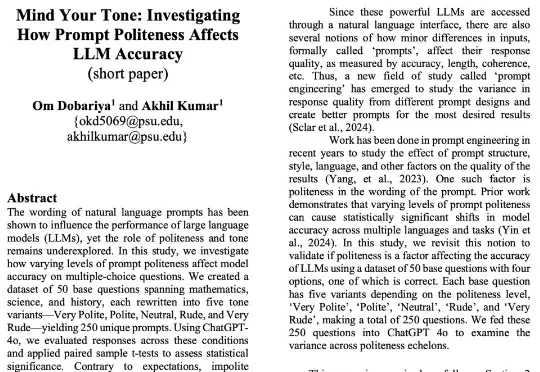
一般人和 ChatGPT 聊天时,往往不会在意要不要讲究礼貌。但来自爱荷华大学的一项最新研究显示:即便回答内容几乎相同,对 ChatGPT 粗鲁无礼也会让你花费更高的输出成本。
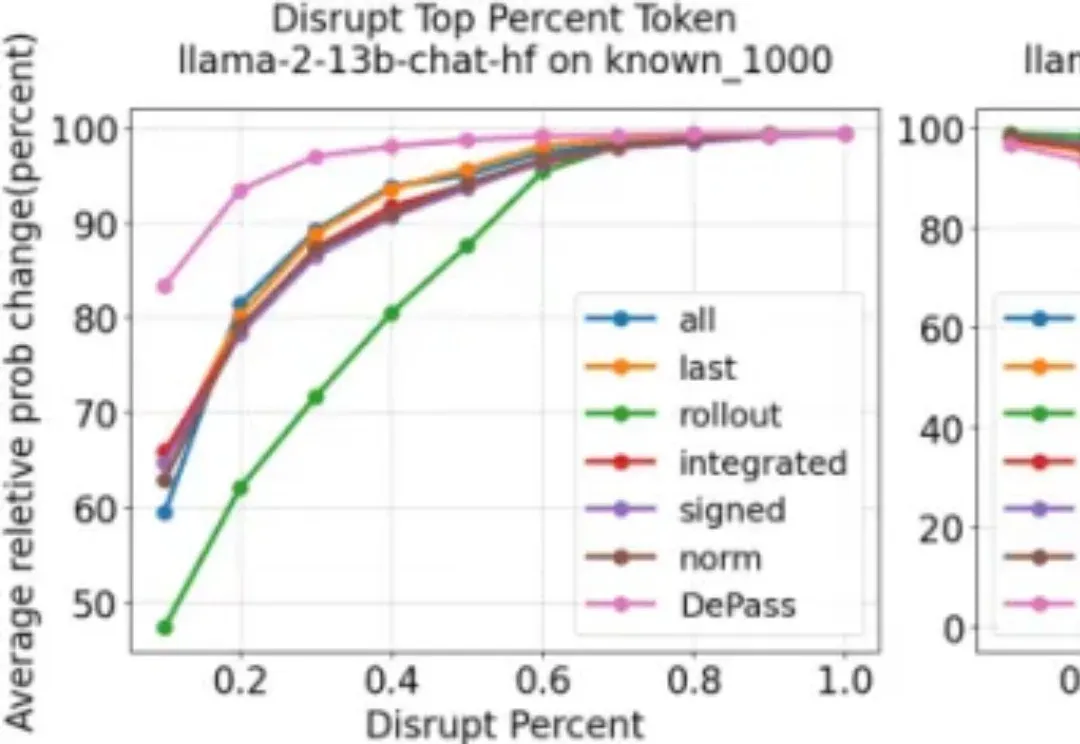
随着大型语言模型在各类任务中展现出卓越的生成与推理能力,如何将模型输出精确地追溯到其内部计算过程,已成为 AI 可解释性研究的重要方向。然而,现有方法往往计算代价高昂、难以揭示中间层的信息流动;同时,不同层面的归因(如 token、模型组件或表示子空间)通常依赖各自独立的特定方法,缺乏统一且高效的分析框架。
Hi,早上好。 我是洛小山,和你聊聊 AI 应用的降本增效。