突然袭击!刚刚,Meta超级智能团队首个大模型 Muse Spark 来了(在新窗口打开)
刚刚,Meta 重金组建的超级智能实验室(SML)交卷!这也是年轻华人 Alexandr Wang 带领该团队后,交出的首份成绩。全新自研模型 Muse Spark 上线。
共 254 篇
刚刚,Meta 重金组建的超级智能实验室(SML)交卷!这也是年轻华人 Alexandr Wang 带领该团队后,交出的首份成绩。全新自研模型 Muse Spark 上线。
半年前我对MuleRun的结论是,阿里老哥拿出了看家的电商心法,要做AI淘宝,供给侧改革,思路典中典。那篇文章最后一句话是等大来——你去喝两瓶假酒一觉睡到明年什么都没错过。
近期,大连理工与快手可灵团队推出了 MultiShotMaster—— 一个高度可控的多镜头视频生成框架,该论文向研究社区展示了即使在 1B 左右的小参数量级模型上,也可以实现导演级的镜头调度和连贯叙事,且支持多图参考、主体运动控制。
上午十点,我在飞书上给 AI 助手发了一条消息,让它帮我盯盘,然后我就去上班了。过了两个小时,手机震了一下。我打开一看,是 memU Bot 发来的简报。比特币价格 $78705,24 小时涨跌 1.99%。
今天,我们正式发布 MiniMax Music 2.5:全维度突破,指挥细节,定义真实。AI 音乐始终面对两个挑战:可控性与真实度。前者决定了创作者能否表达真实意图,后者决定了作品是否具备专业质感。
大家都知道 Elon Musk 最近和 OpenAI 在硅谷法庭上,「打得火热」,算是「一团和气」。前两天,OpenAI 的总裁 Greg Brockman 终于坐不住了。他直接发推 Diss Elon Musk,指责他为了打官司,竟然断章取义地把自己私人日记里的片段当成证据 😆。
文本领域的大模型满分选手,换成语音就集体挂科?大模型引以为傲的多轮对话逻辑,在真实人声面前竟然如此脆弱。Scale AI正式发布首个原生音频多轮对话基准Audio MultiChallenge,直接撕开了大模型靠合成语音评测维持的优等生假象。实验显示,强如Gemini 3 Pro在真实场景下的通过率也仅过半数,而GPT-4o Audio的表现更是令人大跌眼镜。
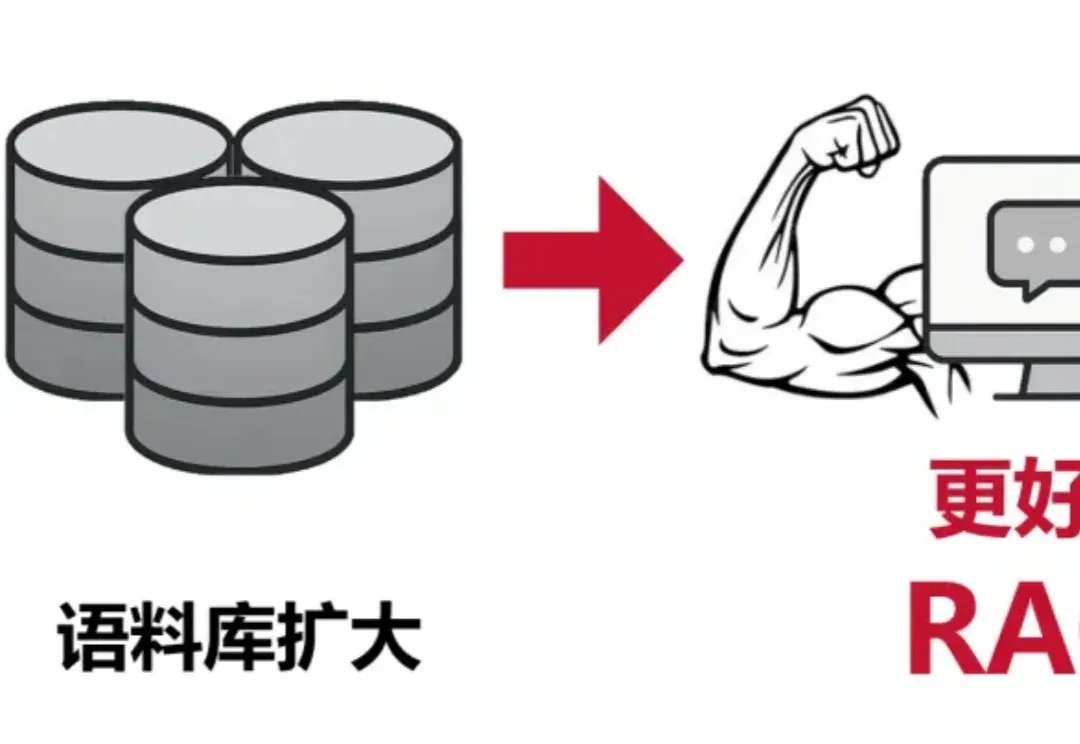
在检索增强生成中,扩大生成模型规模往往能提升准确率,但也会显著抬高推理成本与部署门槛。CMU 团队在固定提示模板、上下文组织方式与证据预算,并保持检索与解码设置不变的前提下,系统比较了生成模型规模与检索语料规模的联合效应,发现扩充检索语料能够稳定增强 RAG,并在多项开放域问答基准上让小中型模型在更大语料下达到甚至超过更大模型在较小语料下的表现,同时在更高语料规模处呈现清晰的边际收益递减。
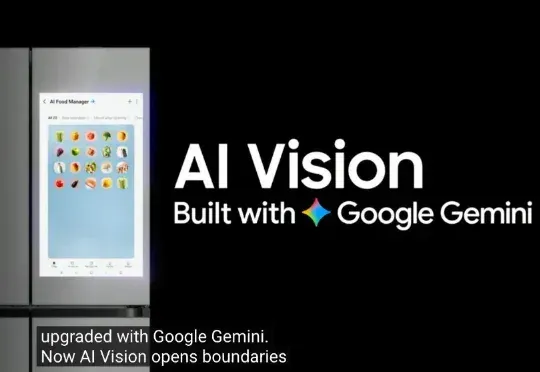
今日,三星在CES 2026“First Look”活动上发布了AI家居“全家桶”,三星将其比喻为“AI生活伴侣”,分为娱乐伴侣、家庭伴侣、健康伴侣三部分。娱乐伴侣方面,三星发布了130英寸Micro RGB电视、电视AI技术Vision AI Companion(VAC)、wifi音响Music Studio 5和Music Studio 7
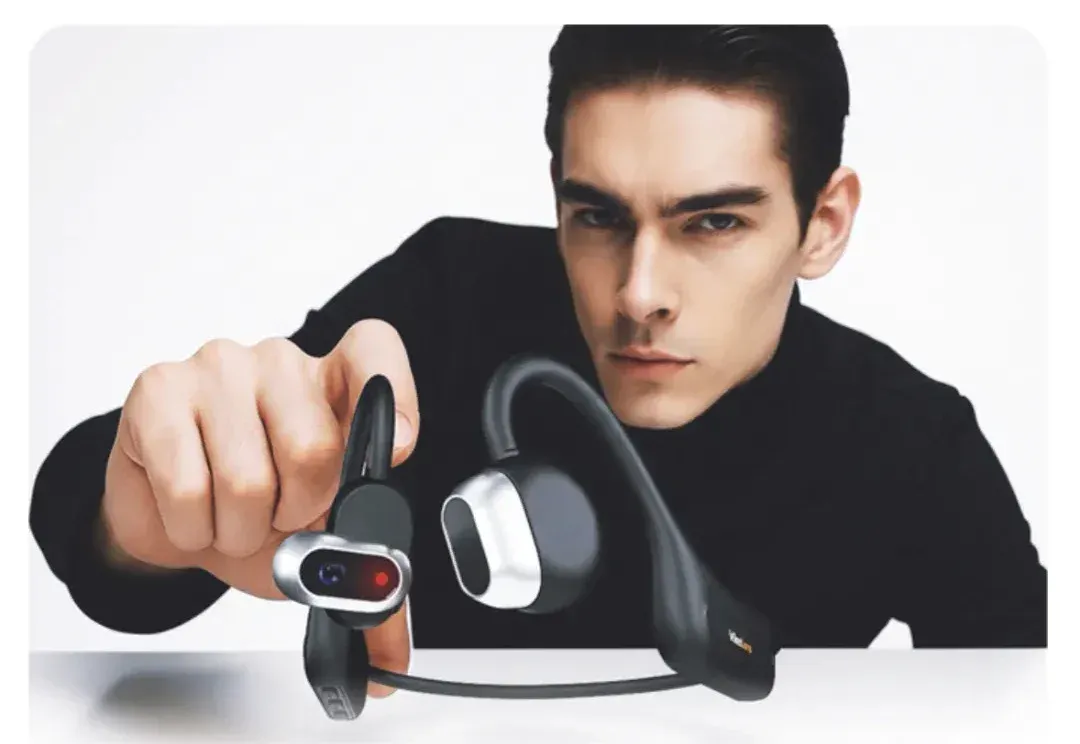
面对「9 块 9 包邮」的耳机内卷,传统制造商何卫自投 1000 多万 All-in 新品 MusicCam。他坚信,只有通过重投入、差异化和清晰的海外布局,才能摆脱「乙方」的命运,重新夺回市场主动权。