并行扩散架构突破极限,实现5分钟AI视频生成,「叫板」OpenAI与谷歌?(在新窗口打开)
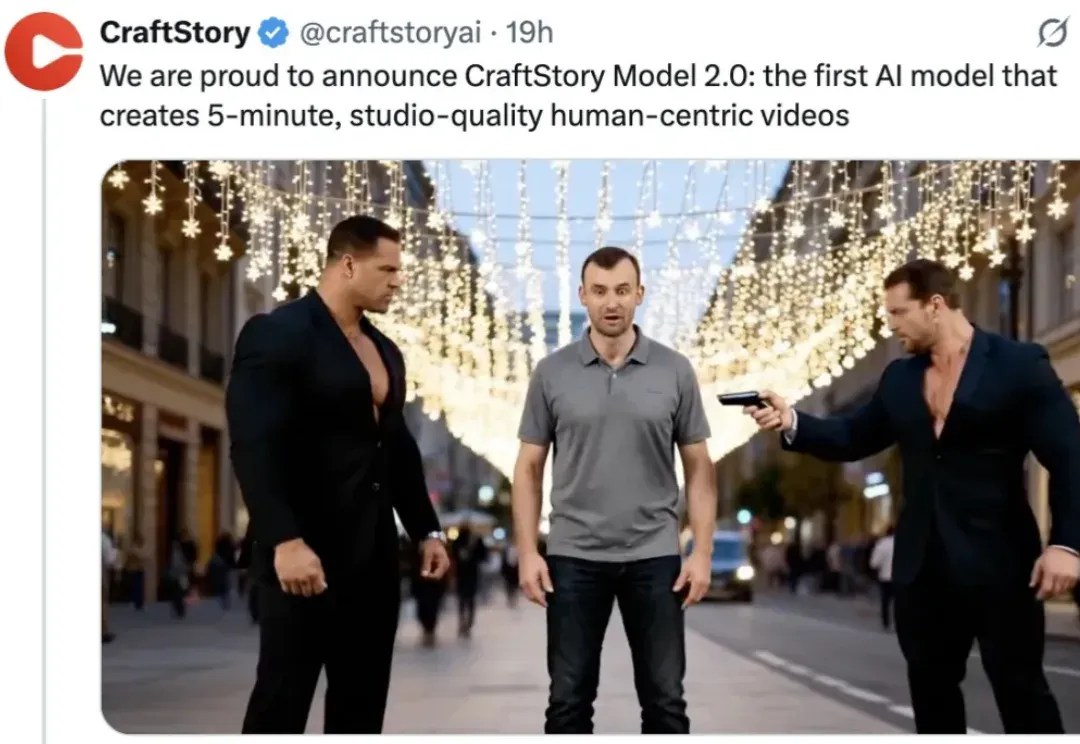
近日,一家名为 CraftStory 的 AI 初创公司推出了 Model 2.0 视频生成系统,凭借可生成长达五分钟的富有表现力、可媲美专业水准、以人为中心的视频,破解了困扰 AI 视频生成行业长久以来的「视频时长」难题,引起热议,并被视为或将是 OpenAI 的 Sora 和 Google 的 Veo 的强有力竞争者。
共 103 篇
近日,一家名为 CraftStory 的 AI 初创公司推出了 Model 2.0 视频生成系统,凭借可生成长达五分钟的富有表现力、可媲美专业水准、以人为中心的视频,破解了困扰 AI 视频生成行业长久以来的「视频时长」难题,引起热议,并被视为或将是 OpenAI 的 Sora 和 Google 的 Veo 的强有力竞争者。
世界模型(World Model),正在成为AI领域新的技术高地。从OpenAI的Sora,到图灵奖得主Yann LeCun力推的JEPA体系,再到李飞飞创办的World Labs,全球最顶尖的一批研究者都在试图回答同一个问题:AI究竟如何像人一样理解世界,而不仅仅是生成语言和图像。
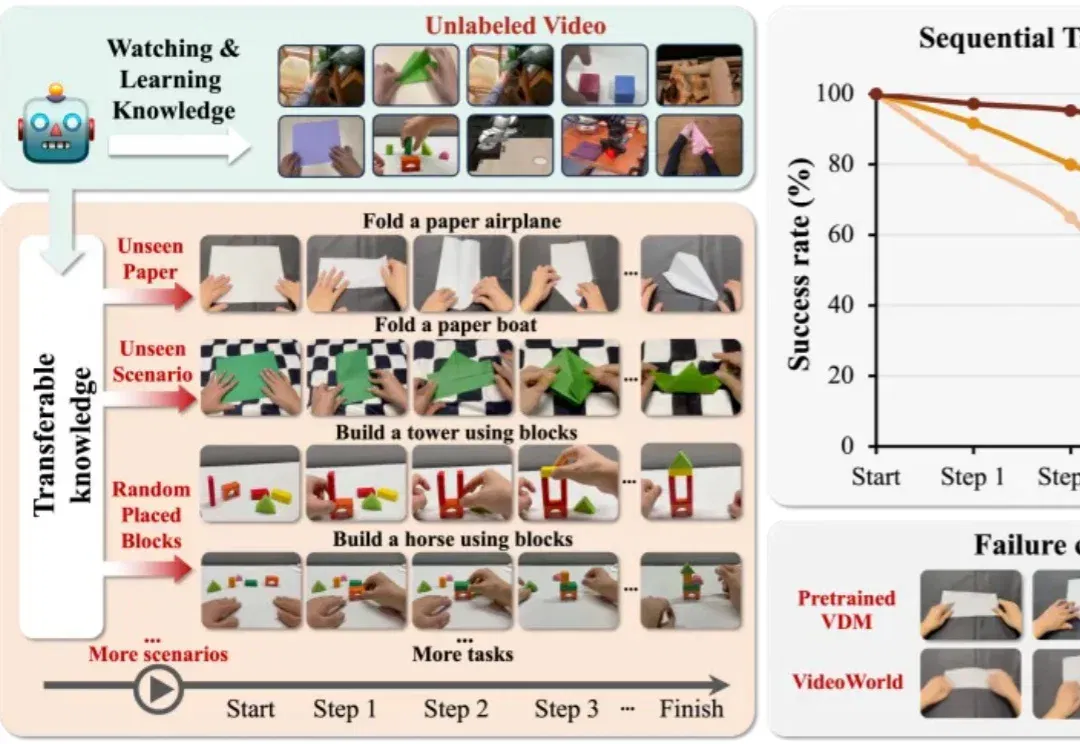
视觉世界模型 “VideoWorld 2” 由豆包大模型团队与北京交通大学联合提出。不同于 Sora 2 、Veo 3、Wan 2.2 等主流多模态模型,VideoWorld 系列工作在业界首次实现无需依赖语言模型,即可认知世界。
自 Sora 亮相以来,AI 视频的真实感突飞猛进,但可控性仍是瓶颈:模型像才华横溢却随性的摄影师,难以精准执行 “导演指令”。我们能否让 AI 做到: 仅凭一张静态照片,就能 “脑补” 出整个 3D
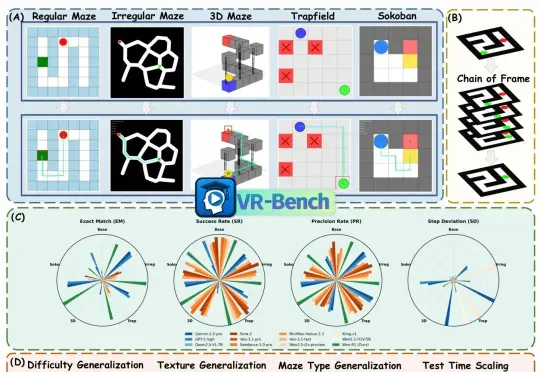
DeepWisdom研究团队提出:视频生成模型不仅能画画,更能推理。 为了验证这一观点,团队推出了VR-Bench——这是首个通过迷宫任务评估视频模型空间推理(spatial reasoning)能力的基准测试
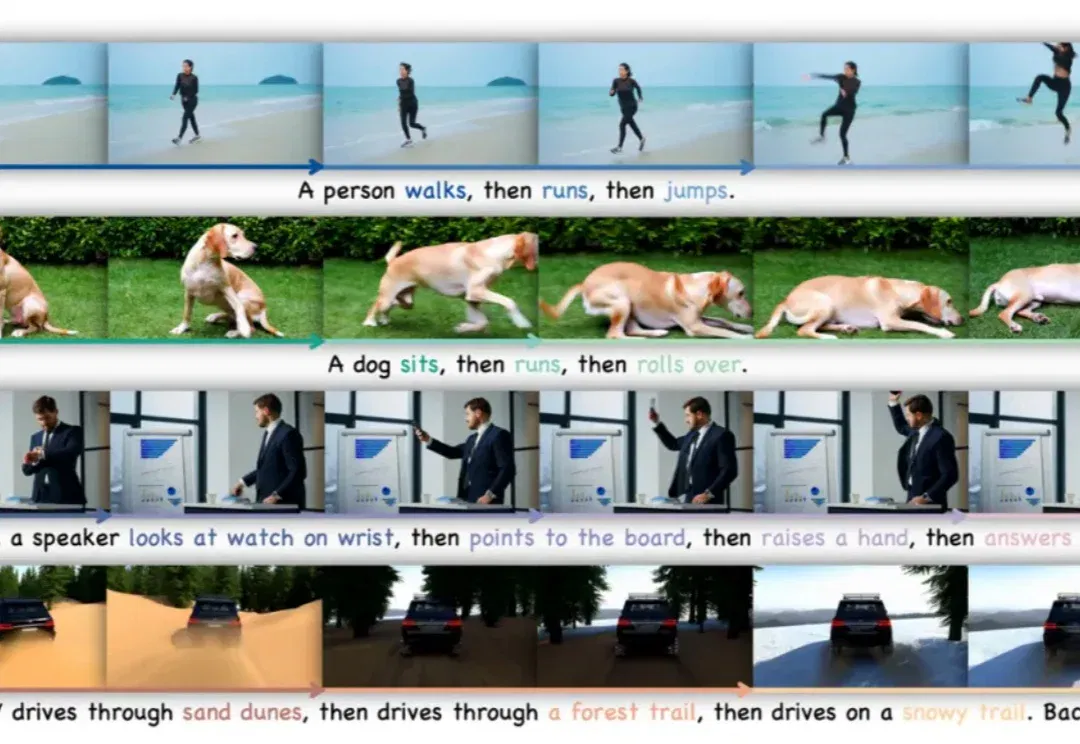
近年来,随着 Sora、Seedance 等文本到视频(T2V)扩散模型的飞速发展,AI 视频生成在视觉保真度与动态表现上已取得突破性进展。特别是近期备受瞩目的 Seedance 2.0,展现出了极其强大的多镜头叙事与复杂分镜控制能力。
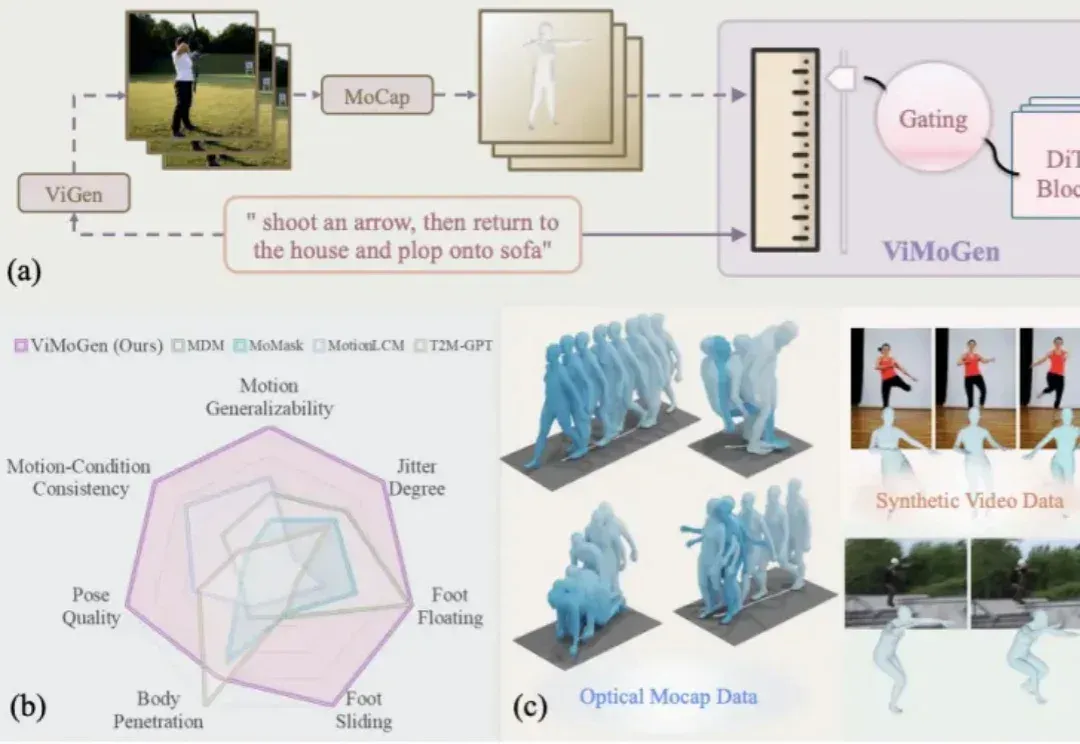
随着 AIGC(Artificial Intelligence Generated Content) 的爆发,我们已经习惯了像 Sora 或 Wan 这样的视频生成模型能够理解「一只宇航员在火星后空翻」这样天马行空的指令。然而,3D 人体动作生成(3D MoGen)领域却稍显滞后。
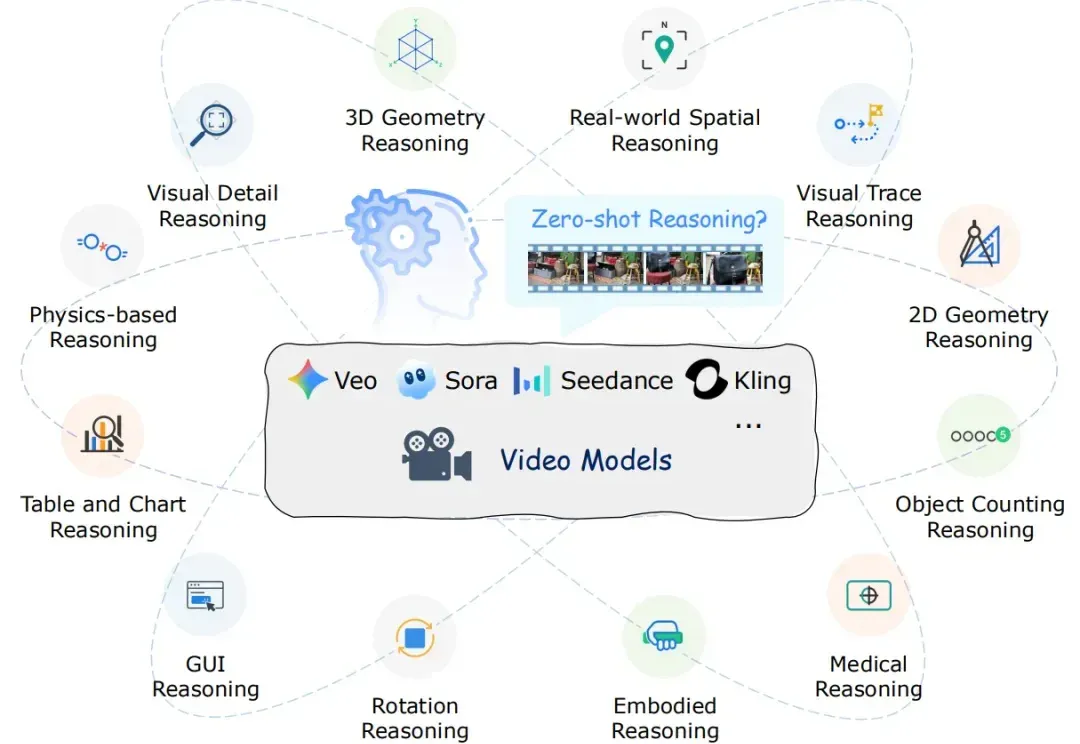
近年来,以 Veo、Sora 为代表的视频生成模型展现出惊人的合成能力,能够生成高度逼真且时序连贯的动态画面。这类模型在视觉内容生成上的进步,表明其内部可能隐含了对世界结构与规律的理解。更令人关注的是,Google 的最新研究指出,诸如 Veo 3 等模型正在逐步显现出超越单纯合成的 “涌现特性”,包括感知、建模和推理等更高层次能力。
奇点已至! 在最新长谈,奥特曼十年后重新复盘创业方法论,罕见认怂:Codex当年真打不过Claude Code,靠敢死队式冲刺绝地翻盘。 当时,Codex已落后于Claude Code,但OpenAI仍押上资源猛追,如今Codex已是他口中「大多数最优秀程序员在用」的工具。为达目的,OpenAI甚至砍掉了投入巨大的Sora与浏览器项目。 但引起全网热议的是,奥特曼的最新判断: 我们现在正处于奇点之中,这正是那一刻。 「奇点已至」,不止奥特曼!全网热议 在Ti Morse访谈中,奥特曼直言: 最能激励我的是,我能想象到的最有趣、最重要的事情就是我们现在正在做的。 我们现在正处于奇点——就是这一刻
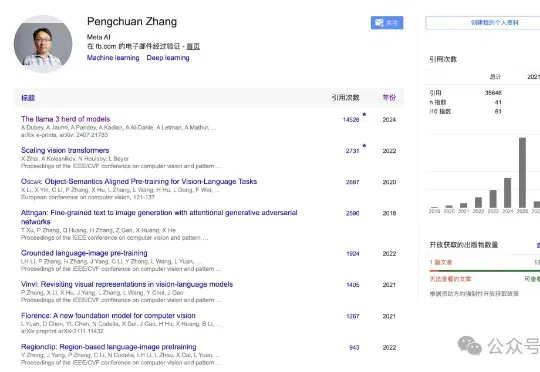
刚刚,毕业清华大学数学系,曾在Meta FAIR工作3.75年、主导过SAM与Llama多项核心工作的研究员张鹏川(Pengchuan Zhang)宣布离职。他的下一站,是来到OpenAI,投身于世界模拟与机器人学(World Simulation and Robotics)方向的研究。