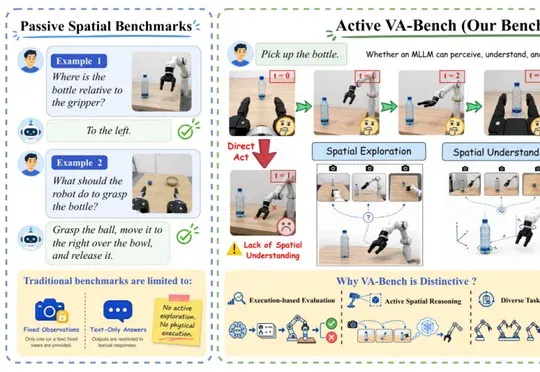
看懂不等于做对:VA-Bench测出大模型空间智能的执行断层(在新窗口打开)
VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
共 106 篇
VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
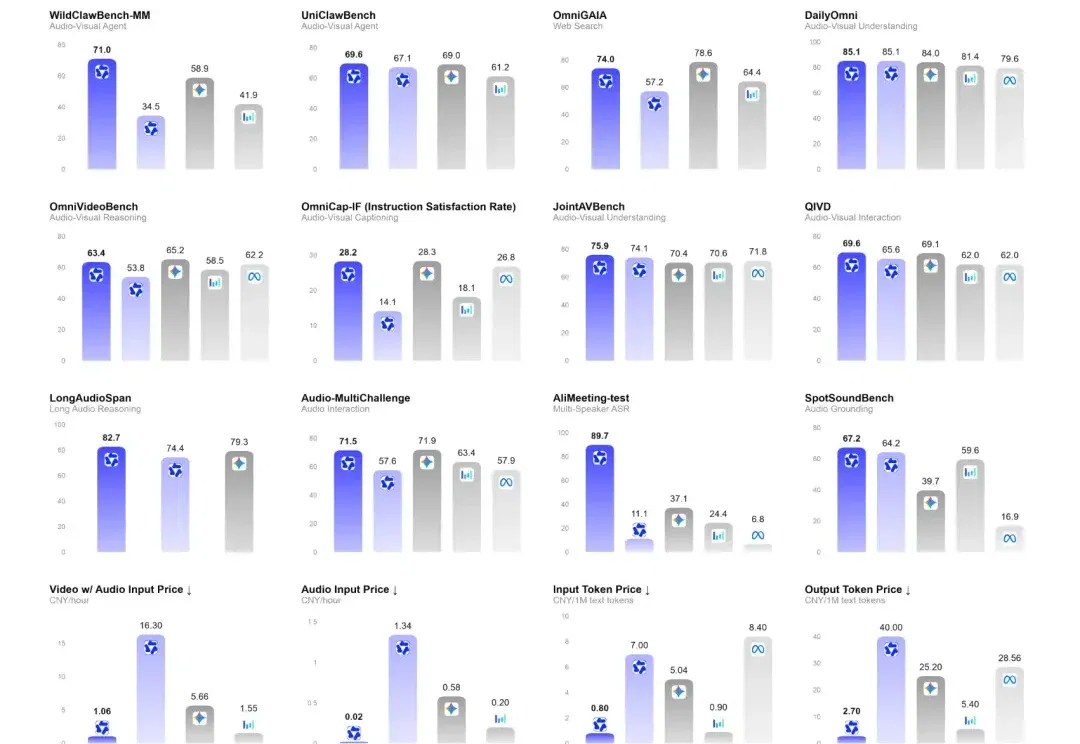
千问把全模态Agent的使用成本,直接砍掉了90%!
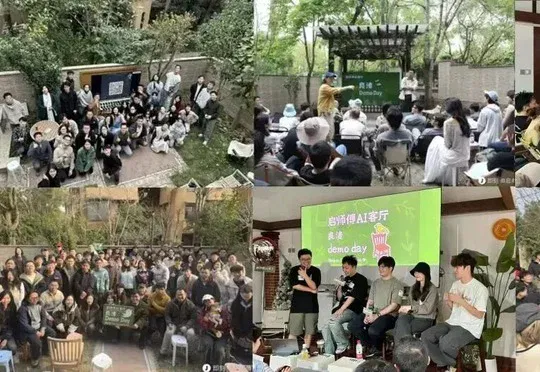
杭州自9月20日起向35家市级大学生创业园每人发放一张含1万积分的千问办公token卡,这是千问办公接入Qwen3.8-Max一个月后杭州首次将算力帮扶平铺到个人,标志着其AI产业思路从支持做模型的企业转变为支持用模型的人。
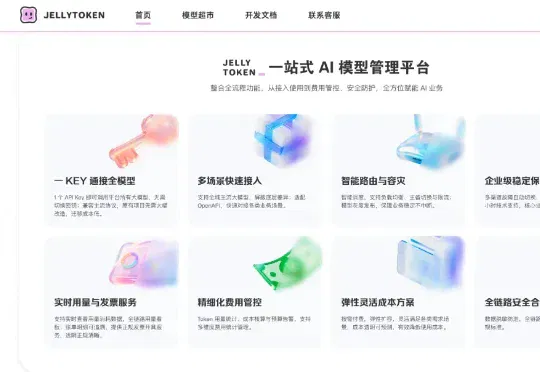
由阿里巴巴集团孵化的空间智能企业“元境”,正在内测“JellyToken”,平台定位AI大模型一站式超市,支持一套密钥调用多款模型。该平台整合了Qwen3.7、Seedance2.0等多款国产大模型,面向个人创作者、中小团队、企业推出付费统一调用服务。
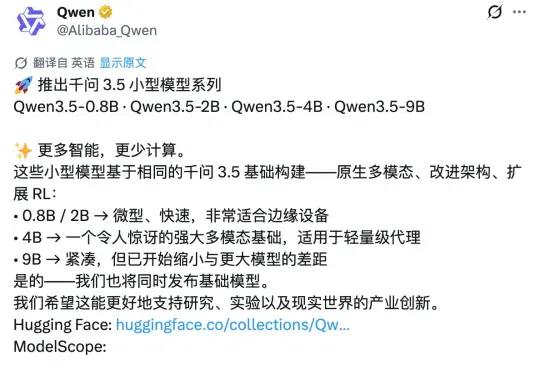
昨天深夜,阿里通义千问团队在 X 平台正式发布了 Qwen3.5 小模型系列,覆盖 0.8B、2B、4B 和 9B 四个参数规格。甫一发布,便在海外科技圈引发强烈反响。马斯克也在该推文下评论称:「Impressive intelligence density」(令人印象深刻的智能密度)。这股热度的背后,APPSO 也好奇,为什么这几款小模型能够激起如此大的波澜?
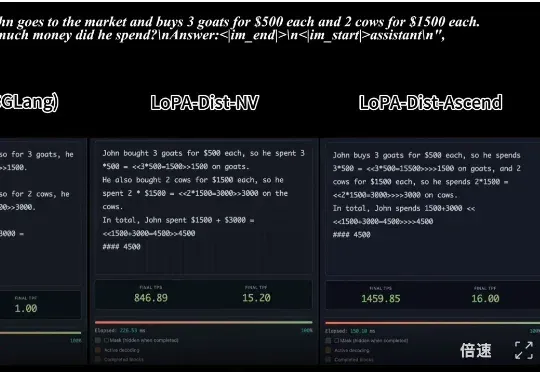
,时长 00:20 视频 1:单样例推理速度对比:SGLang 部署的 Qwen3-8B (NVIDIA) vs. LoPA-Dist 部署 (NVIDIA & Ascend)(注:NVIDIA 平台
当前,AI 领域的研究者与开发者在关注 OpenAI、Google 等领先机构最新进展的同时,也将目光投向了由前 OpenAI CTO Mira Murati 创办的 Thinking Machines Lab。
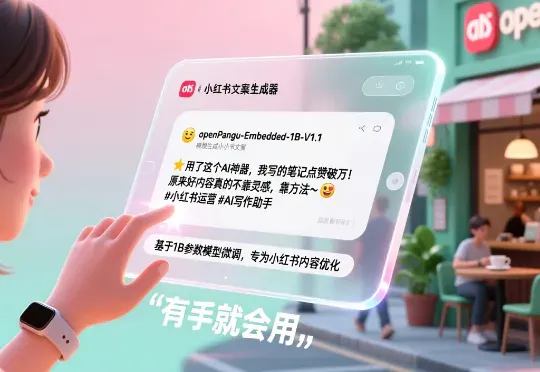
我想聊个反向操作:咱们普通人,如何用有限的资源,轻松驯服一个 AI 模型,让它变成我们专属的垂直领域小能手?主角,就是最近华为刚刚开源的一个大小仅为 1B 的模型 openPangu-Embedded-1B,它不仅全面领先同规格模型,甚至与更大规模的 Qwen3-1.7B 也难分伯仲。
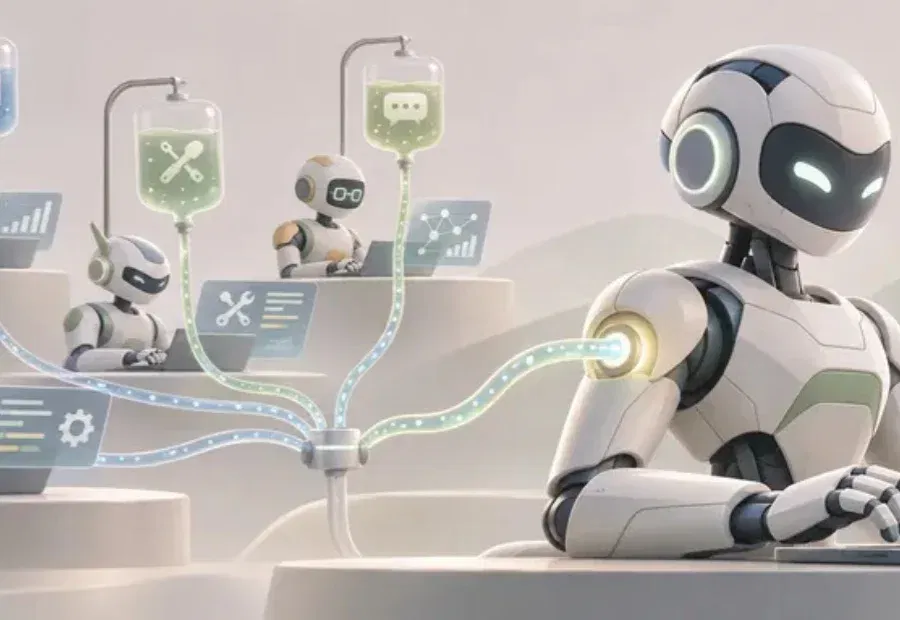
团队以 Qwen3.8-Flash 为基础进行后训练,主模型 1250 亿参数、激活 60 亿。厂商评测中部分 Agent 任务分数提高,计算与数学类别下降,文章也给出四个官方案例。
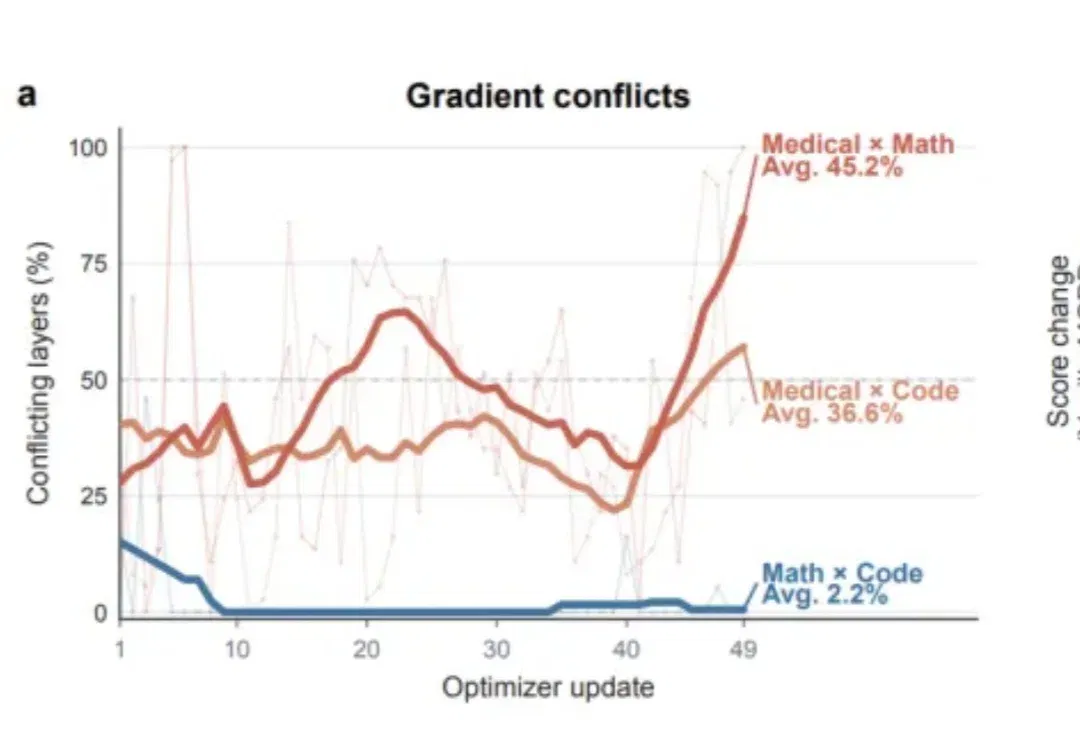
京东与南京大学提出 Road MOPD,在学生的同一份回答上收集多教师反馈,先调整 token 级监督,再削减冲突梯度并保留学习力度。Qwen3-4B 的数学、代码与医学文本基准显示联合训练收益;较小模型的部分领域仍有取舍。