LiberAI完成亿元融资,清华00后特奖入局世界模型(在新窗口打开)
LiberAI已于近期连续完成种子轮、天使轮及天使+轮融资,累计金额数亿元人民币,投资方包括真格基金、红杉中国、美团龙珠、顺为资本等一线机构。公司成立于2025年12月,CEO刘松铭是清华特等奖学金获得者,师从清华大学朱军教授,在ICML、NeurIPS等顶会发表多篇一作论文。
共 86 篇
LiberAI已于近期连续完成种子轮、天使轮及天使+轮融资,累计金额数亿元人民币,投资方包括真格基金、红杉中国、美团龙珠、顺为资本等一线机构。公司成立于2025年12月,CEO刘松铭是清华特等奖学金获得者,师从清华大学朱军教授,在ICML、NeurIPS等顶会发表多篇一作论文。
过去十年,压缩在 CV 学术圈一直是个边缘方向——做生成、做大模型才是显学。但 SparcAI 的两位95后创始人各自做了多年压缩,然后在同一间 NTU 实验室相遇,两年后发布了 Sparc3D。模型 demo 上线当日冲上 HuggingFace Trending 榜首,论文被 NeurIPS 2025 录用。如今他们创办了 SparcAI,目标是一家世界模型公司。
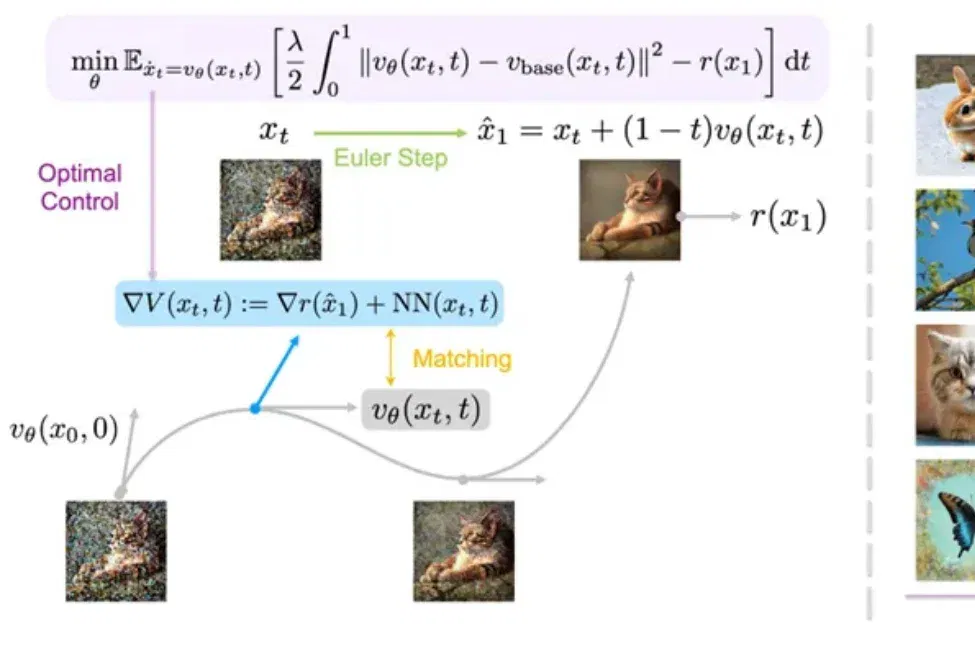
用强化学习微调扩散模型,还有更好的办法吗?
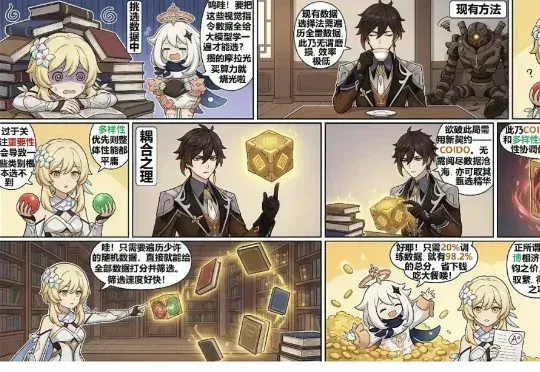
在深入技术细节之前,我们先用一张漫画来直观理解 COIDO (Coupled Importance-Diversity Optimization) 解决的核心问题与方案:正如钟离在漫画中所言,面对海量视觉指令数据的选择任务,传统方法需要遍历全部数据才能进行筛选造成大量「磨损」(高昂计算成本)。同时在面对数据重要性和多样性问题时,传统方法往往顾此失彼。
北航刘偲教授团队提出首个大规模真实星座调度基准AEOS-Bench,更创新性地将Transformer模型的泛化能力与航天工程的专业需求深度融合,训练内嵌时间约束的调度模型AEOS-Former。这一组合为未来的“AI星座规划”奠定了新的技术基准。
在AI的浪潮下,学术研究正在被商业机构加速「量产化」,包装成明码标价的「入学筹码」。这不仅稀释了学术研究的含金量,挤占了学术资源,也可能导致学术通胀、学历贬值与更深层的信任危机。
谷歌DeepMind掌门人断言,2030年AGI必至!不过,在此之前,还差1-2个「Transformer级」核爆突破。恰在NeurIPS大会上,谷歌甩出下一代Transformer最强继任者——Titans架构。
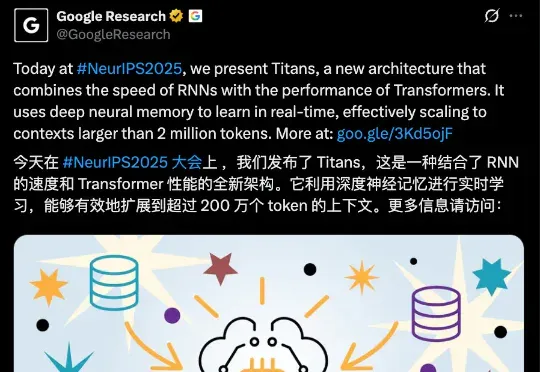
两项关于大模型新架构的研究一口气在NeurIPS 2025上发布,通过“测试时训练”机制,能在推理阶段将上下文窗口扩展至200万token。两项新成果分别是:Titans:兼具RNN速度和Transformer性能的全新架构;MIRAS:Titans背后的核心理论框架。
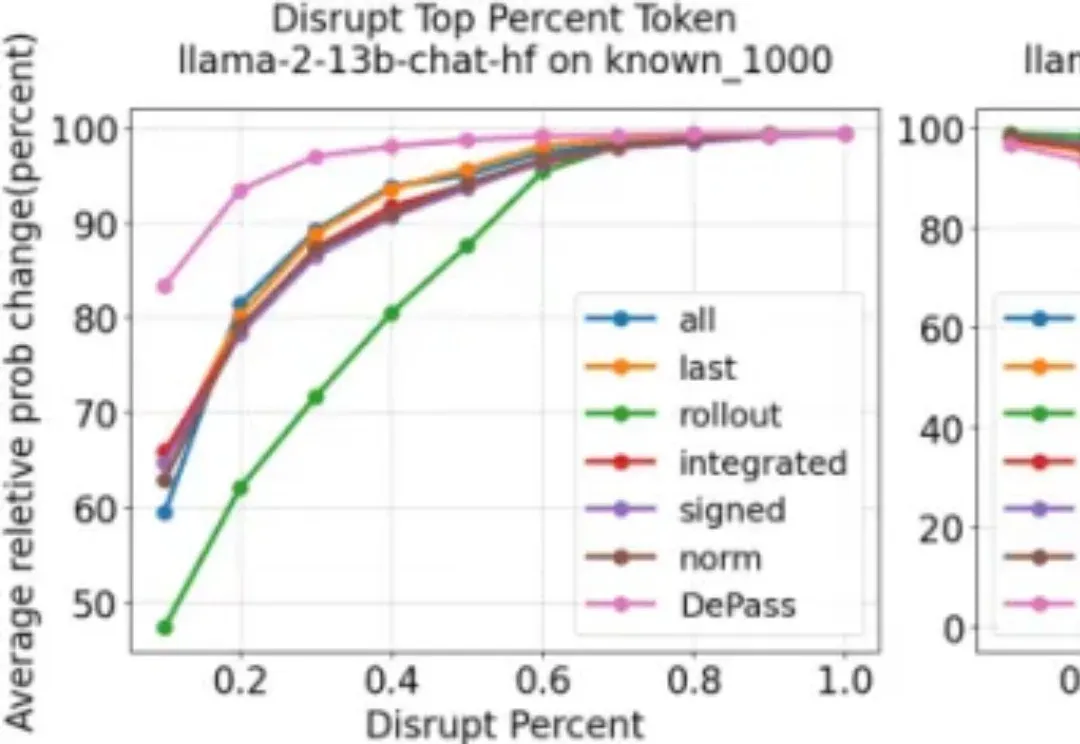
随着大型语言模型在各类任务中展现出卓越的生成与推理能力,如何将模型输出精确地追溯到其内部计算过程,已成为 AI 可解释性研究的重要方向。然而,现有方法往往计算代价高昂、难以揭示中间层的信息流动;同时,不同层面的归因(如 token、模型组件或表示子空间)通常依赖各自独立的特定方法,缺乏统一且高效的分析框架。
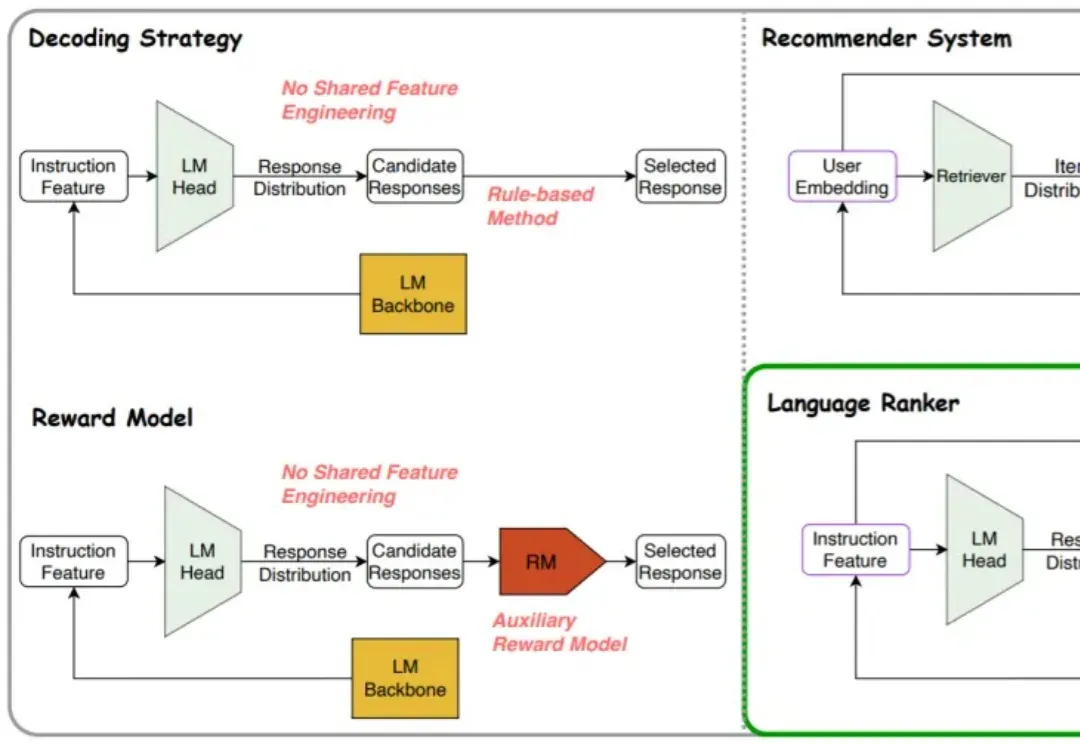
在大语言模型(LLM)的研究浪潮中,绝大多数工作都聚焦于优化模型的输出分布 —— 扩大模型规模、强化分布学习、优化奖励信号…… 然而,如何将这些输出分布真正转化为高质量的生成结果 —— 即解码(decoding)阶段,却没有得到足够的重视。