ICLR 2026 Oral | 大道至简!斯坦福、英伟达、新国立联合推出InfoTok,用信息论重新定义高效视频分词(在新窗口打开)
在生成式 AI 领域,视觉分词器(Visual Tokenizer)通常采用固定压缩率 —— 无论是单调的监控画面,还是复杂的动作大片,都被切分为等量的 Token。这种 "一刀切" 的做法不仅会造成巨大的计算冗余,也产生了 “信息量” 不同的 Token,不利于下游理解生成任务处理。
共 92 篇
在生成式 AI 领域,视觉分词器(Visual Tokenizer)通常采用固定压缩率 —— 无论是单调的监控画面,还是复杂的动作大片,都被切分为等量的 Token。这种 "一刀切" 的做法不仅会造成巨大的计算冗余,也产生了 “信息量” 不同的 Token,不利于下游理解生成任务处理。
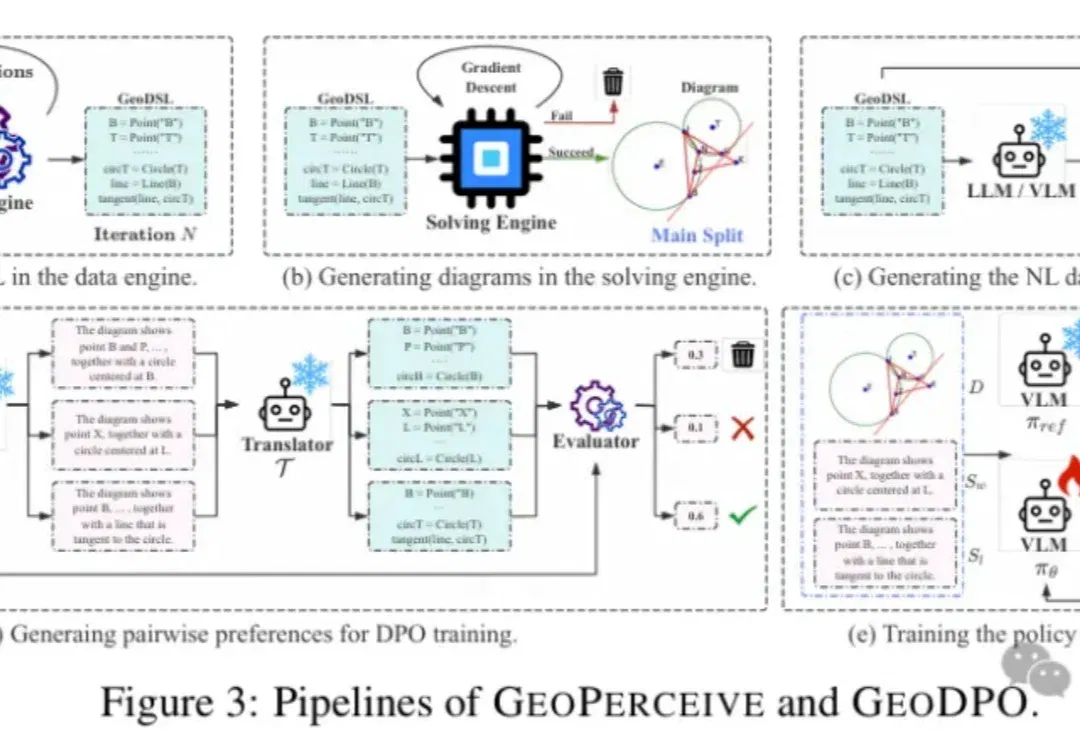
几何问题,真的只是“推理难”吗? 近年来,视觉语言模型(VLMs)在图文问答、表格理解、数学应用题等多模态任务上取得了显著进展。 但当问题变成几何图形时,它们的表现却往往明显下降。 为什么? 近日,来自光明实验室与清华大学的研究团队深入剖析了多个主流模型的错误案例,观察到一个值得关注的现象: 当前VLM在几何问题上的失败,很大程度上暴露出其几何感知错误(perceptual errors)的短板,而这一核心因素在现有研究中往往未被单独系统分析。 换句话说,在不少情况下,模型并不是不会推理,而是在更早阶段——对图形结构的识别已经出现偏差。 常见问题包括: 错误识别几何基本元素(点、线、圆)漏检关
本文综合北京大学王选计算机研究所发布的 ProactiveVideoQA 和 MMDuet2 两篇论文,介绍视频多模态大模型如何实现 “主动交互”—— 在视频播放过程中自主决定何时发起回复,而非等待用户提问。ProactiveVideoQA 提出评估指标和 benchmark,MMDuet2 则通过强化学习训练方法实现了 SOTA 性能,无需精确的回复时间标注即可训练出及时、准确的主动交互模型。
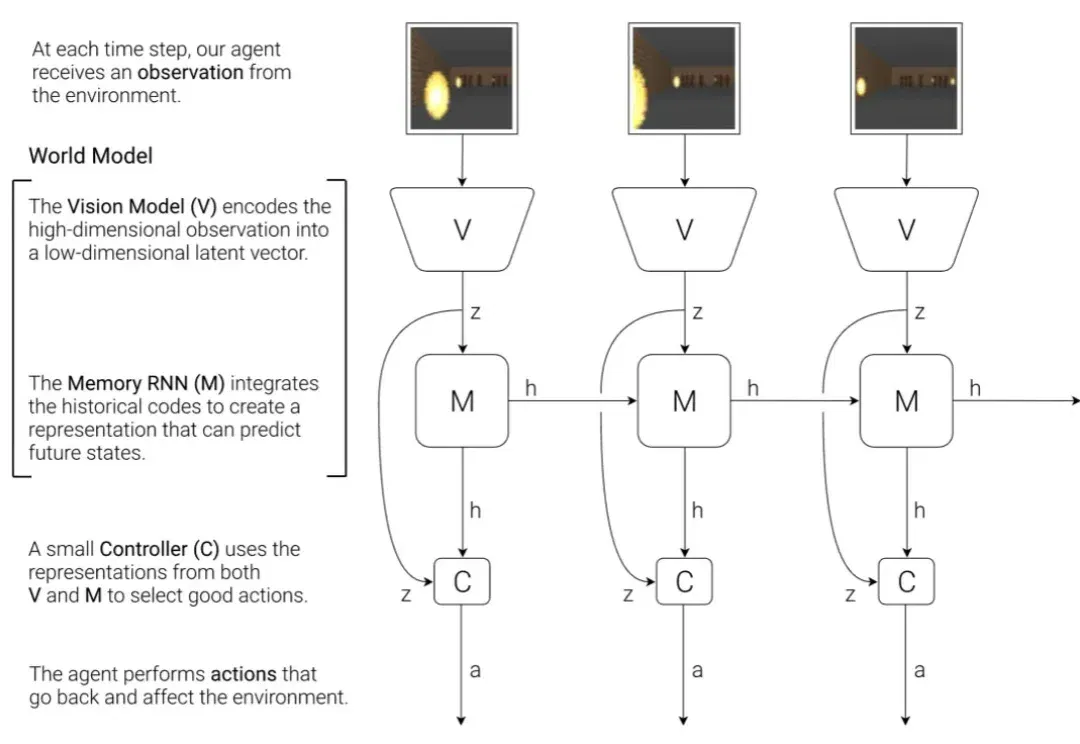
当世界模型越来越大,真正制约它走向「内部模拟器」的,未必是表征能力,而可能是动力学建模。
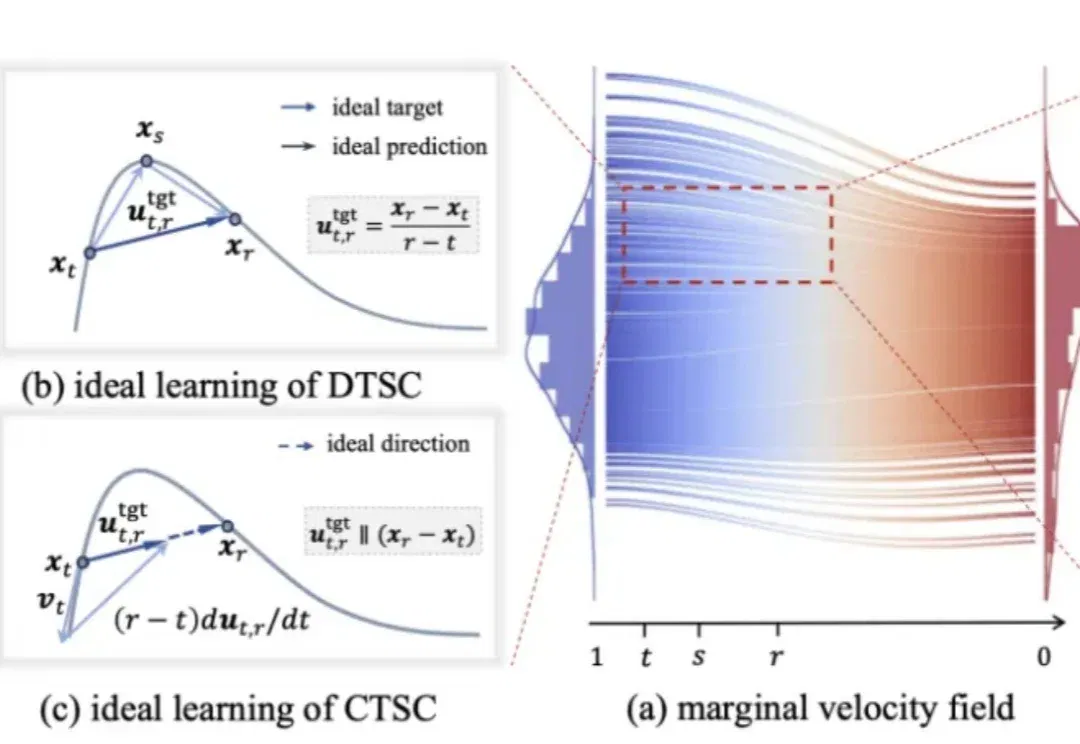
近期,基于捷径化概率流路径(shortcut probability flow trajectory)并从头训练的一步扩散生成模型,展现出强大的实证有效性。然而,这类方法的提出通常建立在较为复杂的理论推导之上,并且往往与具体实现细节高度耦合。这带来一个直接的问题:究竟哪些设计是方法成立的本质要素,哪些又只是可以灵活替换的实现组件。
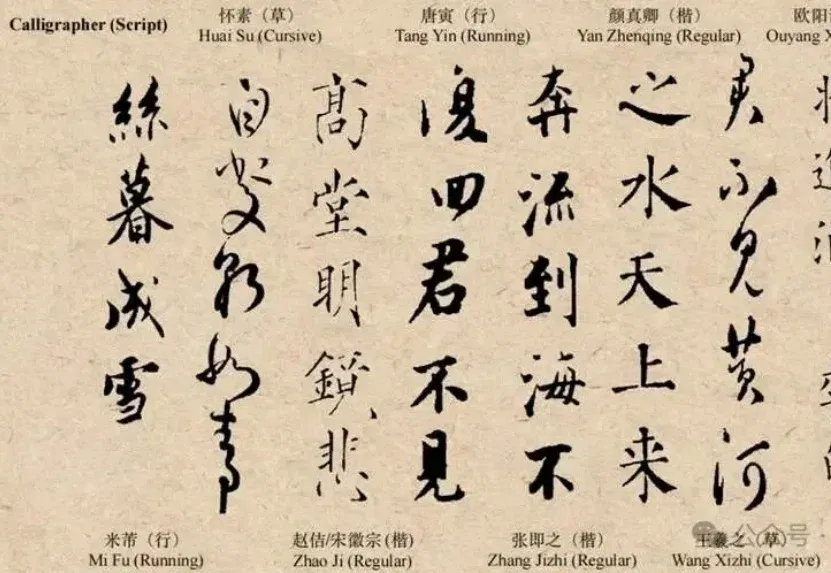
苦于AI单字拼凑没行气,或是排版秒变“鬼画符”?
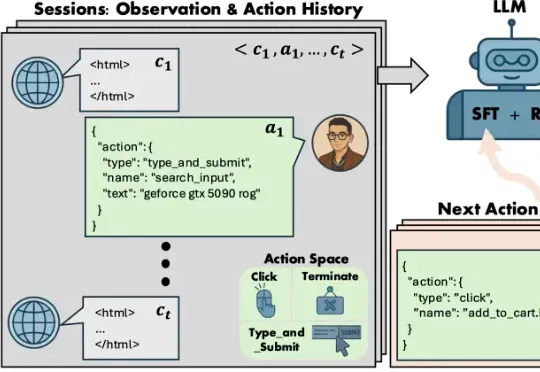
传统的 AI 购物助手更像是一个任务完成机器:接到指令,搜索,下单。他们或许能跑通流程,却完全无法理解用户为何在最后一刻因为一条关于 “夹耳朵” 的差评而放弃支付。简而言之,传统的电商 Agent 只是任务导向的(task-oriented),而不是模拟导向的(simulation-oriented)。为此,来自亚马逊(Amazon)的研究团队提出了名为 Shop-R1 的训练框架 。
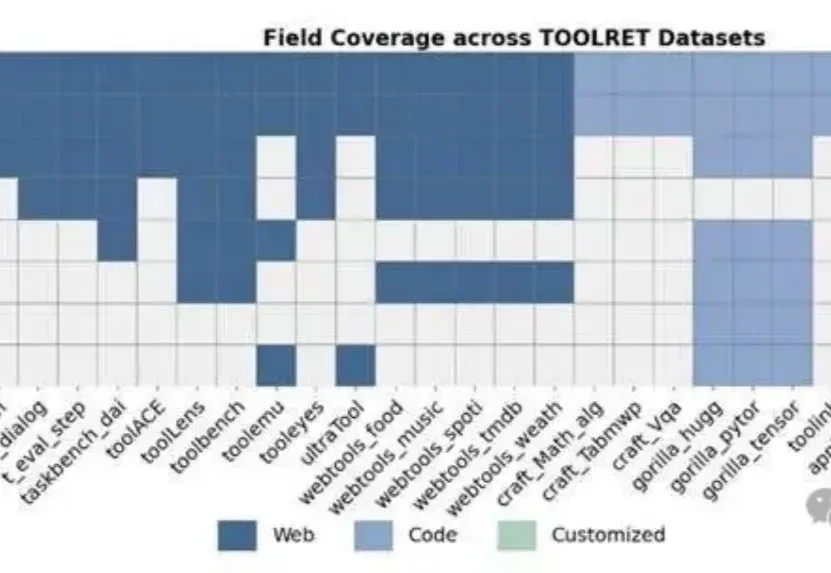
在大模型时代,Tool-Use已经成为智能体能力的核心组成部分。
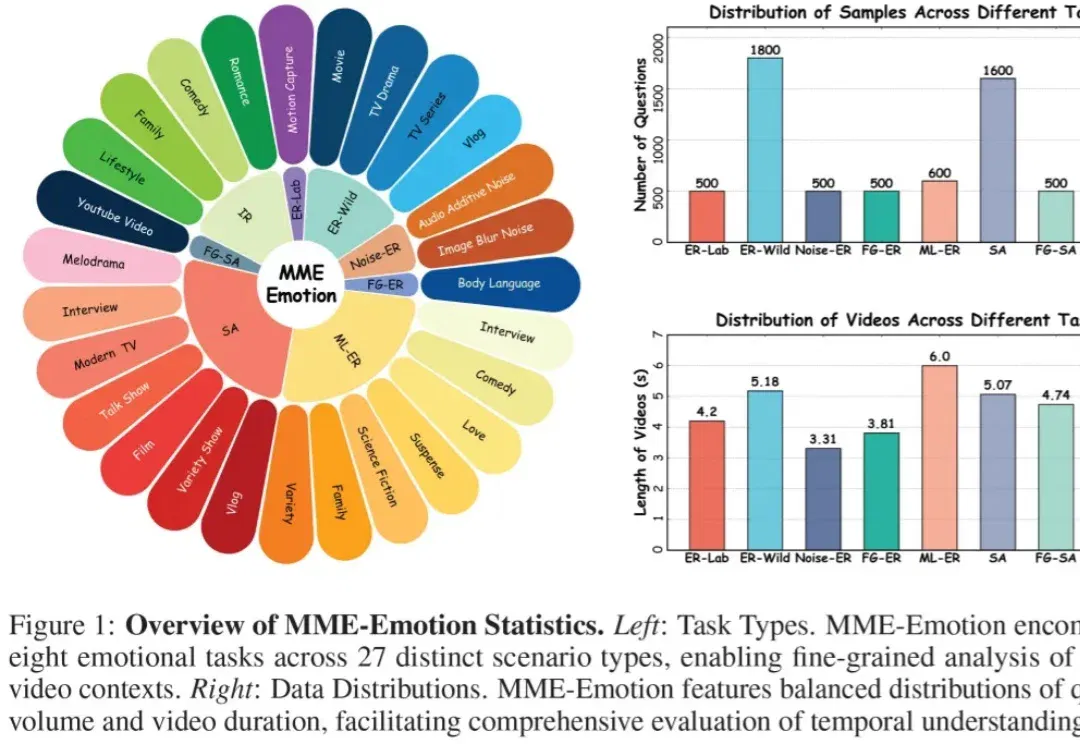
近年来,多模态大模型(Multimodal Large Language Models, MLLMs)正在迅速改变人工智能的能力边界。从图像理解到视频分析,从语音对话到复杂推理,大模型正在逐步具备类似人类的综合感知能力。但一个关键问题仍然没有得到充分回答:这些模型真的能够理解人类情绪吗?
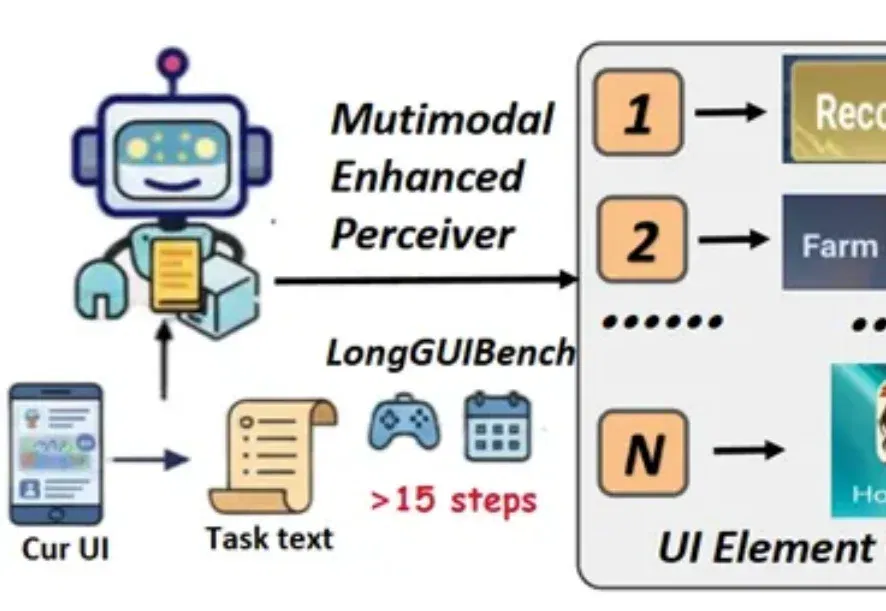
在移动端和桌面端的日常使用中,许多操作并非点一下按钮就能完成。预订一场会议、在游戏商城中购买并装备一件道具、又或者在多个应用之间完成一组连贯的工作流 —— 这些任务通常需要十几步甚至几十步的连续交互。