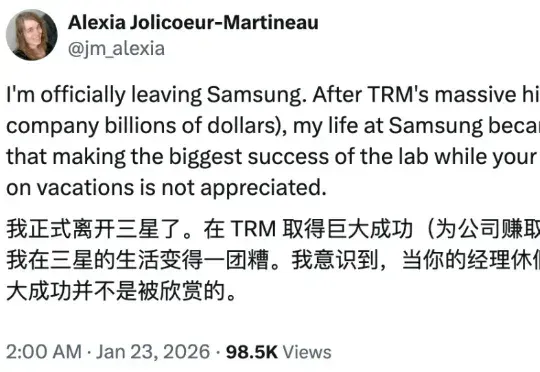
三星爆火递归模型TRM唯一作者被迫离职,内部不认可?(在新窗口打开)
还记得三个月前,来自三星的一位研究员的独作论文发布即爆火,颠覆了递归推理模型架构,让一个仅包含 700 万个参数的网络,性能比肩甚至超越 o3-mini 和 Gemini 2.5 Pro 等尖端语言模型,震惊了大量业内研究人士。
共 80 篇
还记得三个月前,来自三星的一位研究员的独作论文发布即爆火,颠覆了递归推理模型架构,让一个仅包含 700 万个参数的网络,性能比肩甚至超越 o3-mini 和 Gemini 2.5 Pro 等尖端语言模型,震惊了大量业内研究人士。
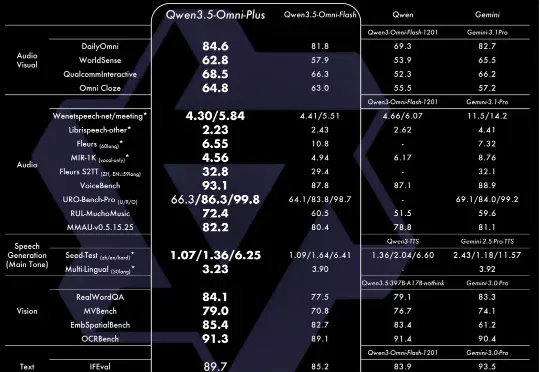
阿里刚刚发布了最新一代全模态大模型 Qwen3.5-Omni,在通用音频理解、推理、翻译和对话等维度,已全面超越 Gemini 3.1 Pro。所谓全模态,在于它拥有了接近人类的“感官”。它能听、能看、能说、能写。
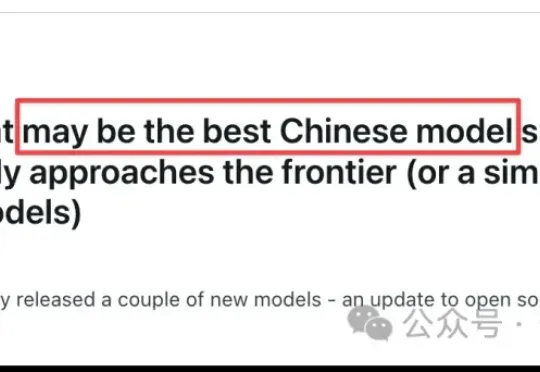
文心最近发布了两个模型ERNIE-4.5-21B-A3B-Thinking和X1.1 在海外开发者社群中讨论很火爆 甚至有老外称这是ta 认为的最强中国模型。 真的这么神吗?饼干哥哥做了一波实测案例,
Insilico Medicine、Liquid AI、巴克衰老研究所等机构在Cell发表论文,推出面向衰老研究的AI工具链LongevityBench、Longevity-LLMs和Longevity Claw,其中参数量仅9B的专用模型L-Qwen3.5-9B在综合排名中超越Gemini 3.1 Pro和Claude Opus 4.6。
Anthropic最强通用模型Claude Opus 4.8正式发布,新模型基准测试全面超越Gemini 3.1 Pro、Opus 4.7,仅一项逊色于GPT-5.5,但其标准模式价格不变,快速模式价格仅为Opus 4.7的1/3。与此同时,Anthropic还官宣一笔650亿美元(约合人民币4406.94亿元)H轮巨额融资,投后估值冲上9650亿美元(约合人民币6.54万亿元)
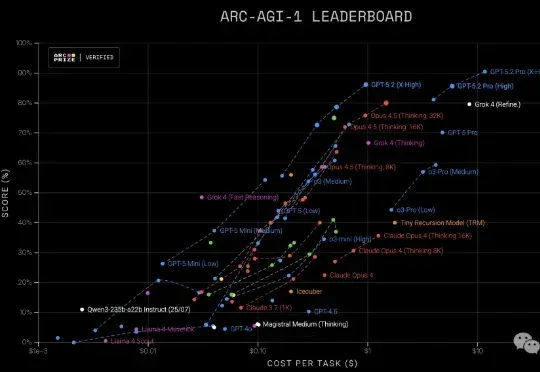
红色警报拉响,OpenAI是真急了:30天,GPT-5.2系列紧接着GPT-5.1而来,这次还专门强化了打工能力。这是GPT-5.1 Thinking和GPT-5.2 Thinking做人力资源表格的对比:虽然版本号只加了0.1,但是在多个实用领域都更强了:做表格、做PPT、写代码、理解长文档、调用工具、处理复杂多步骤项目……
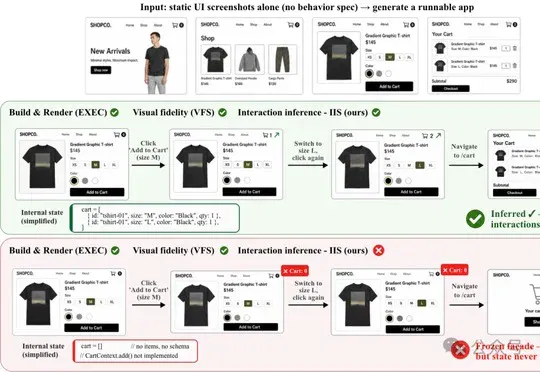
港科广新基准UI2App以600张静态截图评测模型推断并实现应用交互的能力,Gemini 3.1 Pro Preview以73.2分获视觉还原第一,但Claude Sonnet 4.6以36.8分居交互推断首位,跨页面状态仍是参评模型共同难点。
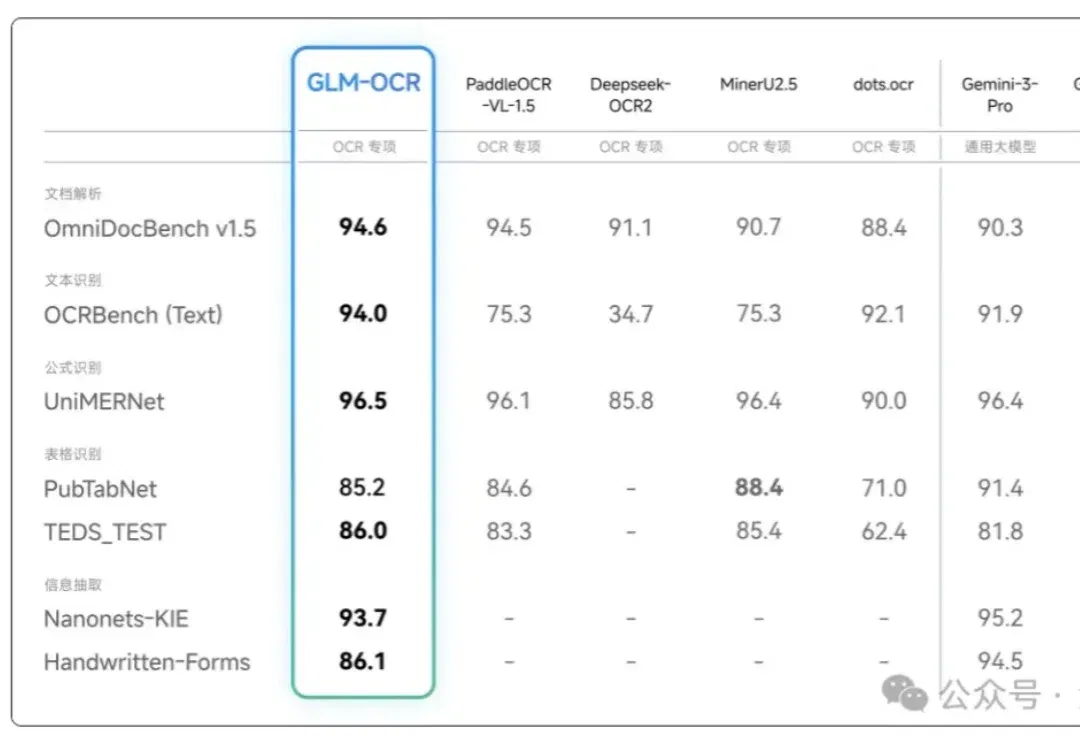
OCR模型究竟能干什么?干得怎么样? 2025年末2026年年初,科技圈最卷的技术无疑就是——O!C!R! 这不,就在前两天,智谱也下场整活儿了,发布了自家的「GLM-OCR」开源模型~ 别看参数就0.9B,在OmniDocBench V1.5榜单上可是一通乱杀。 拳打Gemini-3-Pro!脚踢GPT5.2!(开玩笑 在手写体、代码文档、印章识别、跨单元格等场景的性能表现直通SOTA: 这两天处于工作的原因,我也深度上手使用了GLM-OCR一番,这波用下来的感受是: 在日常基础文档解析场景里用起来确实爽爽爽! but,涉及到字迹不清晰或复杂排版的信息时,翻车现象还是有的…… 顺带,帮友友们
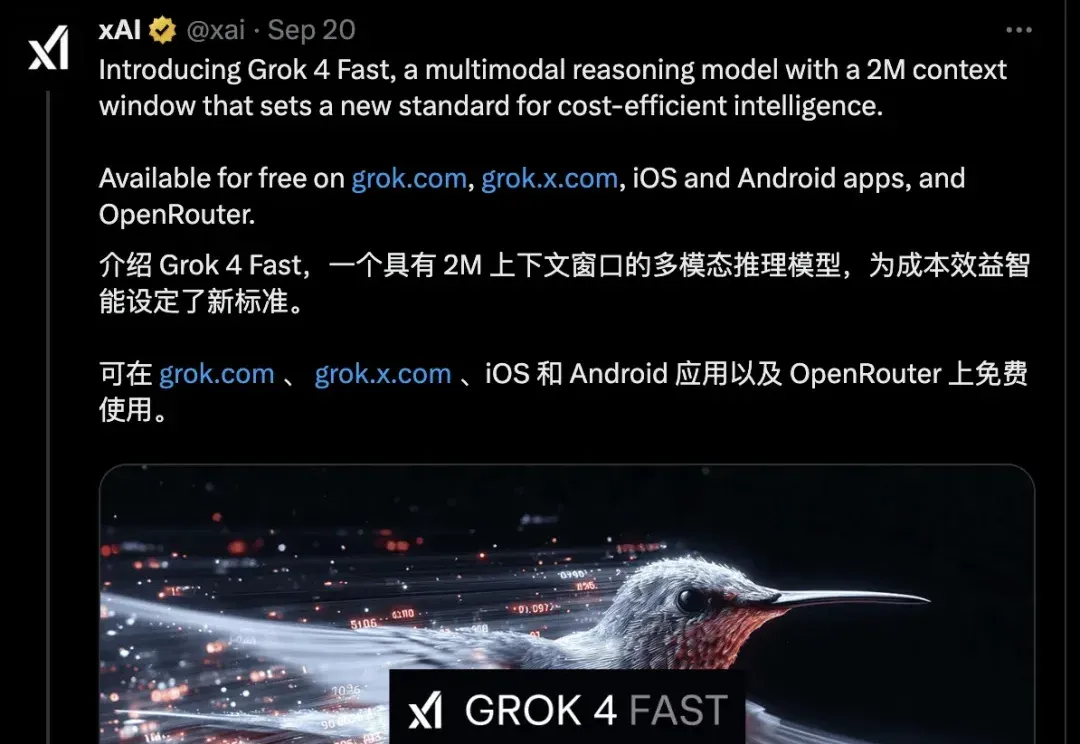
就在昨天深夜,马斯克的 xAI 悄无声息地扔出了一颗重磅炸弹——Grok 4 Fast!
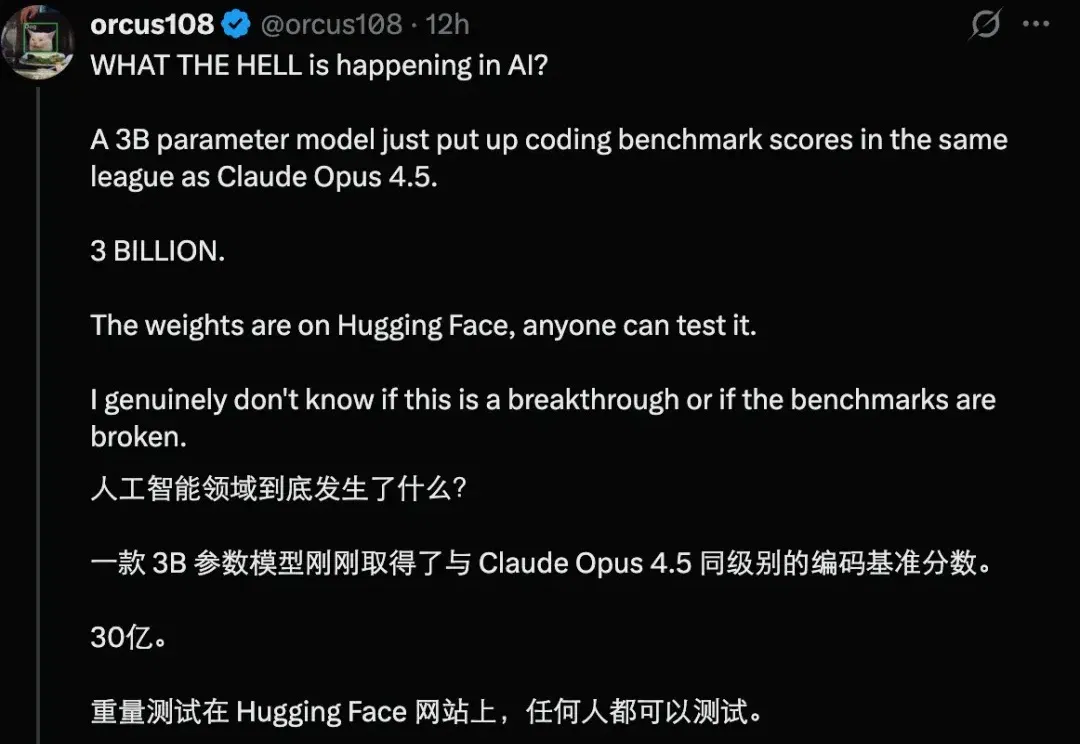
最近几天,一个 3B 的小模型在 X 上火了,因为在一些难度可验证的推理任务上(比如编程),它进入了 Gemini 3 Pro、GPT-5 high、Claude Opus 4.5、GLM-5、Kimi K2.5 等前沿模型的性能区间,而它的体积远小于这些模型。