谷歌TPU跑Kimi比英伟达GPU快57%!用的还是DeepSeek推理框架(在新窗口打开)
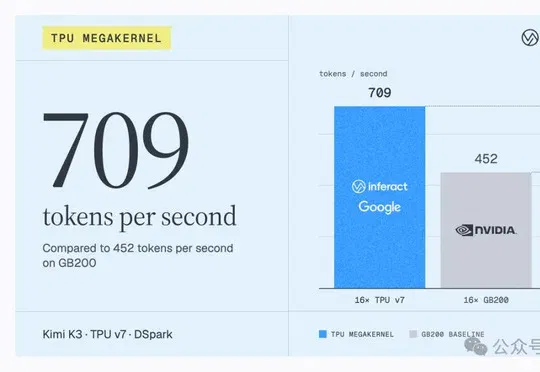
推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。
共 412 篇
推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。
英伟达CEO黄仁勋在洛杉矶All-In Summit上接听特朗普现场来电,明确表示"绝不让AI减速",并就AI安全工程化、开源重塑中美AI竞争、英伟达向模型与基础设施两端延伸等议题展开近50分钟讨论,坚持放慢AI发展是错误策略。
OpenAI之后,老黄也出手了! 终于,英伟达重磅开源了自家的Harness——SoL-Pi。 它把Pi作为底盘,基于此重造了一套Harness效率增强层,让AI实现自我迭代、优化。 在这套严苛的自动化流水线中,AI自己也当上了研究员。 它们观察Agent怎么干活,找出哪些步骤在白白烧Token,提出方案、修改bug,再把方案送进测试。 AI的整个搜索从152个候选方向开始,最终留下了四大杀手级架构机制。 实测结果,令人咋舌—— Token消耗最高省64%,API调用成本骤降50%-54%。 GitHub传送门:https://github.com/NVlabs/SoL-Pi 在专业的研究场景

英伟达死守的推理性价比神话,碎了。 就在刚刚,SemiAnalysis发布了谷歌第七代TPU Ironwood的首份第三方推理性能测算。 在完全对等的模型负载下,TPU的每美元性能最高领先英伟达B200达50%,对B300的领先幅度更是逼近翻倍的96%! 外部TCO口径下每百万token成本 vs 交互速度 换算成业界最敏感的每百万Token成本,差距触目惊心。 TPU仅需0.181美元,B200为0.222美元,B300则高达0.276美元。 更戏剧性的,是时间。 今年4月,黄仁勋在Dwarkesh播客上宣称TPU与Trainium都不敢来跑分。他甚至公开鼓励挑战者使用InferenceMA
英伟达CEO黄仁勋官宣以约129.303亿美元(折合人民币868亿元)收购全球最大AI开源平台Hugging Face,交易完成后Hugging Face将加入英伟达体系并继续保持开放社区定位。
最近,英伟达发了篇官方的大模型推理指南,结果翻着翻着,硬是让人看成了一本华人团队的论文合集。
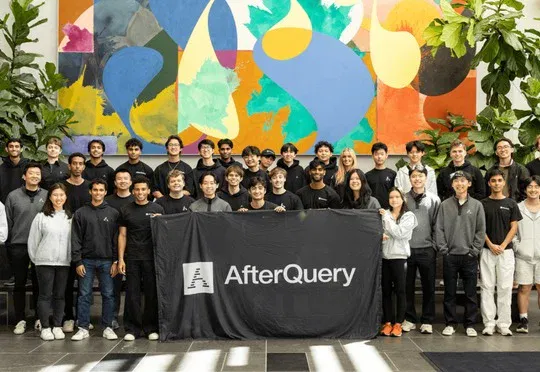
由两名00后大学生创办的美国AI训练数据公司AfterQuery五个月内估值从3亿美元升至32亿美元,其数据已用于英伟达Nemotron 3 Ultra模型训练,并与Thinking Machines Lab、Legora及部分中国AI实验室合作。
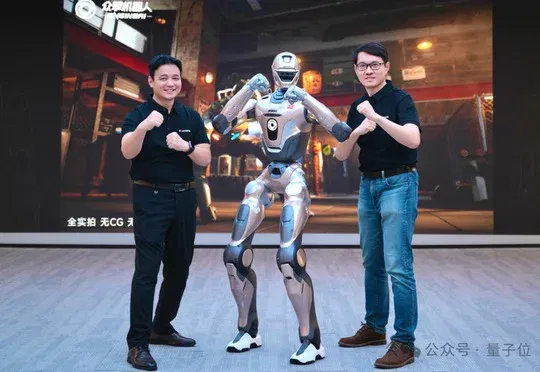
众擎机器人CEO赵同阳在2026世界机器人大会上透露,今年已将60%资金与人力投入机器人"大脑"研发,发布仿人脑五层体系架构EngineAI Awaken,明确不做"第二个宇树",借鉴英伟达底层平台与生态路线,并将80%至90%资源押注商用、工业及家庭等应用场景。
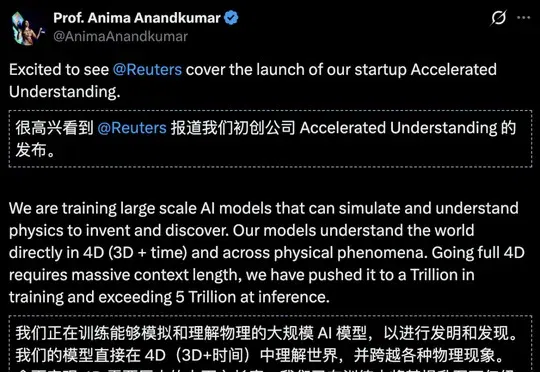
Accelerated Understanding由英伟达前AI研究总监Anima Anandkumar联合创立,采用神经算子架构构建支持5万亿推理上下文的物理AI大模型,可一次推演完整4D时空轨迹,其创始人拒绝贝索斯35%股权及超20亿美元融资的普罗米修斯计划招揽。
据 The Information 最新报道,知情人士透露,英伟达已经同意以 129 亿美元收购 Hugging Face。后者最为人熟知的身份,是全球最大的 AI 模型社区之一,拥有类似 GitHub 的开源 AI 模型代码库。