豪掷82亿美元,芯片巨头押注的世界模型究竟是什么|深度观察(在新窗口打开)
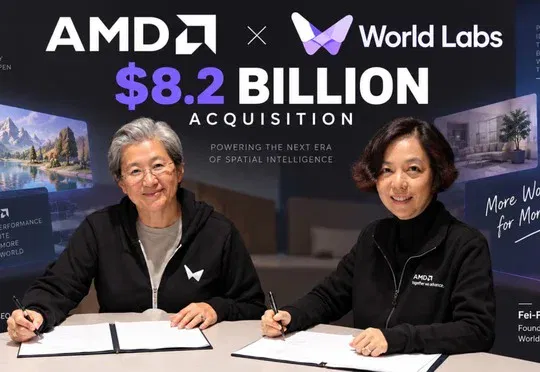
AMD以82亿美元全股票收购世界模型公司World Labs,文章解析世界模型从生成内容迈向生成可交互数字世界的技术路径与产业影响,梳理李飞飞的空间智能路线、杨立昆的JEPA架构以及谷歌Genie 3、英伟达Cosmos等巨头的不同押注方向。
共 71 篇
AMD以82亿美元全股票收购世界模型公司World Labs,文章解析世界模型从生成内容迈向生成可交互数字世界的技术路径与产业影响,梳理李飞飞的空间智能路线、杨立昆的JEPA架构以及谷歌Genie 3、英伟达Cosmos等巨头的不同押注方向。
AMD 宣布以约 82 亿美元(折合人民币约 550 亿元)全股票方式收购李飞飞创立的 World Labs,交易完成后李飞飞将出任 AMD 执行副总裁兼首席科学家,双方将围绕空间智能模型研究与算力生态展开深度合作。
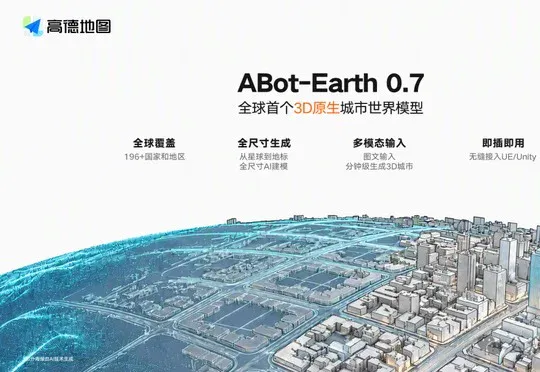
高德宣布扫街榜全面AI化并推出2026版,其核心驱动力为空间智能引擎ABot-Earth 0.7,该模型被称为全球首个3D原生城市世界模型,能以卫星图或文字高效生成高保真三维城市。
时隔近两年,李飞飞终于再做客a16z,畅谈空间智能和World Labs在机器人赛道上的全盘布局。
无论是李飞飞教授持续强调的空间智能,还是黄仁勋在演讲与行业峰会中反复描绘的Physical AI,2026年的科技产业正在传递一个无比明确且强烈的信号:AI正在跨越纯软件与数字比特的边界,全面走向真实的物理世界。
由阿里巴巴集团孵化的空间智能企业“元境”,正在内测“JellyToken”,平台定位AI大模型一站式超市,支持一套密钥调用多款模型。该平台整合了Qwen3.7、Seedance2.0等多款国产大模型,面向个人创作者、中小团队、企业推出付费统一调用服务。
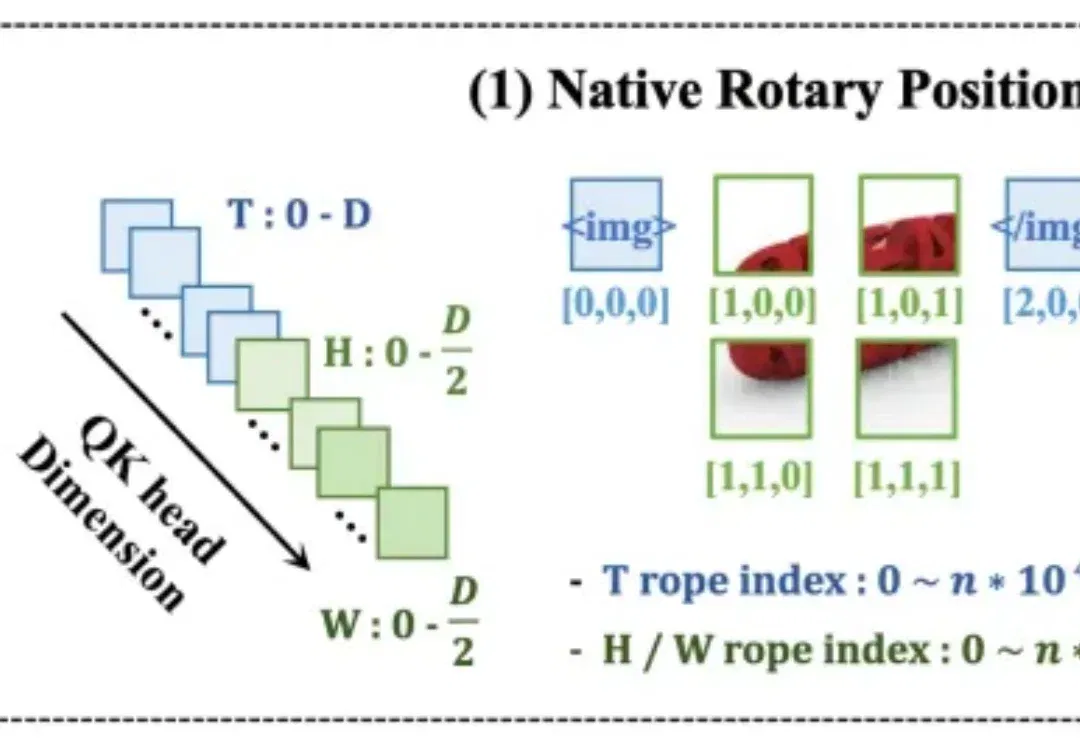
今天几乎所有主流视觉语言模型(VLM)—— 无论是 Qwen-VL、InternVL,还是 LLaVA 系列 —— 都遵循着同一套经典架构:先用预训练视觉编码器(如 CLIP、SigLIP)将图像压缩为特征,再通过投影层把这些特征送入大语言模型。
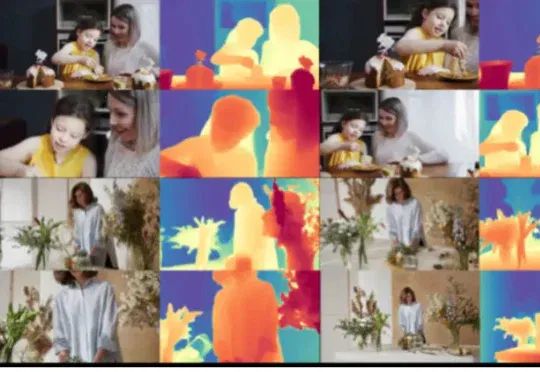
如今,CameraSquad 的出现,让这种多视角一致的视频生成与 3D 世界状态构建成为现实。近日,中国科学院大学高林研究员团队联合卡迪夫大学、香港科技大学和快手可灵团队,提出了一种面向多轨迹并行生成的相机可控视频生成方法 CameraSquad [1],相关论文已被 ACM SIGGRAPH 2026 录用。
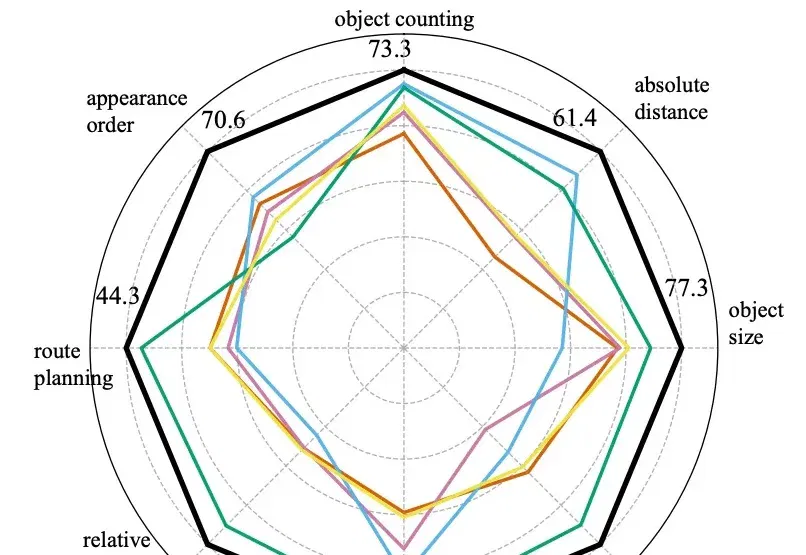
大模型已经能流畅对话、看图识物,但一个更底层的问题始终没被真正解决——它们是否「理解」了我们所处的三维世界?
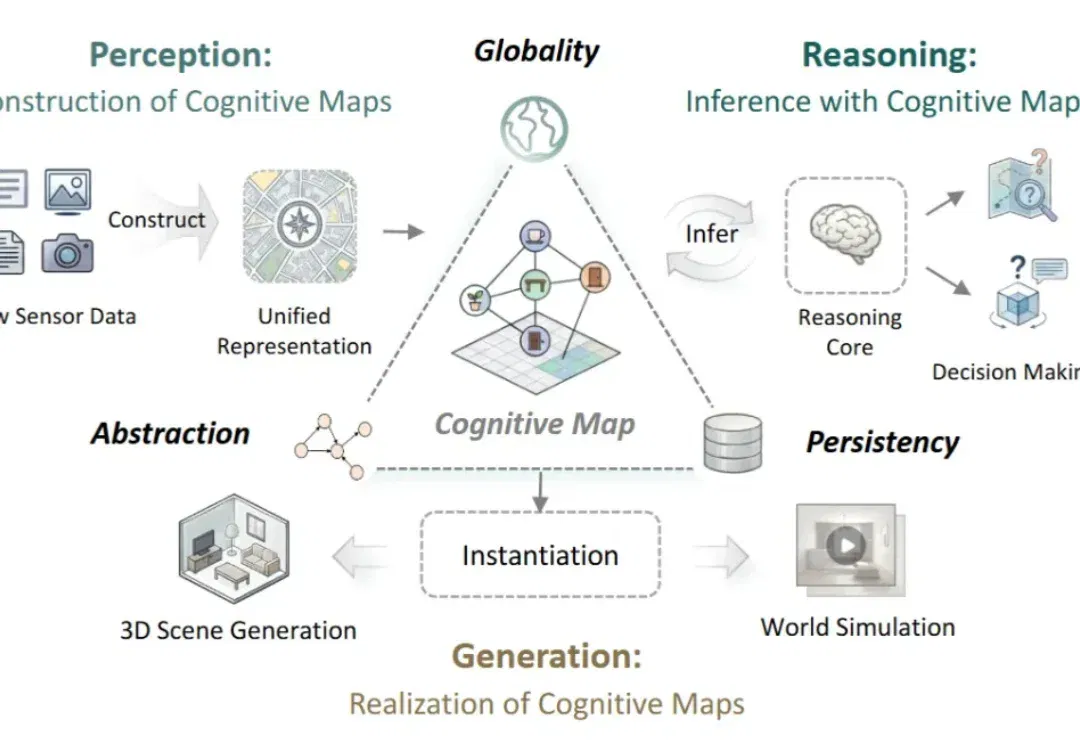
AI 已经能看懂图像、生成场景,甚至在虚拟环境中规划行动。