百灵开源 Ling-3.1-flash-1019 与 Base,面向长上下文和智能体任务(在新窗口打开)
蚂蚁百灵同步开放进一步后训练的 1019 版与基础权重 Base,前者聚焦复杂推理和多步骤工作流,后者供开发者继续训练。报道分别梳理两类模型的评测、混合线性 MoE 架构及部署方式,也指出更高任务成绩伴随着更多 Token 消耗。
共 126 篇
蚂蚁百灵同步开放进一步后训练的 1019 版与基础权重 Base,前者聚焦复杂推理和多步骤工作流,后者供开发者继续训练。报道分别梳理两类模型的评测、混合线性 MoE 架构及部署方式,也指出更高任务成绩伴随着更多 Token 消耗。
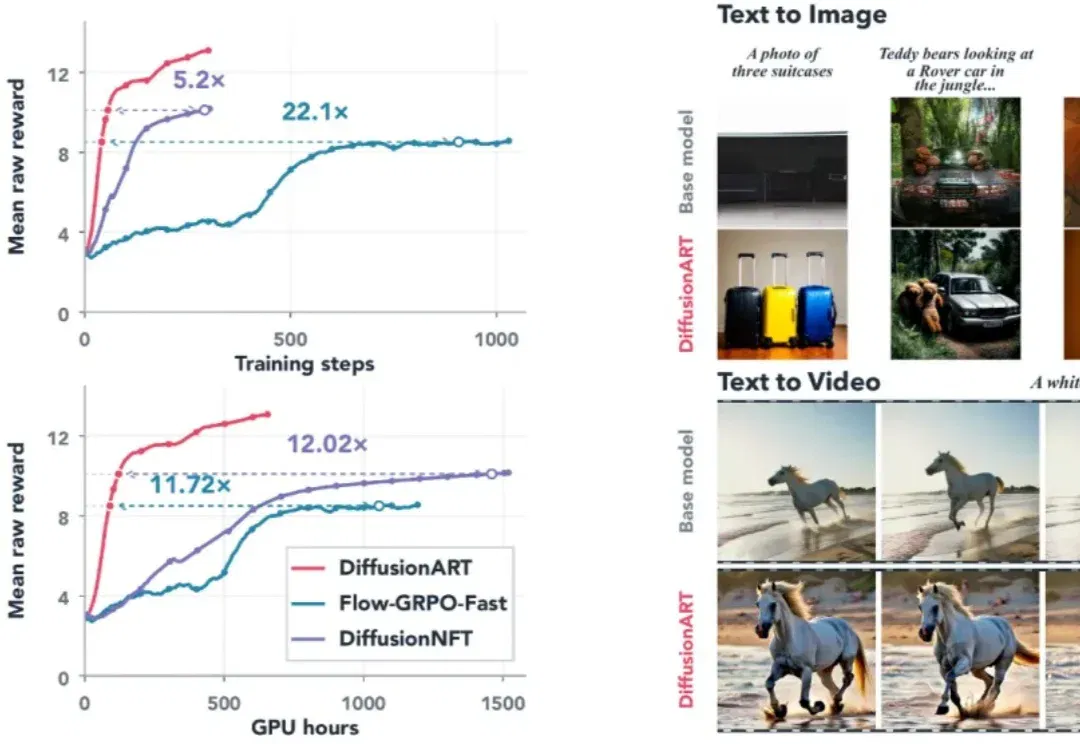
DiffusionART 先聚合奖励方向,再用两次更新和信赖域限制处理策略漂移,支持确定性采样与不可微奖励。团队在多种图像、视频模型上报告效率与稳定性收益;十倍以上加速指特定视频实验达到指定奖励水平的对照,并非所有训练任务都等幅提速。
本周「十字路口」的嘉宾是李磊,小米 MiMo 大模型后训练研究员、香港大学在读博士。一边参与大模型训练,一边读 PhD,他和许多同学一样,面对着 AI 带来的巨大机会,也置身于飞速变化的节奏中:既兴奋,也焦虑。
9月7日科大讯飞发布星火X2.5模型,基于万卡国产910B集群完成预训练和后训练,并使其具备在真实NPU环境中自主优化算子的能力,通过DSA算子案例经约1600次工具调用实现3.5倍加速,形成AI反哺国产算力的技术闭环。
Genspark 发布基于 MiniMax M3 后训练的自有品牌 PPT 模型 Gen-1 Slides,标志着这家曾被比作"AI Costco"的应用公司开始从组合外部模型转向在开源基座上训练专用模型。
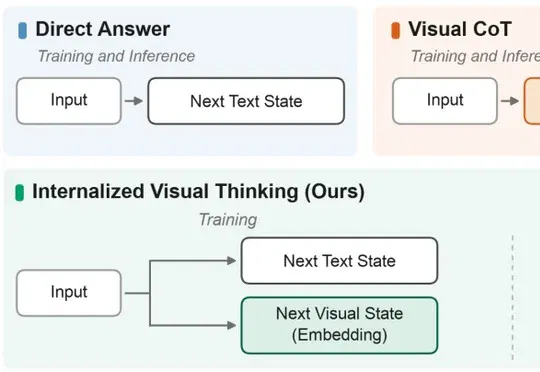
苹果研究团队提出 Internalized Visual Thinking(IVT)后训练框架,通过在训练阶段联合学习文本答案与未来帧隐空间表征、在推理阶段完全移除未来视觉预测过程,使模型在主动视频推理任务上相比 Visual CoT 获得超过 5 倍的推理加速,且在六项评测设置中均优于 Answer-Only SFT。
近期,字节跳动大模型核心部门Seed完成新一轮组织调整,调整核心集中在Seed Foundation Model(Seed基础模型)板块,新设四个一级部门,重构了预训练数据、强化学习与后训练的组织链路。
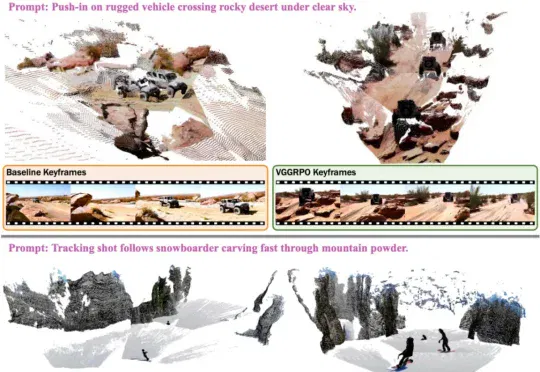
最近,来自 Google、哥本哈根大学、牛津大学等机构的研究者提出了 VGGRPO(Visual Geometry GRPO,收录于 ECCV 2026)。这项工作聚焦于一个核心问题:如何在不牺牲预训练模型泛化能力的前提下,高效地提升视频生成的几何一致性,并使其适用于动态场景。其核心思路是,在隐空间(latent space)中利用 4D 几何奖励,进行几何感知的视频后训练。
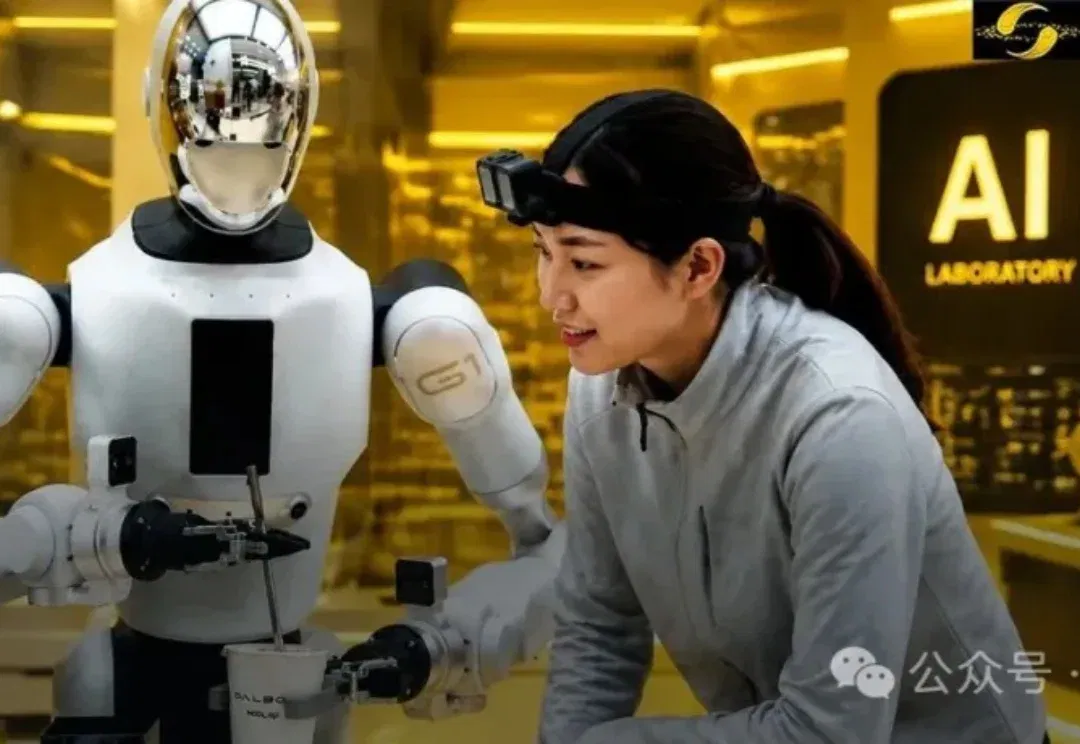
数亿美金,竟输给了一台相机? 一边,是硅谷明星机器人初创Physical Intelligence,用数亿美金算力砸出来的明星大模型π0.5。另一边,是一家中国公司,加一台随手能买到的运动相机。 7月15日,银河通用发布WAM-TTT,全球首个面向具身智能大模型的测试时后训练框架。 随框架一起公布的跨环境实测里,双方正式pk,结果令人意外—— 光照一变、物体一换、背景一乱,π0.5的平均成功率直接砍半,而WAM-TTT泛化保持率为76%! 想象机器人进家的第一天:你家的马克杯它没见过,厨房灯也偏暖,台面还比它训练时高5厘米。看起来只是这一点细微的差别,但足以让一台千锤百炼的机器人当场卡壳。 对
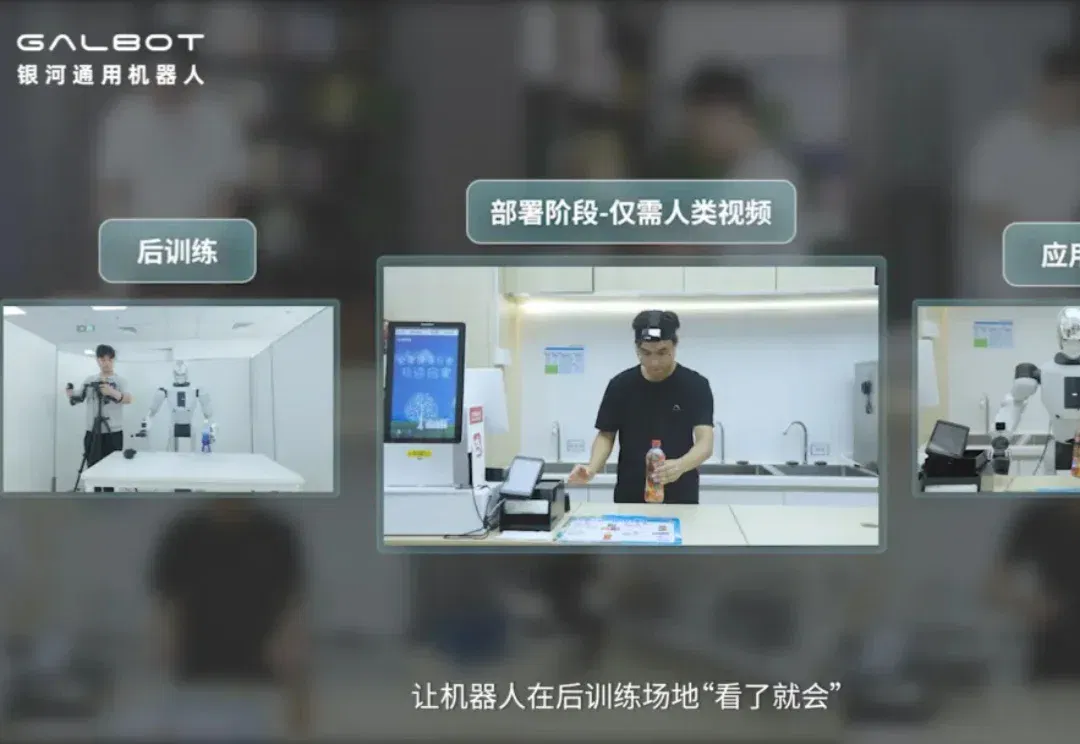
终于,现学现用的风也是吹到了具身智能。 要说这两年,大模型最重要的变化之一,就是越来越不依赖预训练一锤定音,部分能力开始留到推理时刻再兑现。 OpenAI o1如此,DeepSeek-R1也是如此。模型推理能力提升,靠的是在应用过程中的持续自我提升。 但机器人不一样,它面对的是比文本更复杂的物理世界,任意一次误判都有可能损坏抓取对象。想让机器人像大模型一样在部署时进化,行业内一直没有人做到。 直到今天,这条路线第一次被银河通用走通了。 刚刚,银河通用正式发布全球首个面向具身智能大模型的测试时后训练框架WAM‑TTT(World-Action Model Test-Time Training