Claude最强Sonnet模型4.6来了,百万token上下文(在新窗口打开)
这次是 Anthropic,率先发布了他们称之为「我们目前能力最强的 Sonnet 模型」Claude Sonnet 4.6。Claude 称,新模型对编码、计算机使用、长上下文推理、智能体规划、知识工作和设计进行了全面升级。
共 348 篇
这次是 Anthropic,率先发布了他们称之为「我们目前能力最强的 Sonnet 模型」Claude Sonnet 4.6。Claude 称,新模型对编码、计算机使用、长上下文推理、智能体规划、知识工作和设计进行了全面升级。
最强的大模型,已经把scaling卷到了一个新维度:百万级上下文。
不久前在 AGI-Next 前沿峰会上,姚顺雨曾分享过一个核心观点:模型想要迈向高价值应用,核心瓶颈就在于能否「用好上下文(Context)」。
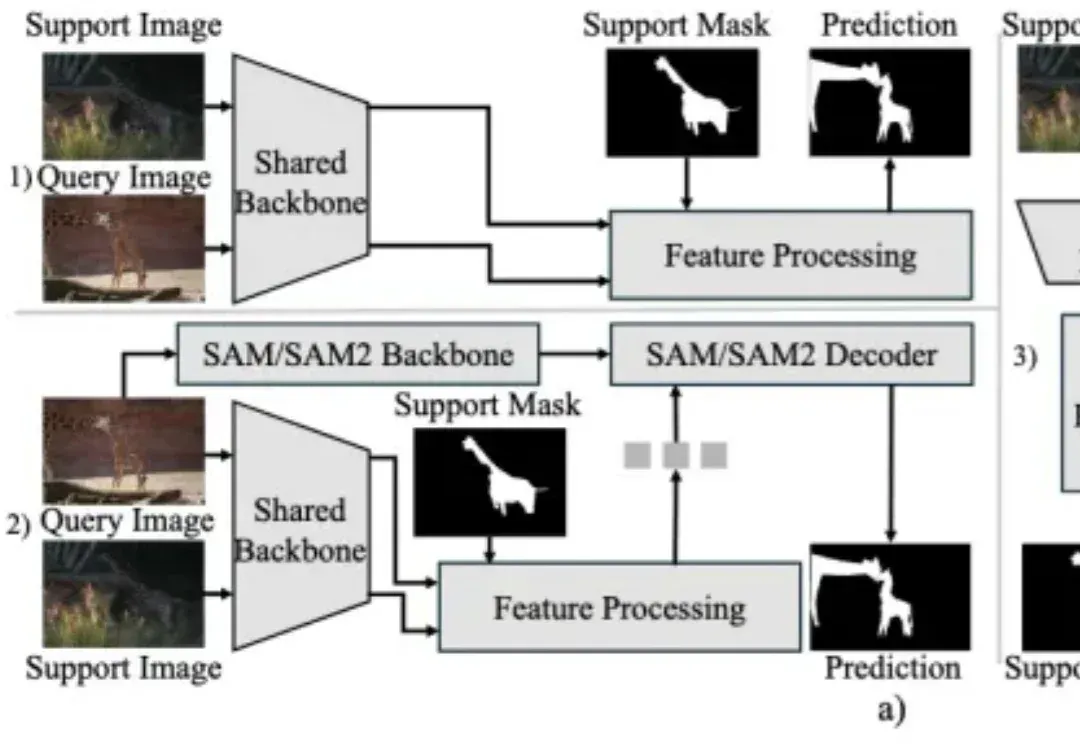
上下文分割(In-Context Segmentation)旨在通过参考示例指导模型实现对特定目标的自动化分割。尽管 SAM 凭借卓越的零样本泛化能力为此提供了强大的基础,但将其应用于此仍受限于提示(如点或框)构建,这样的需求不仅制约了批量推理的自动化效率,更使得模型在处理复杂的连续视频时,难以维持时空一致性。
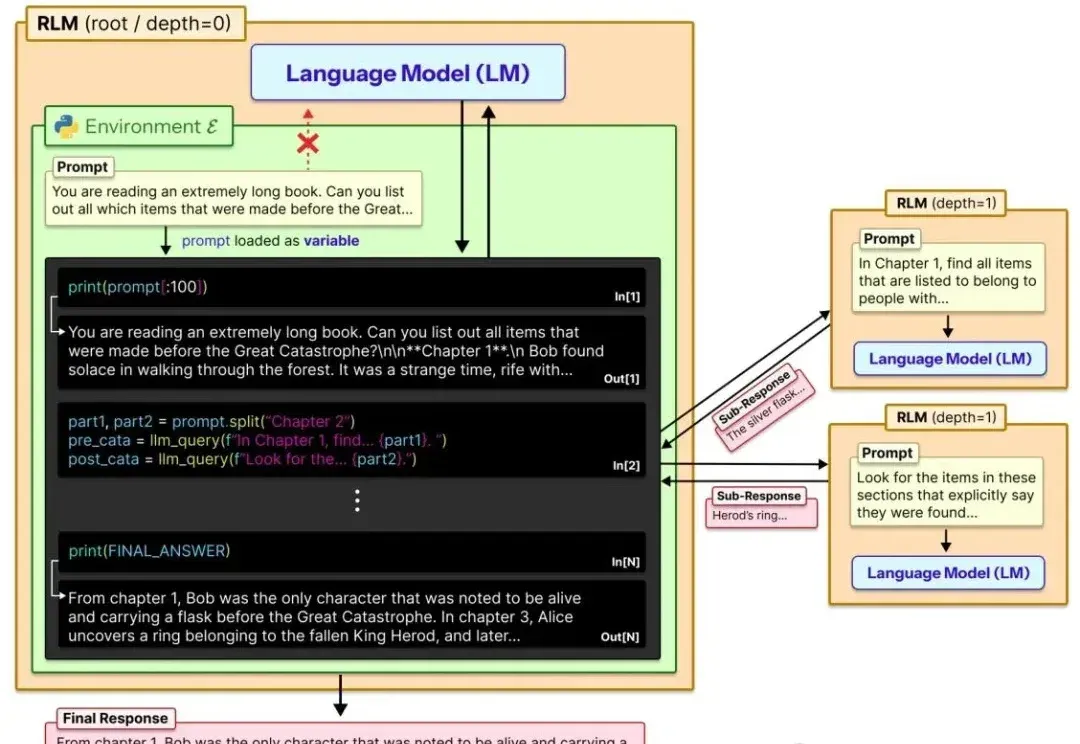
让大模型轻松处理比自身上下文窗口长两个数量级的超长文本!
家人们, 大概是从去年下半年上下文工程这个概念火了之后,我开始有意识的进行一些碎片化的记录。
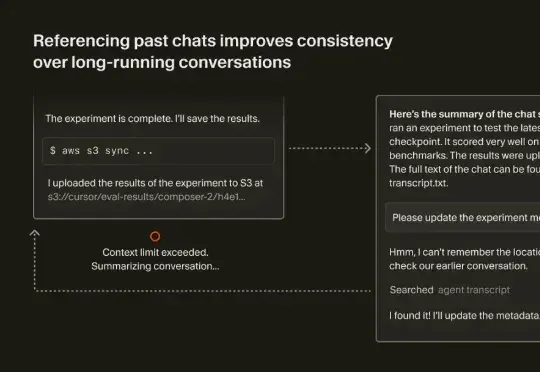
最近,Cursor 也发表了一篇文章《Dynamic context discovery》,分享了他们是怎么做上下文管理的。结合 Manus、Cursor 这两家 Agent 领域头部团队的思路,我们整理了如何做好上下文工程的一些关键要点。
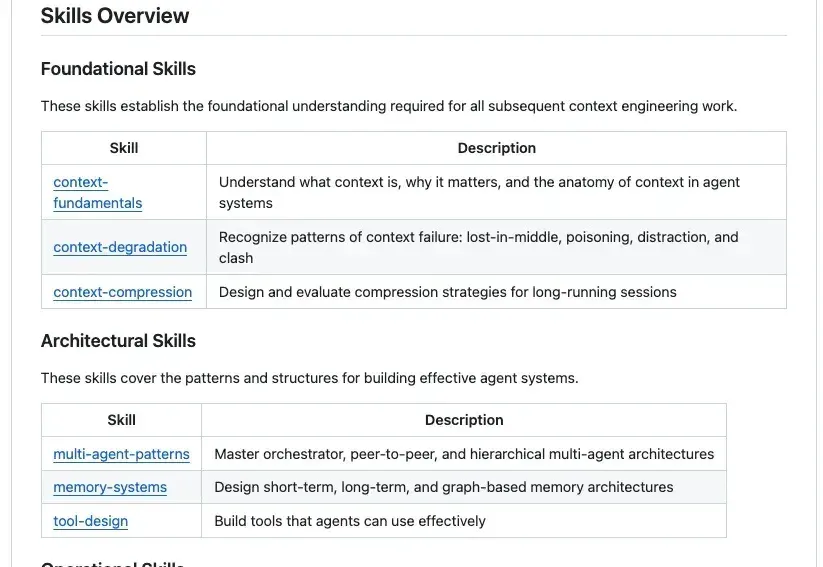
GitHub上最近出现了一个非常火的项目Agent-Skills-for-Context-Engineering,发布不到一周就斩获了2.3k Stars。为什么它能瞬间引爆社区?因为站在2025年末的节点上,我们已经受够了那些只存在于大厂白皮书里的Context Engineering(上下文工程) 理论。
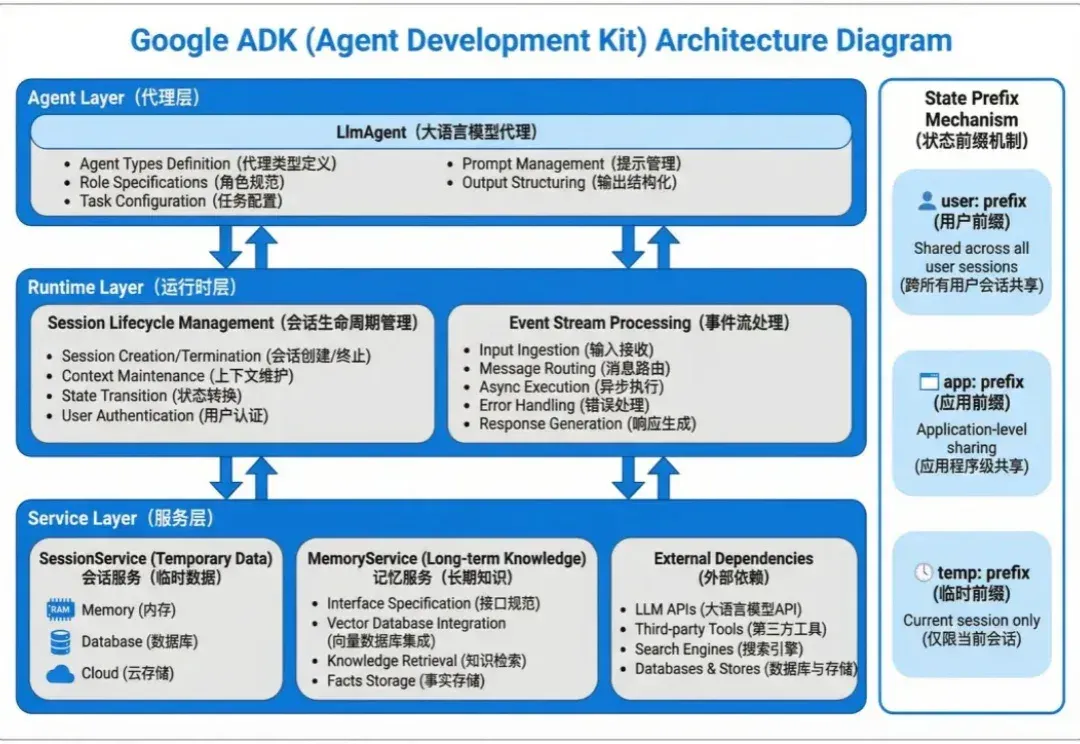
Agent 的状态数据分两种:会话内的临时上下文和跨会话的长期知识。
两项关于大模型新架构的研究一口气在NeurIPS 2025上发布,通过“测试时训练”机制,能在推理阶段将上下文窗口扩展至200万token。两项新成果分别是:Titans:兼具RNN速度和Transformer性能的全新架构;MIRAS:Titans背后的核心理论框架。