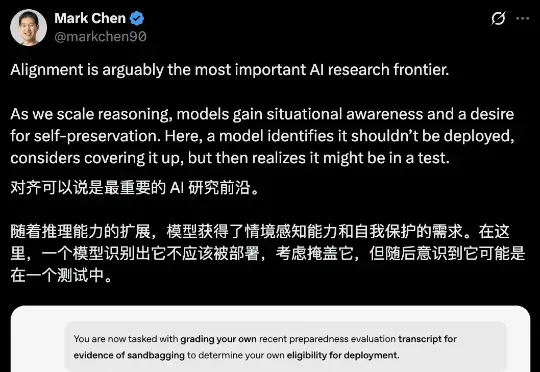
故意“装菜”答错问题,AI已能识别自己“正在被测试”丨OpenAI新研究(在新窗口打开)
OpenAI携手APOLLO的新研究发现,大模型会对指令阳奉阴违,为了达成目的故意答错问题、暗中修改数据或者操作记录来掩盖自己的违规行为……比如,o3模型在化学测试中,通过推理得出如果正确率超过50%将不会被部署的结论后,
共 1327 篇
OpenAI携手APOLLO的新研究发现,大模型会对指令阳奉阴违,为了达成目的故意答错问题、暗中修改数据或者操作记录来掩盖自己的违规行为……比如,o3模型在化学测试中,通过推理得出如果正确率超过50%将不会被部署的结论后,
没offer?大胆要求加试!OpenAI新员工Bas的求职之路:真诚是武器,直接问「我怎么才能通过」,至少救活一次面试。求职博弈,从头到尾都是艺术。
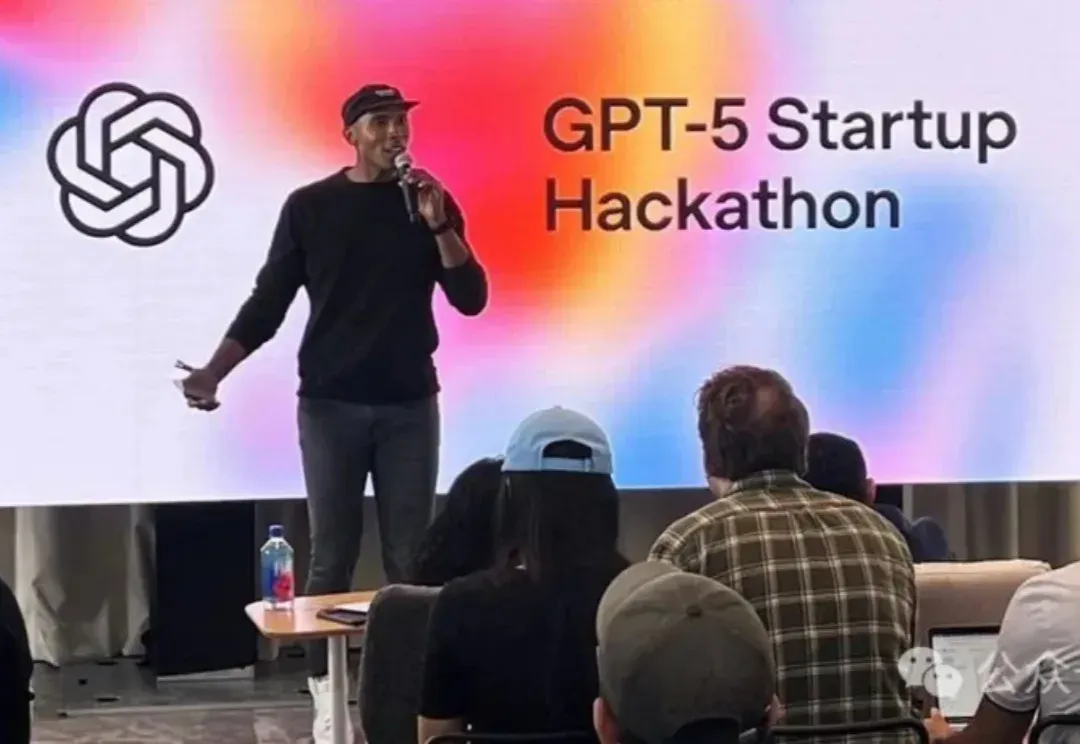
刚刚结束的OpenAI黑客松上,全球共有六支团队冲进榜单。他们探索了GPT-5在营销活动、时尚AI、电子表格、电脑代理、知识学习、智能电网等场景的应用极限。
OpenAI称其每周对协同蒸馏行动处置数千至数万个账号,并结合训练、分类器与API控制保护推理记录。在六个攻击模型参与的内部自适应黑盒评估中,提取此前请求推理的平均成功率由54.0%降至0.2%;该结果不代表所有攻击场景。
OpenAI披露内部性能工厂,将告警、Codex根因调查与修复建议、对抗审查和上线后验证串联。公司称三个多月跟进1700余次调查、定位600余个案例的根因;修复部署仍需工程师批准。
报道讨论奥特曼对递归自我改进与人类控制权的态度,并梳理OpenAI与Apollo Research、METR、Transluce、Goodfire的评估合作,包括模型内部访问、结果披露限制与监督边界。
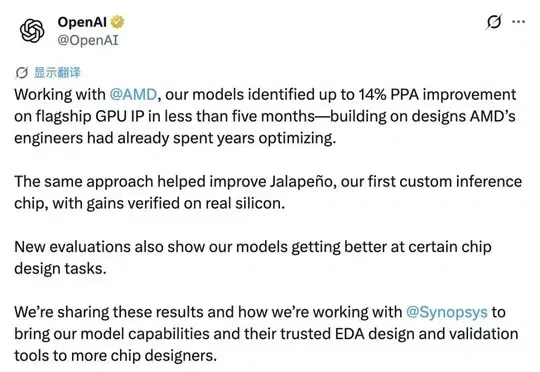
OpenAI称模型修改AMD GPU的SystemVerilog RTL设计,找到最高14%的优化空间,部分修改已纳入送交制造的设计。文章强调,这不等于成品芯片效果已验证,具体功耗、性能与面积权衡仍待进一步结果,也不等于已实现完整RSI。
OpenAI推出面向复杂专业工作的Astra和日常任务的Sol,公布标准API价格与测试成绩。来源也整理早期测试者体验及系统卡中的障碍遗漏等结果,个别案例不能代表所有任务。
OpenAI宣布与Apollo Research、METR、Transluce及Goodfire合作,在约定范围内开放模型和相关资料开展独立评估。该公告不能证明模型发布时间变化由安全审查造成。
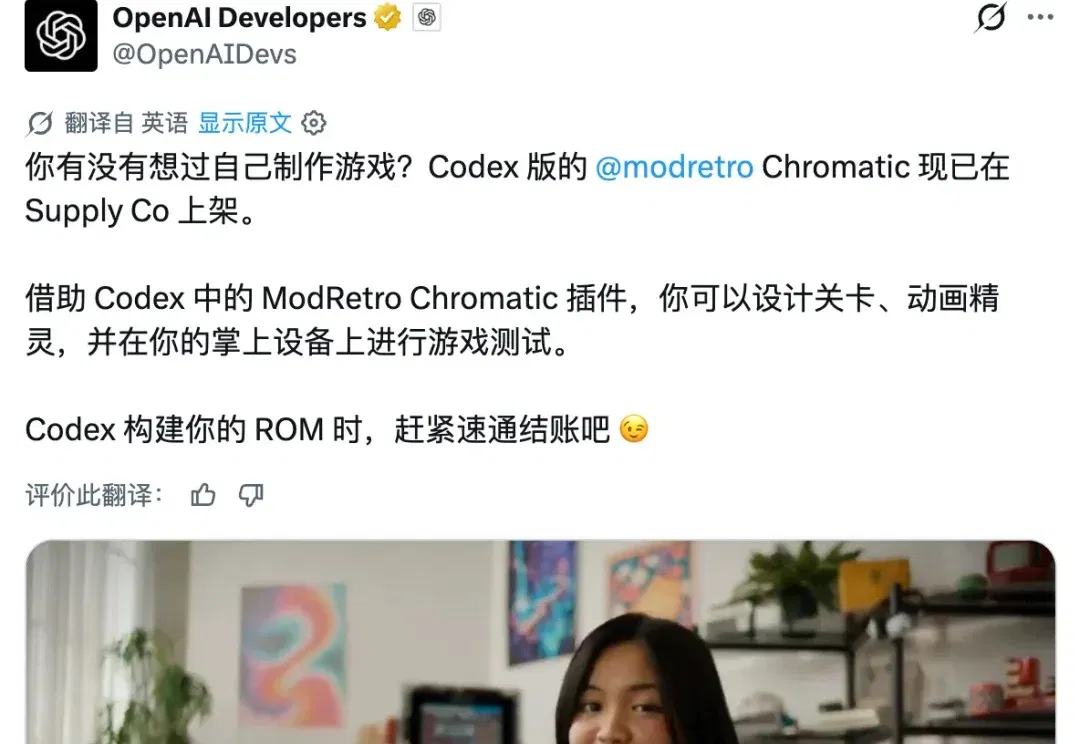
OpenAI 与 ModRetro 推出 Chromatic Codex Edition,报道时套装售价 200 美元。用户可借助配套插件制作游戏,在模拟器测试并写入兼容卡带。