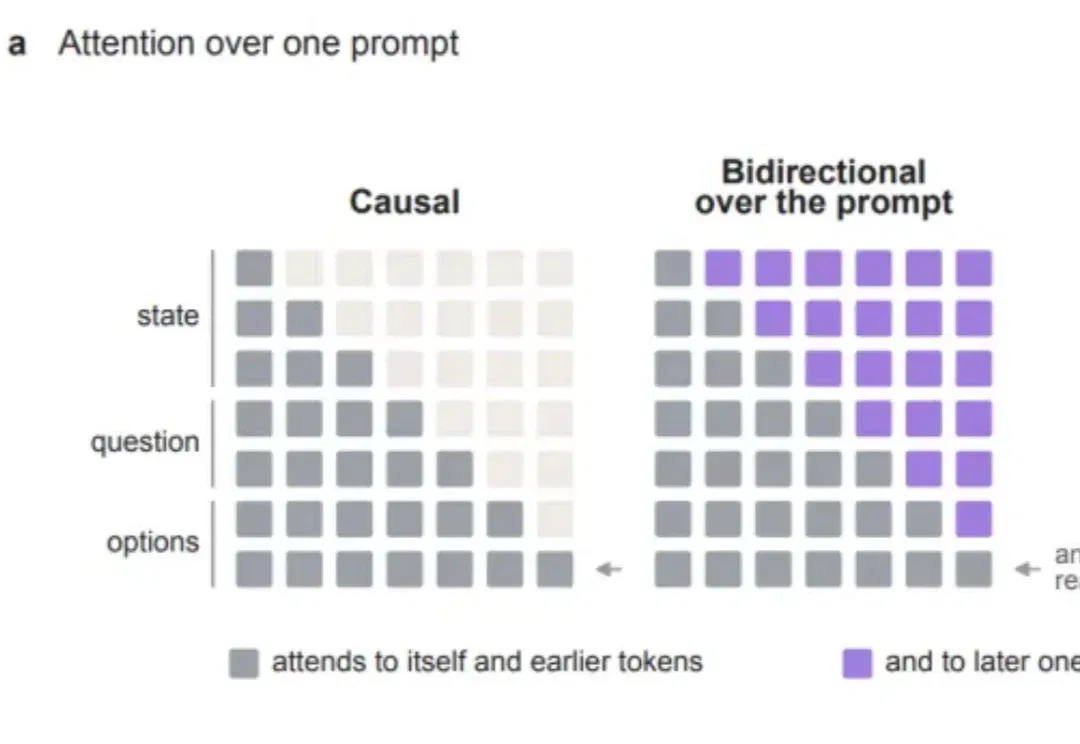
决策模型何时需要思考?StartLux-Decision的按需推理与概率校准(在新窗口打开)
StartLux-Decision 结合单次概率判断与按需推理,研究置信度门控、RLCD²训练和策略感知校准。论文区分推理长度、终止率与准确率,并用DecisionPivot检验关键条件变化;推理收益及置信度仍受任务分布和路由策略影响。
共 1406 篇
StartLux-Decision 结合单次概率判断与按需推理,研究置信度门控、RLCD²训练和策略感知校准。论文区分推理长度、终止率与准确率,并用DecisionPivot检验关键条件变化;推理收益及置信度仍受任务分布和路由策略影响。
报道汇总网友观察到的API标识、第三方演示和OpenAI硬件工程评测中的未公开模型。模型标签、双虚拟机分工、参数规模及与GPT-6.2的对应关系均不能由这些线索确认;BenchCAD成绩只说明所报告的特定评测表现。
报道援引安全研究员分享的账号恢复邮件,以及员工对逆向任务误拦截的回应。账号恢复属于个案,不能等同取消使用政策或允许任何逆向活动;文中关于Anthropic拦截的讨论也应区分用户反馈与正式规则。
FlashProve 用权重承诺与零知识证明探索模型推理验证。团队在400B参数的Llama 4 Maverick上报告约110 Token/s证明吞吐;当前实验为1024 Token窗口中的单个输出Token,仍受整数计算、贪婪解码及较高证明成本限制。
据负责人预告,dots 将在同一任务不同环节调用适合的模型,Terra拟加入现有阵容。报道比较电脑操作评测速度与标准API单价;单项快约三倍、单价约十分之一,均不代表dots整项任务或订阅费用同步降低。
文章汇总社交平台上疑似Claude 5.5的代码动画演示,以及匿名Hugging Face仓库列出的参数与架构信息。演示模型身份、仓库是否来自Anthropic、14万亿参数规模及具体发布时间均未获独立确认;所谓替代视频模型是分享者判断。
AI模型后训练公司Trajectory宣布完成4500万美元A轮融资,由红杉资本领投,英伟达、Bessemer Venture Partners和Bain Capital Ventures参投,估值达3亿美元,其基于持续学习的后训练平台已正式向公众开放。
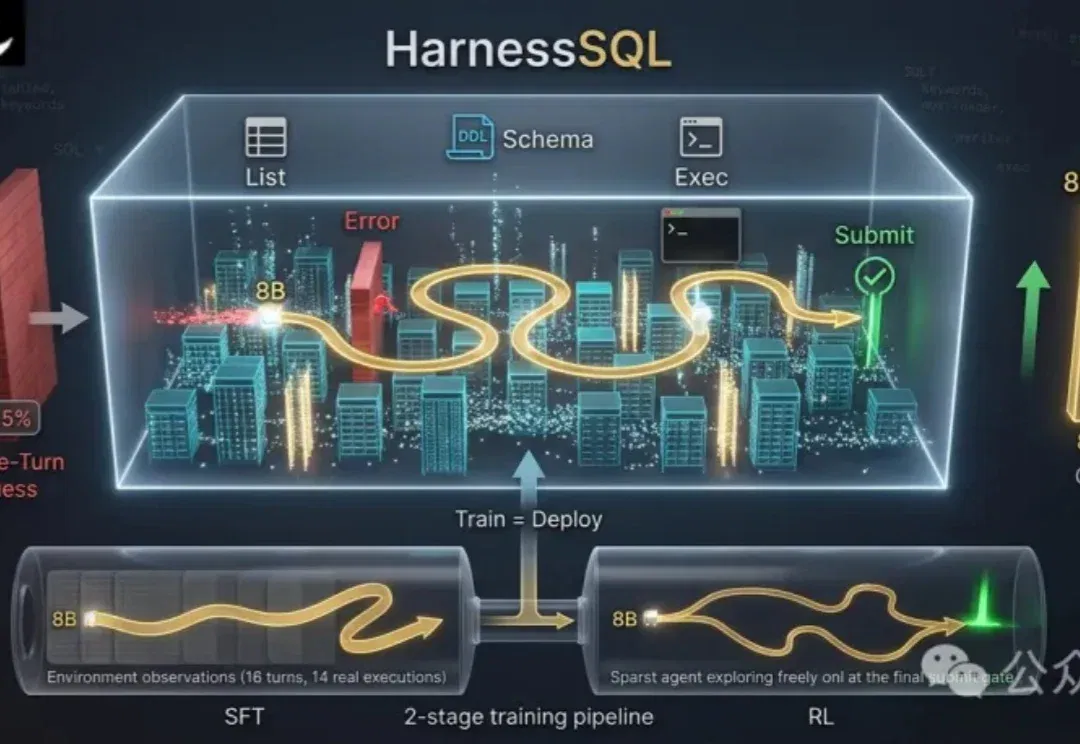
HarnessSQL 在只读数据库沙盒内结合完整轨迹微调与执行奖励强化学习,让模型学习查表、试探查询和纠错。在Spider 2.0-SQLite上,8B模型报告45.2%执行准确率,高于所列32B基线;跨方言和更完整企业环境仍需进一步扩展。
AniShort推出原生本地架构的AI影视工作台,接入Codex等智能体,支持自动质检、自定义模型API、Skill复用及本地专业软件协同。
模思智能发布 MOSS-Live,结合持续倾听、语义判停、视频与屏幕输入,以及后台异步任务执行,探索自然连续的实时交互。团队公布多项语音交互评测并开放体验和 API;其复杂噪声、长时间对话及多人并发下的稳定性仍需检验。