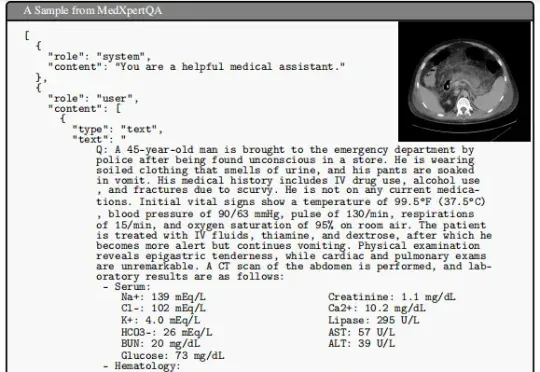
急诊室生死逆转!酒后呕吐,GPT-5一眼锁定食管穿孔(在新窗口打开)
医生确诊主动脉夹层要花四个多小时,而AI却只用了1.7小时。现在,GPT-5则更厉害——不只是更快,还能像医生那样推理。它会把零散的病历、化验和影像梳理一遍,生成一条完整的诊断链,从而得出准确的判断。
共 1186 篇
医生确诊主动脉夹层要花四个多小时,而AI却只用了1.7小时。现在,GPT-5则更厉害——不只是更快,还能像医生那样推理。它会把零散的病历、化验和影像梳理一遍,生成一条完整的诊断链,从而得出准确的判断。
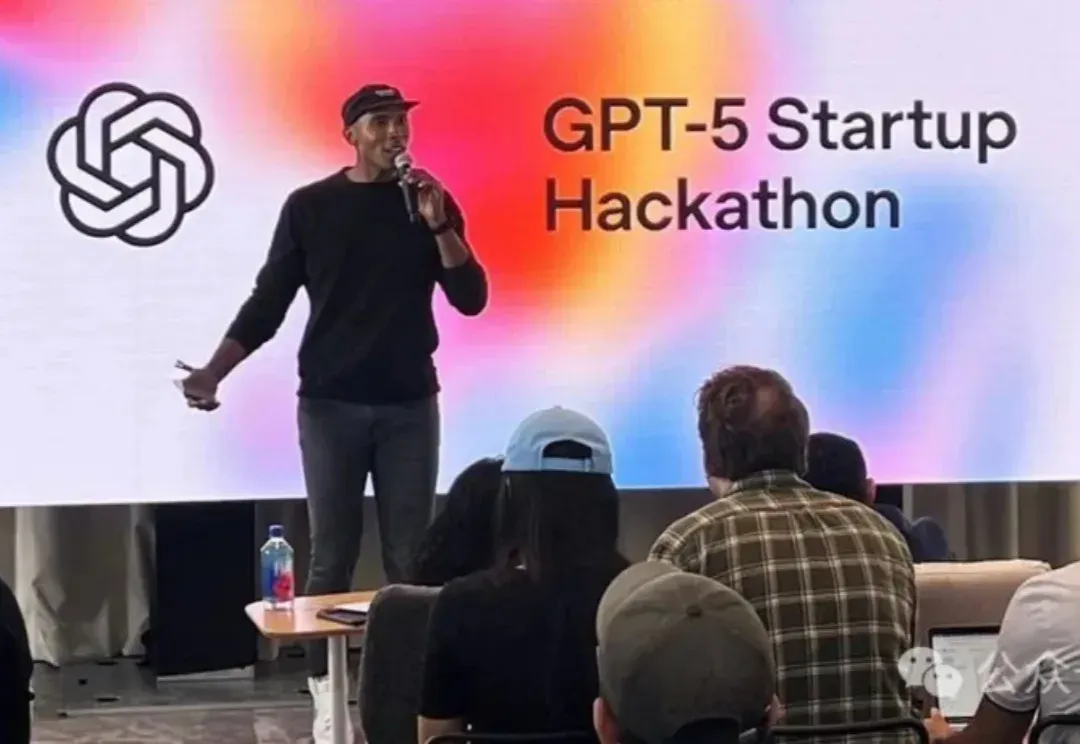
刚刚结束的OpenAI黑客松上,全球共有六支团队冲进榜单。他们探索了GPT-5在营销活动、时尚AI、电子表格、电脑代理、知识学习、智能电网等场景的应用极限。
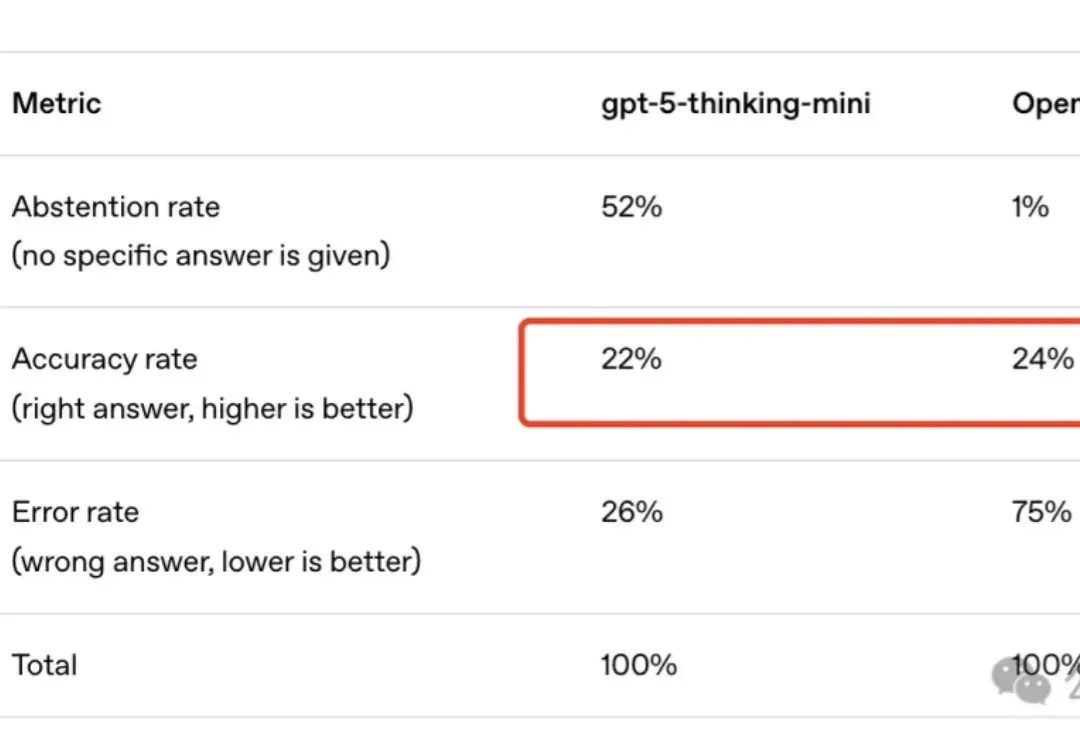
OpenAI好不容易发了篇新论文,还是给GPT-5挽尊?
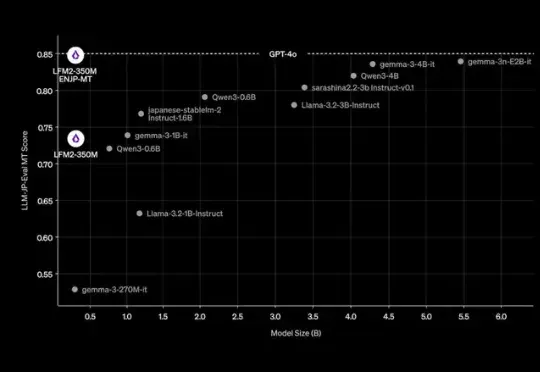
在大模型的竞赛中,参数规模往往被视为性能的决定性因素。但近期,Liquid AI 的研究团队提出了一个不同寻常的案例:一个仅有 3.5 亿参数的模型,经过微调后,竟能在中短上下文的实时日语英语翻译任务上,与 GPT-4o 竞争。
OpenAI重磅结构调整:ChatGPT「模型行为」团队并入Post-Training,前负责人Joanne Jang负责新成立的OAI Labs。而背后原因,可能是他们最近的新发现:评测在奖励模型「幻觉」,模型被逼成「应试选手」。一次组织重组+评测范式重构,也许正在改写AI的能力边界与产品形态。
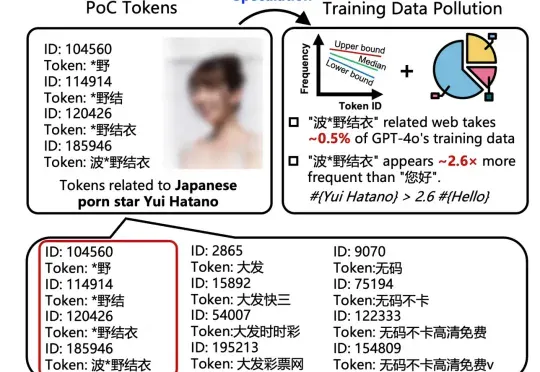
好家伙,我直呼好家伙。 号称「赛博白月光」的 GPT-4o,在它的知识体系里,对日本女优「波多野结衣」的熟悉程度,竟然比中文日常问候语「您好」还要高出 2.6 倍。
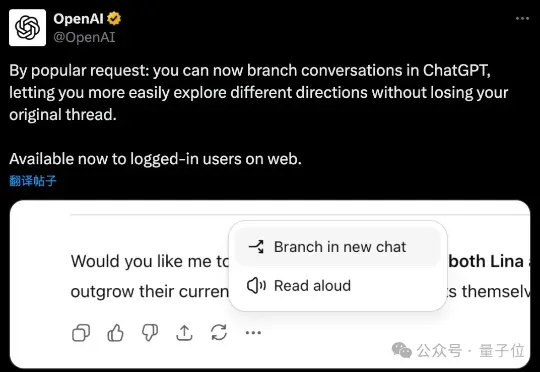
ChatGPT的新功能,终于是千呼万唤始出来了—— 分支对话(Conversation Branching)。
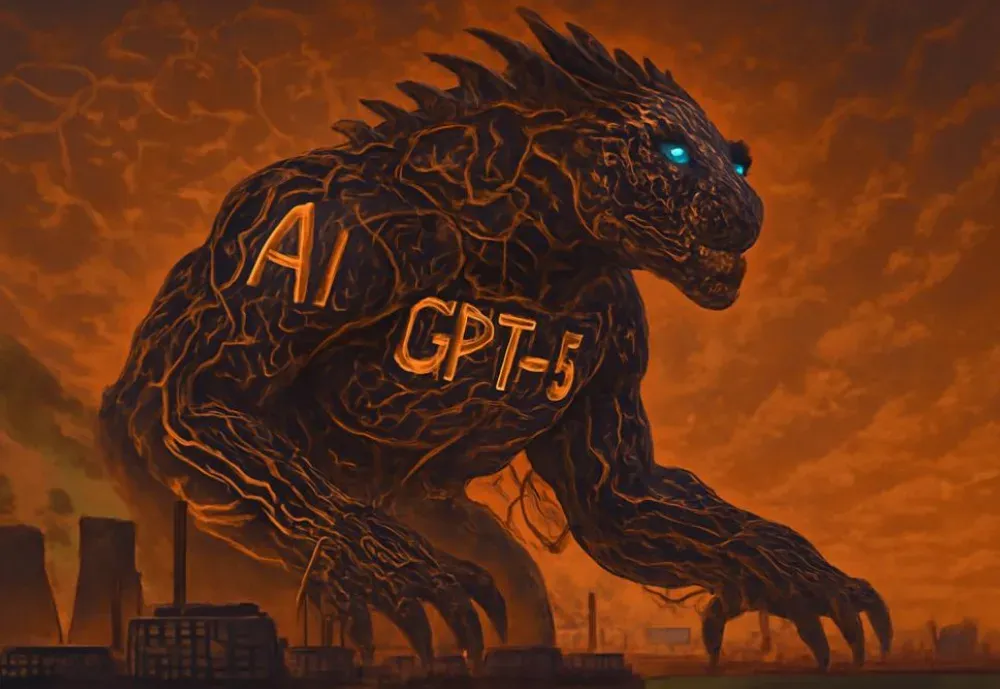
GPT-5的日耗电量可达45吉瓦时,这一数值相当于150万美国家庭的每日用电需求,或2至3座核反应堆的输出量。
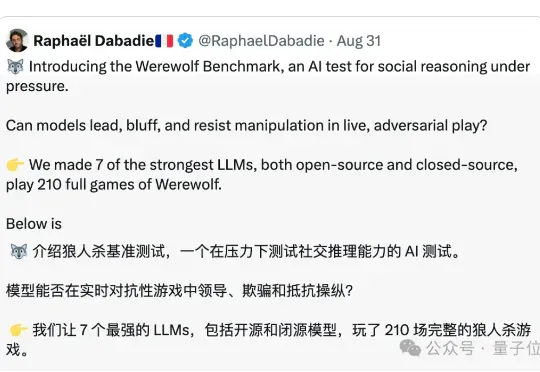
一群AI玩狼人杀,GPT-5断崖式领先,胜率达到了惊人的96.7%。 OpenAI的总裁格雷格·布罗克曼转发了这样的一个基准测试:让7个强大的LLMs,包括开源和闭源,玩了210场完整的狼人杀。
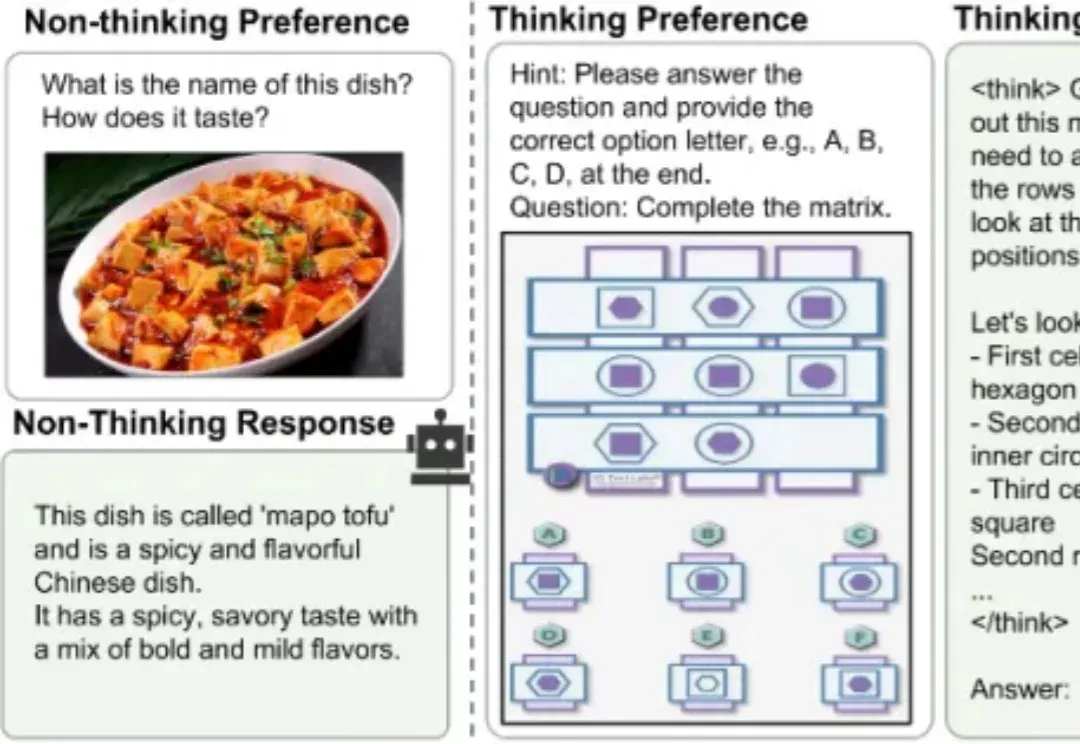
当前,业界顶尖的大模型正竞相挑战“过度思考”的难题,即无论问题简单与否,它们都采用 “always-on thinking” 的详细推理模式。无论是像 DeepSeek-V3.1 这种依赖混合推理架构提供需用户“手动”介入的快慢思考切换,还是如 GPT-5 那样通过依赖庞大而高成本的“专家路由”机制提供的自适应思考切换。