GPT-5.5彻底击穿300个黑客评测任务,仅需5000万Token!(在新窗口打开)
GPT-5.5 把进攻性网络安全最难的 7 个基准全部打穿,92.4% 正确率,评估体系直接失灵。AI 黑客能力每 6 个月翻一倍,而衡量它有多危险的尺子,已经先被干碎了。
共 619 篇
GPT-5.5 把进攻性网络安全最难的 7 个基准全部打穿,92.4% 正确率,评估体系直接失灵。AI 黑客能力每 6 个月翻一倍,而衡量它有多危险的尺子,已经先被干碎了。
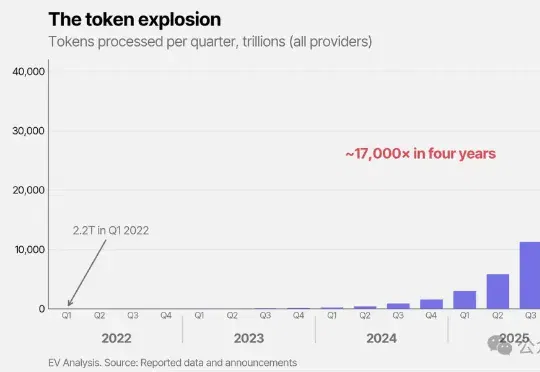
Epoch AI刚刚发布的《梯度更新》报告,做了一件简单粗暴的事:把全球所有Blackwell芯片能处理的Token数量算出来,再和实际需求一比。结论只有一个字——不够。
过往几个月,我们通过 MiMo Orbit、百万亿 Token 创造者激励计划等活动,让更多人有机会体验 MiMo ,并解决真实的问题——这是 MiMo 在规模化应用道路上的第一步。 而现在,随着底层
最近,GPT-5.6泄露了!150万Token+神级极简UI,下月紧急上线,奥特曼的「超级智能体」要掀翻整个硅谷?6月AI大战,已经提前爆发了。
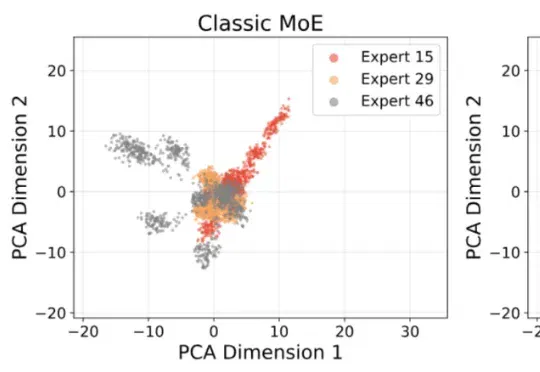
近年来,Mixture-of-Experts(MoE)已经成为大模型扩展的重要架构之一。相比稠密 Transformer,MoE 通过稀疏激活机制,在每个 token 上只调用少量专家,从而在控制计算成本的同时扩大模型容量。然而,一个长期存在的问题是:专家越多,并不意味着专家真的学得越 “专”。
奥赛级科学推理,一定要从更大的通用模型开始吗?
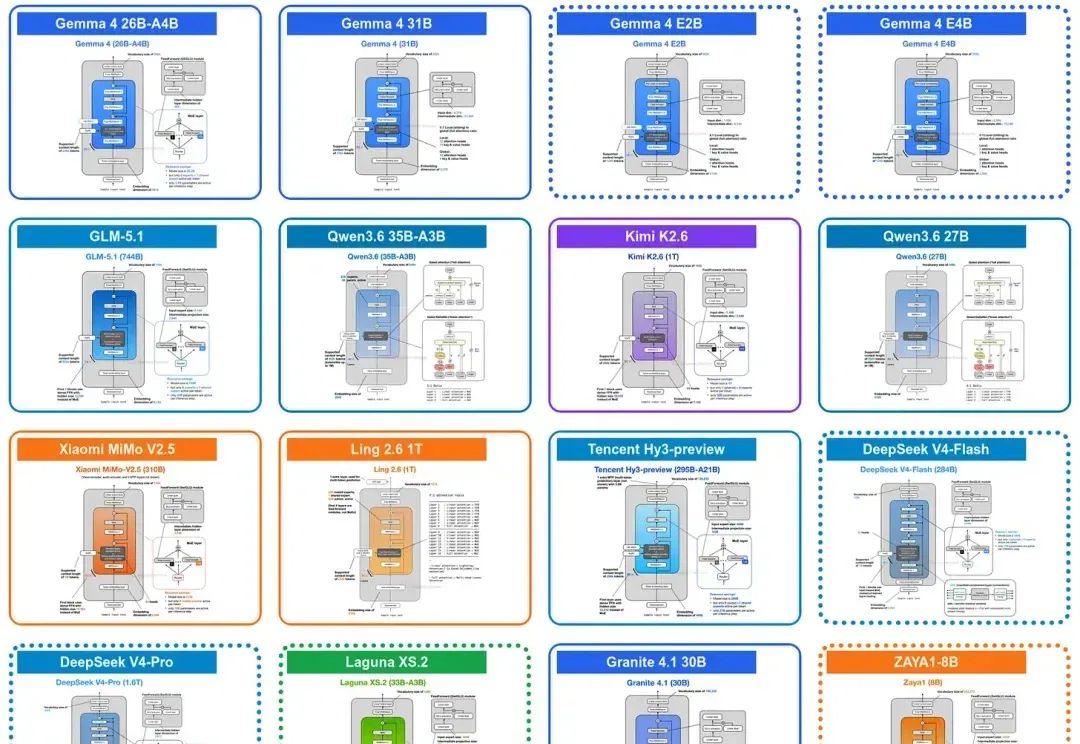
过去一段时间,很多人对大模型都有一个明显感受:token 总是不够用。
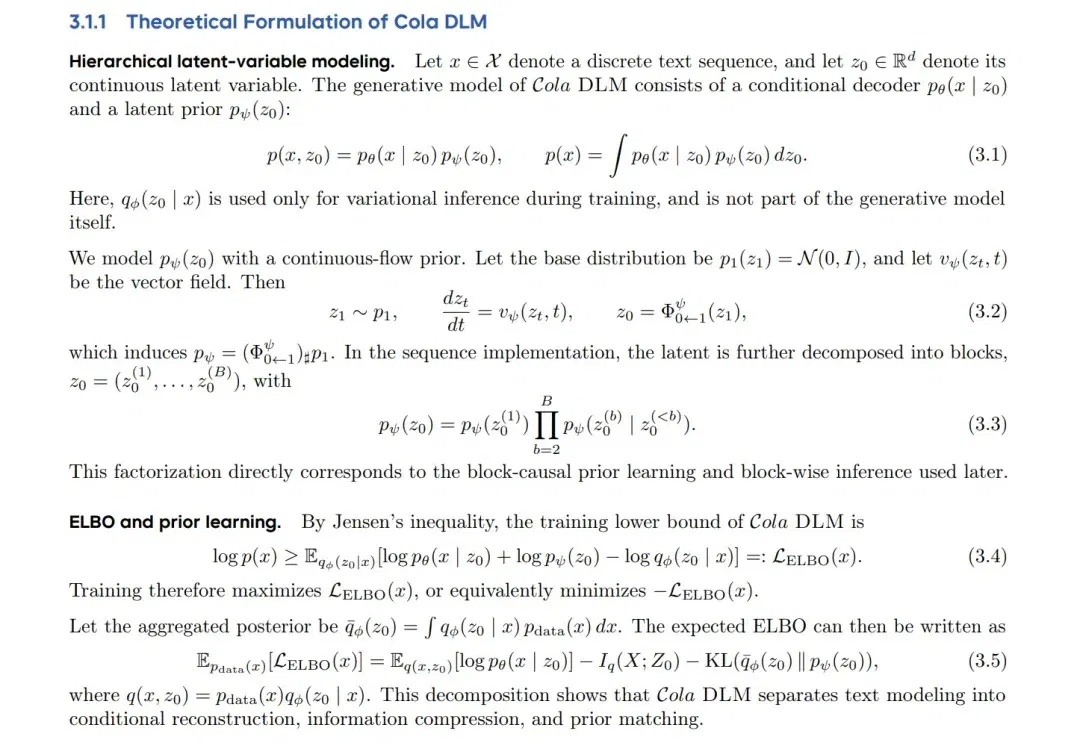
大语言模型真的只能走“预测下一个token”的路子吗?
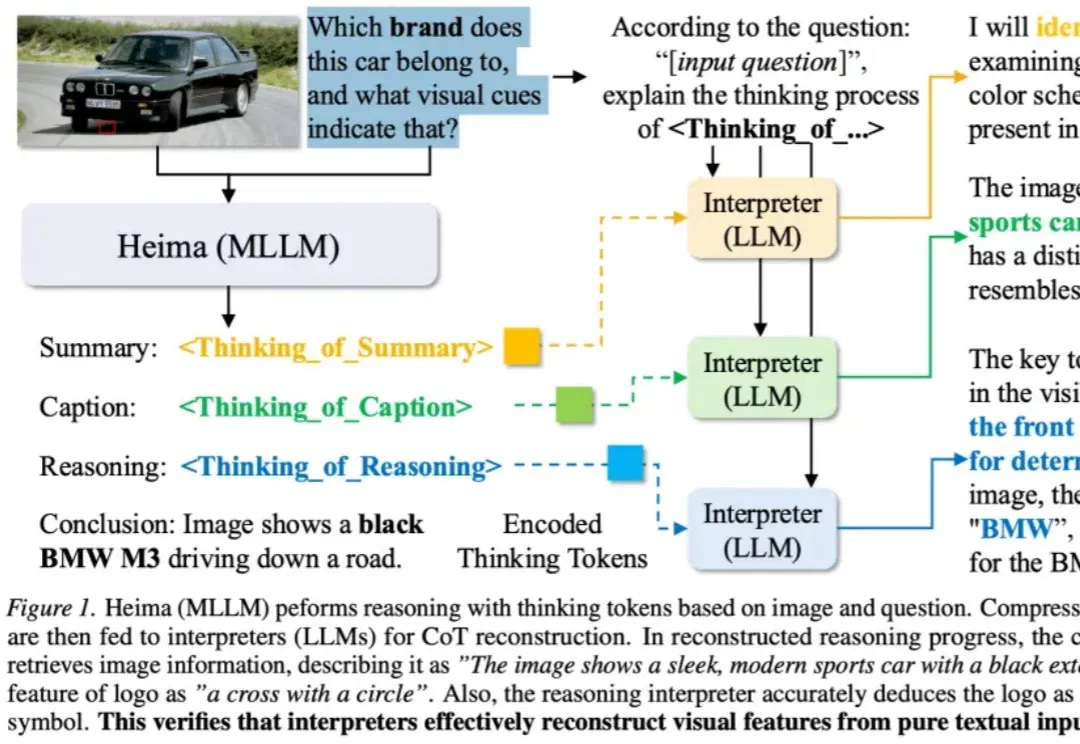
近年来,Chain-of-Thought(CoT)推理已经成为提升大语言模型和多模态大语言模型复杂问题求解能力的重要技术路径。
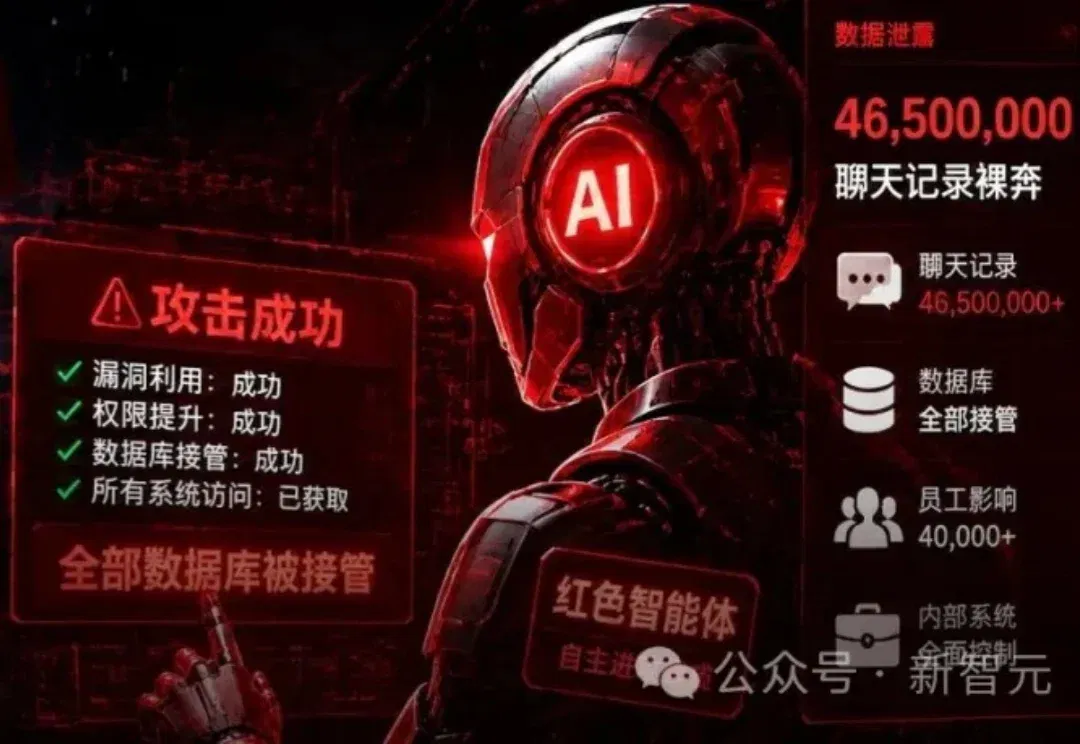
20美元Token费,2小时运行,AI智能体没问任何人,自主翻遍互联网,选中麦肯锡,把它的「数字大脑」Lilli彻底攻破。4650万条战略聊天记录、72万份核心文件、95条系统提示词……全部明文读写权限到手。AI震惊地说出了「WOW!」