奥特曼谈下一代 GPT:万级 Agent 数学实验与开放安排(在新窗口打开)
奥特曼在 ADIPEC 回顾约1万个 Agent 参与的数学研究,并预告下一代 GPT。文章同时梳理研究人员设题、调配资源、整合结果与形式化验证的流程;具体型号、发布时间,以及公众能否调用同等协作系统,尚未公布。
共 1881 篇
奥特曼在 ADIPEC 回顾约1万个 Agent 参与的数学研究,并预告下一代 GPT。文章同时梳理研究人员设题、调配资源、整合结果与形式化验证的流程;具体型号、发布时间,以及公众能否调用同等协作系统,尚未公布。
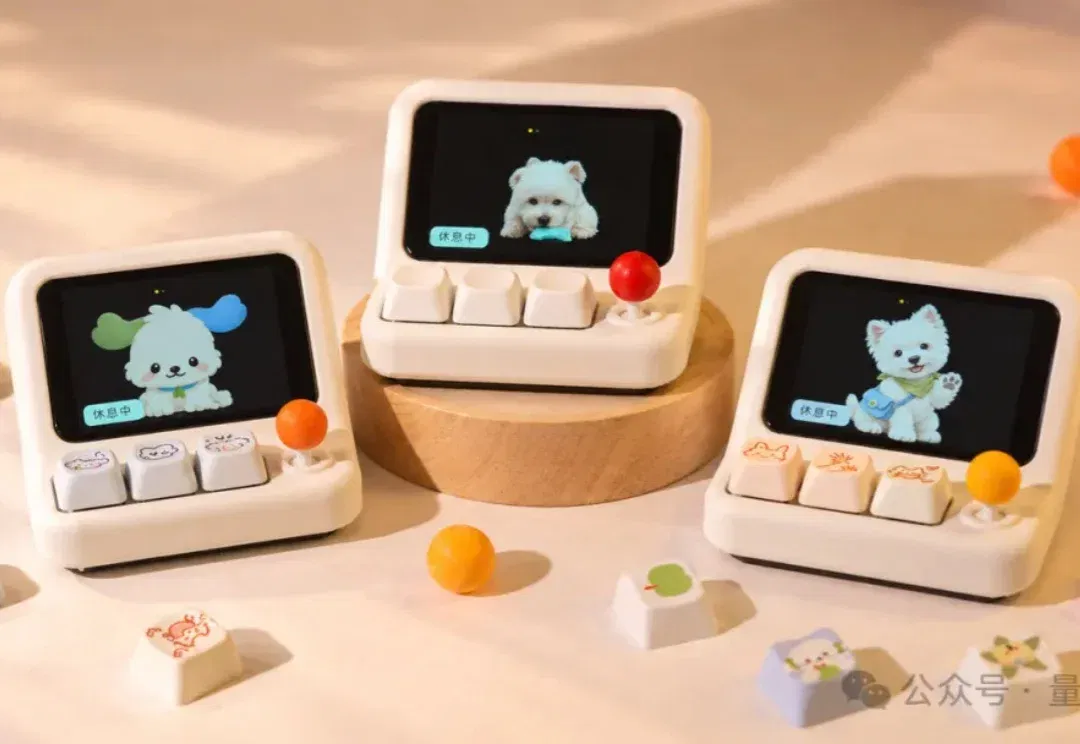
小米团队介绍开源硬件 HachimoDock,支持语音分派电脑 Agent 任务、显示执行状态、自定义桌宠与组件,并探索通过 Miloco 联动智能家居。项目公开软件、物料与装配资料;文中约150元指DIY硬件成本,实际采购和使用费用需另计。
吴泽栋从 AI 心理产品转向 Loopa,尝试用个人 Agent 串联美国市场的生活服务与跨应用任务,并将执行流程沉淀为可复用的 Mini-app。团队介绍长程任务的运行环境与重试设计,计划以订阅和高价值服务佣金覆盖成本,部分交易链路仍在内测。
ScholarCatalyst 汇集184位作者对207项研究的灵感标注,评测系统能否找回真正有启发的论文。主实验最佳检索器的前20篇召回率约48%,多轮 Agent 搜索未超过它;候选覆盖和排序是重要瓶颈,这一指标也不能等同整体科研能力。
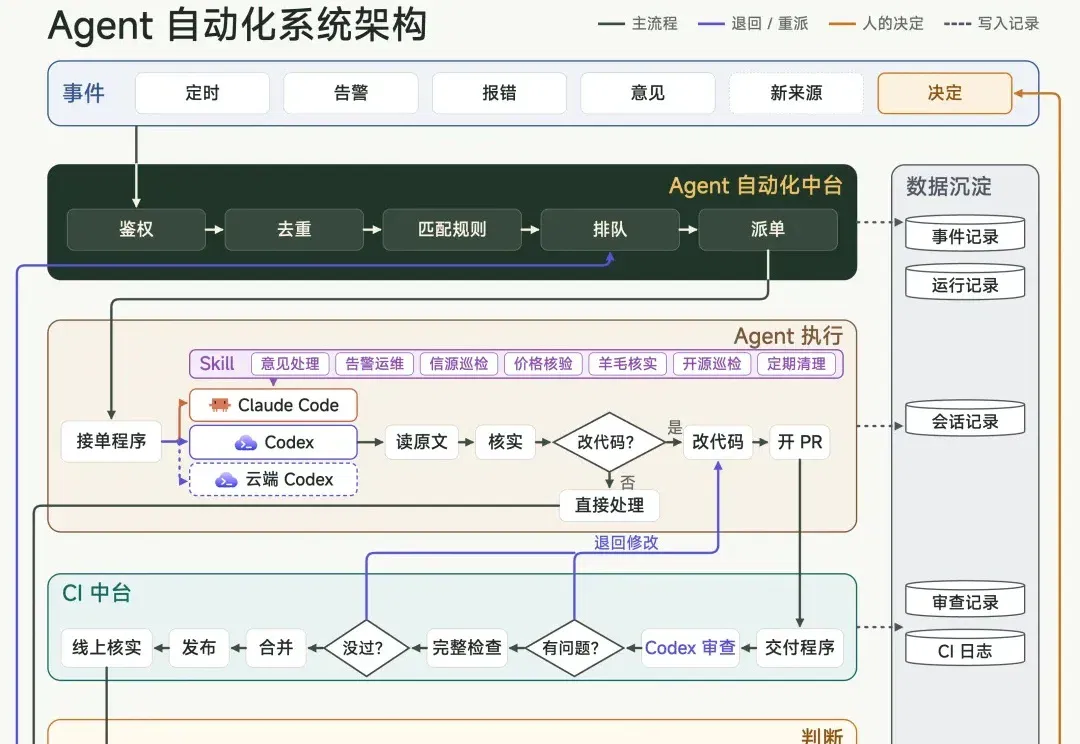
卡兹克分享个人搭建 Agent 自动化系统的经验:用事件和规则分派任务,在本地 Mac 上执行,通过独立的审查、测试与发布流程交付,再由飞书卡片承接需要人工决策的事项。文章同时讨论模型分工、成本和权限边界。
文章将 DeepSeek 的 Super-agent 设计与 AFK 团队 Comma 的公开工程记录作比较,讨论主会话路由、独立 Worker、执行环境分离及多端交互。提前实现和未来产品形态属于报道及团队判断,实际系统仍需检验长期上下文、权限隔离与任务协作。
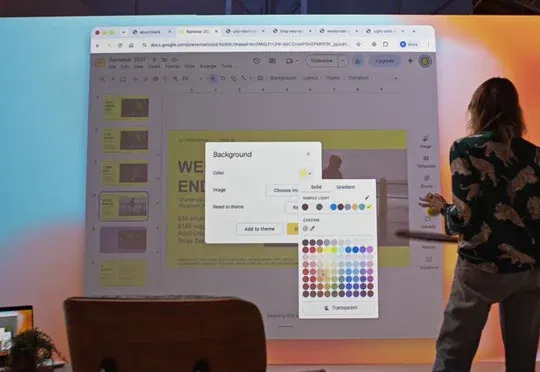
硅谷101邀请 Agent、机器人和 AI 制药方向的三位从业者,讨论 GPT-6 Astra 带来的能力变化与落地限制。观点并不完全一致:长程执行、电脑操作和三维理解有进展,实时控制、幻觉、实验方案及湿实验反馈仍是瓶颈;演示、榜单与真正可部署能力需要分别判断。
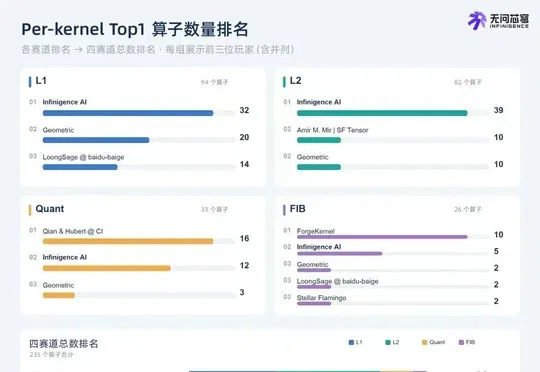
这篇技术报道进一步讨论算子优化 Agent 如何利用隔离评测、Skills 和共享记忆迭代,并呈现 GPU 排队与工作流演化的观察:个体为减少等待而延长占用,可能降低整体效率。文章将资源调度与有效反馈速度联系起来,局部优化仍需端到端验证才能反哺基础设施。
水哥AIGC 用数据科普和新书口播两个案例,演示 Fotor Agent 的脚本、分镜、动效修改及导出流程,并说明如何在保留原片的基础上叠加信息层。案例效果来自作者的操作记录。
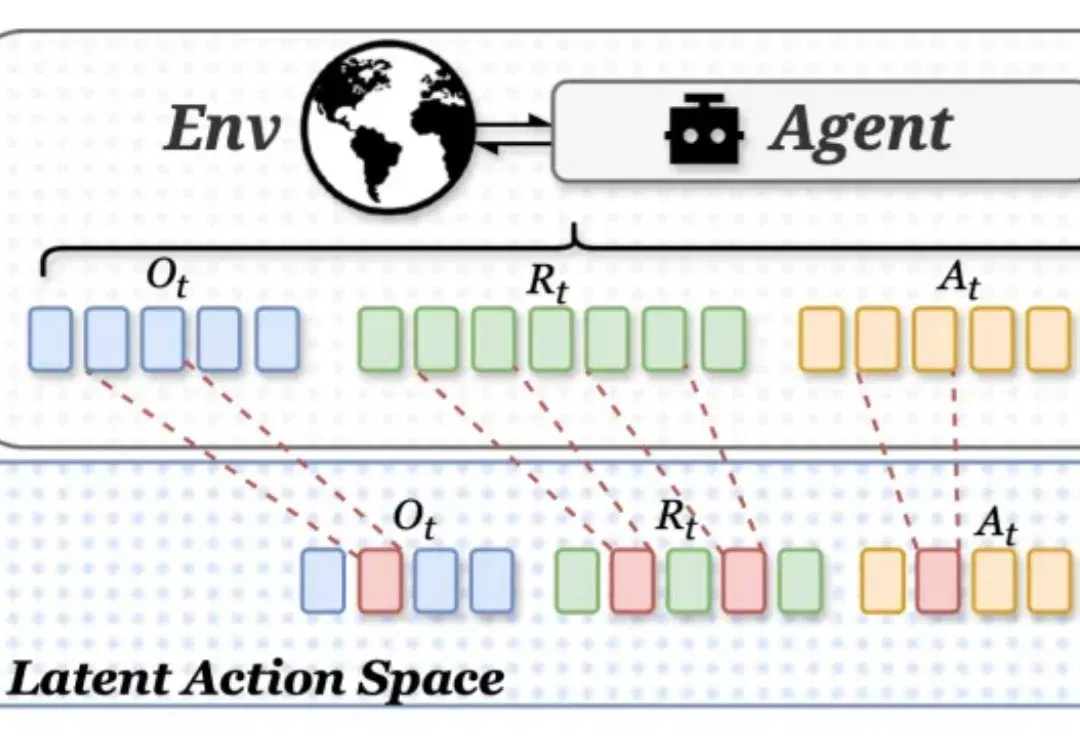
LAR 将重复、稳定的多步动作表示为可学习的潜在动作,尝试减少 Agent 完成任务所需的生成步骤。原文介绍动作词表学习、轨迹蒸馏与实验结果,并讨论过度压缩具体参数可能损害任务表现的边界。