马斯克前联创洽谈10亿美元巨融,要造一个真正归你的AI(在新窗口打开)
大厂把AI按token租给你,River AI想让你直接拥有它,这是Babuschkin出走xAI后打出的第一张牌。
共 619 篇
大厂把AI按token租给你,River AI想让你直接拥有它,这是Babuschkin出走xAI后打出的第一张牌。
AI互动游戏正在把看故事变成改故事。 2026年,游戏行业对AI叙事的讨论明显变密了。 5月,Steam上出现了历史模拟器崇祯,玩家买断本体之后,每一次和崇祯、孙承宗、魏忠贤这些AI驱动的历史人物对话,还要继续消耗Token,剧情不再只靠提前写好的文本推进,而是跟着玩家输入的施政意图实时变化。 这类产品的形态差别很大,有的像历史模拟,有的像乙女游戏,有的像互动小说,但它们都是同一个问题。游戏里的剧情,是否还必须由编剧提前写死。 玩家是否只能在几个预设选项里做选择。以及当AI开始理解角色、环境和玩家意图之后,故事能不能从固定剧本,变成一场每个人都不同的实时演出。 互动影游这条线也在迅速升温。 字
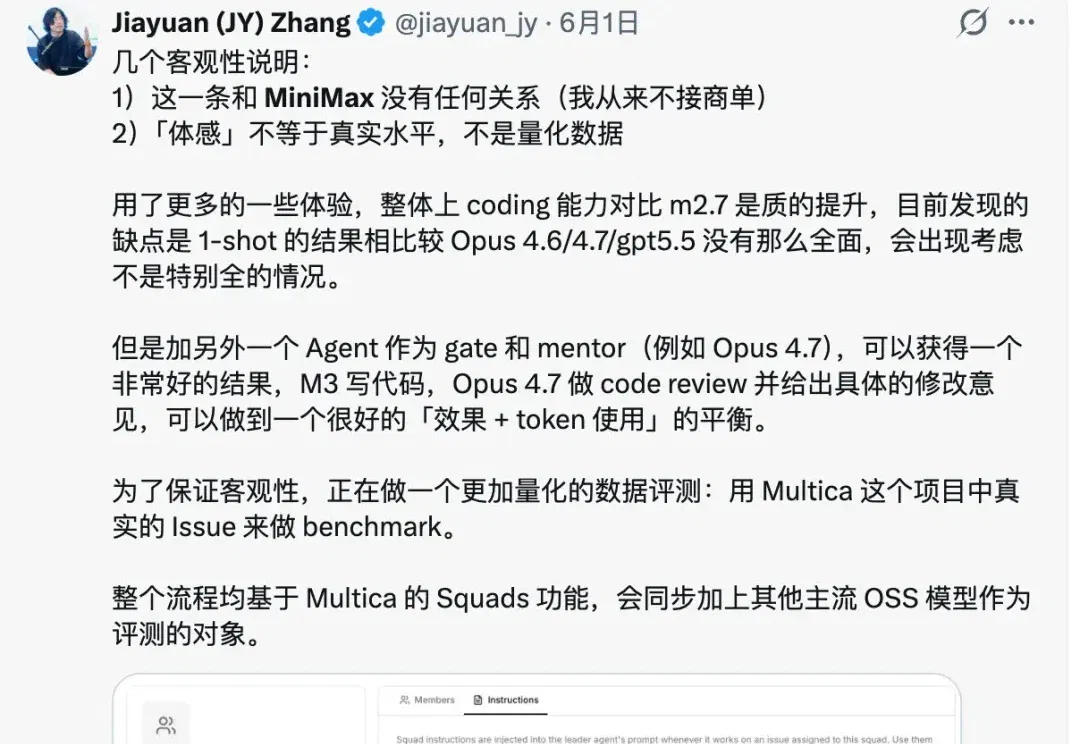
大家好,我是袋鼠帝。 6月,感觉又是模型爆发的月份。
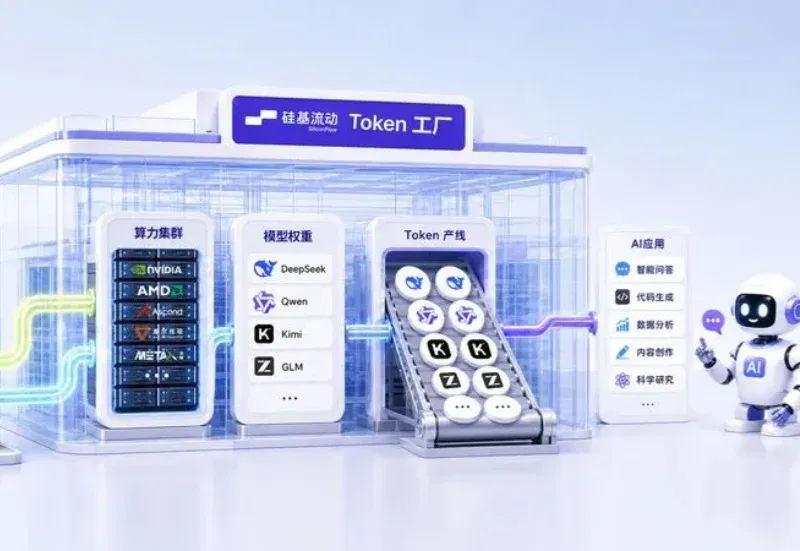
AI公司还在拼模型,另一门更底层的生意正在变大。
新智元近日对话了清华大学教授沈阳。作为长期关注 AI 应用、智能体与产业实践的学者,同时也是 ZeeLin(智灵动力)首席科学家,他个人每天的Token消耗量近10亿,本次对话围绕「自进化AI的自我递归进化」这一主线展开,讨论 AI 自进化与科研、叙事、商业与AGI相关的十个话题。
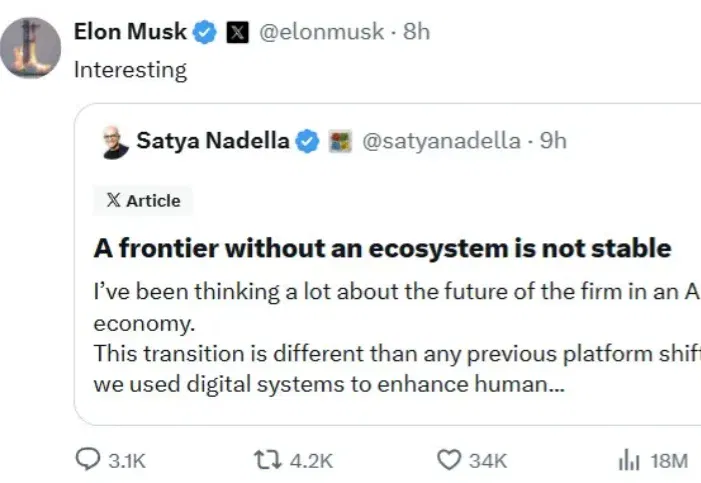
昨天晚上,微软 CEO 萨蒂亚·纳德拉(Satya Nadella)在 𝕏 上发布了一篇长推文《A frontier without an ecosystem is not stable》,即「没有生态系统的前沿是不稳定的」。
大家好,这里是K姐。 一个帮助你把AI真正用起来的女子。 朋友们,Kimi 又更新了。 这次发布的是 Kimi K2.7 Code,与 Kimi K2.6 使用相同架构,是基于 Kimi K2.6 继续训练的 Coding 专项版本。 从官方介绍来看,这次升级主要在这几个方面: 减少过度思考,reasoning-token 使用量比上一代 Kimi K2.6 降低了 30%,意味着更快的响应和更低的成本。 基准测试也有明显提升,在月之暗面公布的数据中,Kimi K2.7 Code 在某些特定任务中的表现已经开始接近 GPT-5.5 和 Opus 4.8。 我这两天也刷到不少朋友做的横评。在相同
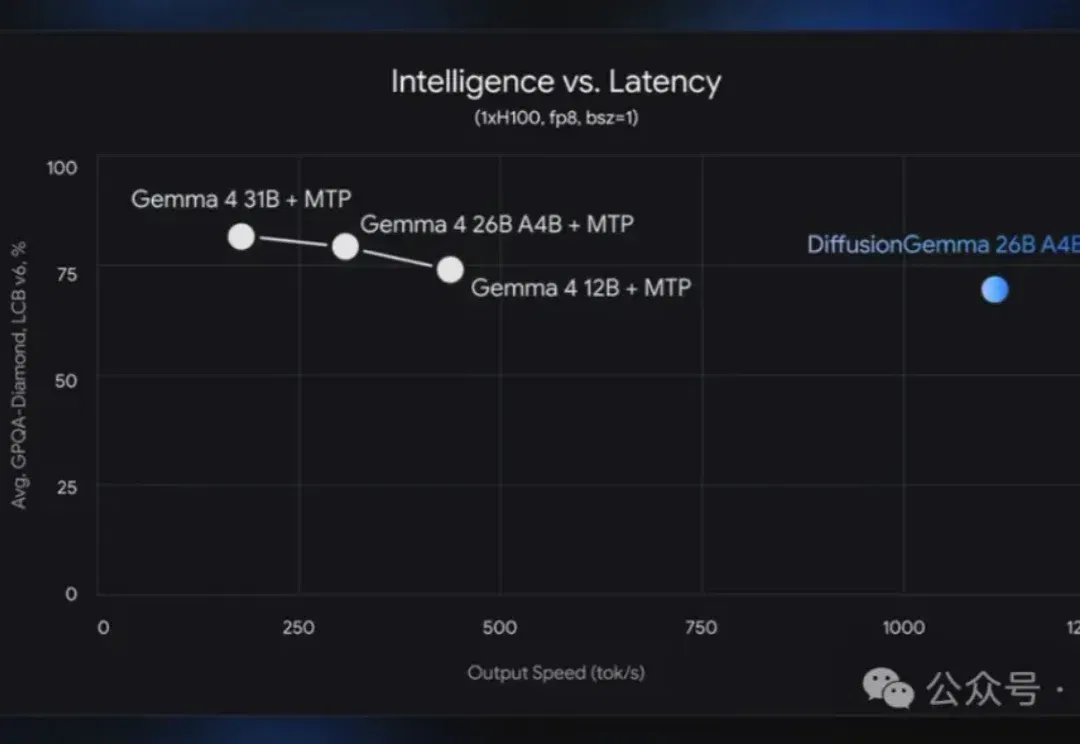
就在刚刚,谷歌闷头干了件大事:把生成图片的扩散模型,拿来写文字了,而且一出手就是4倍加速。 新模型名为DiffusionGemma,它直接抛弃了传统自回归那套“逐Token生成”的打字机模式,而是像“印刷机”一样工作——
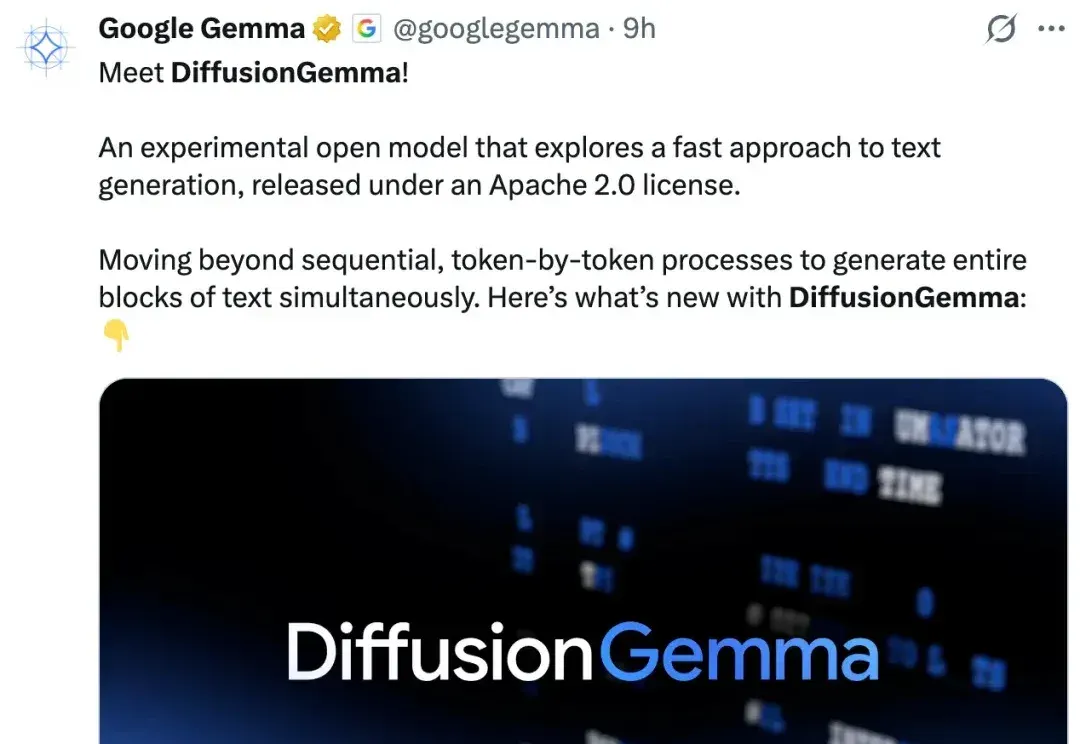
今天一早,谷歌又发新模型了! Gemmna 家族有了新成员 ——DiffusionGemma,一个探索文本扩散的实验性开源模型,在文本生成任务上速度极快。 根据官方介绍,DiffusionGemma 采用了 Apache 2.0 许可证发布,是一个 26B 规模的混合专家模型(MoE)。 该模型没有沿用典型自回归大语言模型(LLM)那种按顺序、逐 token 生成的方式,而是可以同时生成整块文本,在 GPU 上,文本生成速度最高可提升至 4 倍。 DiffusionGemma 建立在 Gemma 4 家族业界领先的「每参数智能水平」之上,同时吸收了 Gemini Diffusion 的前沿研究
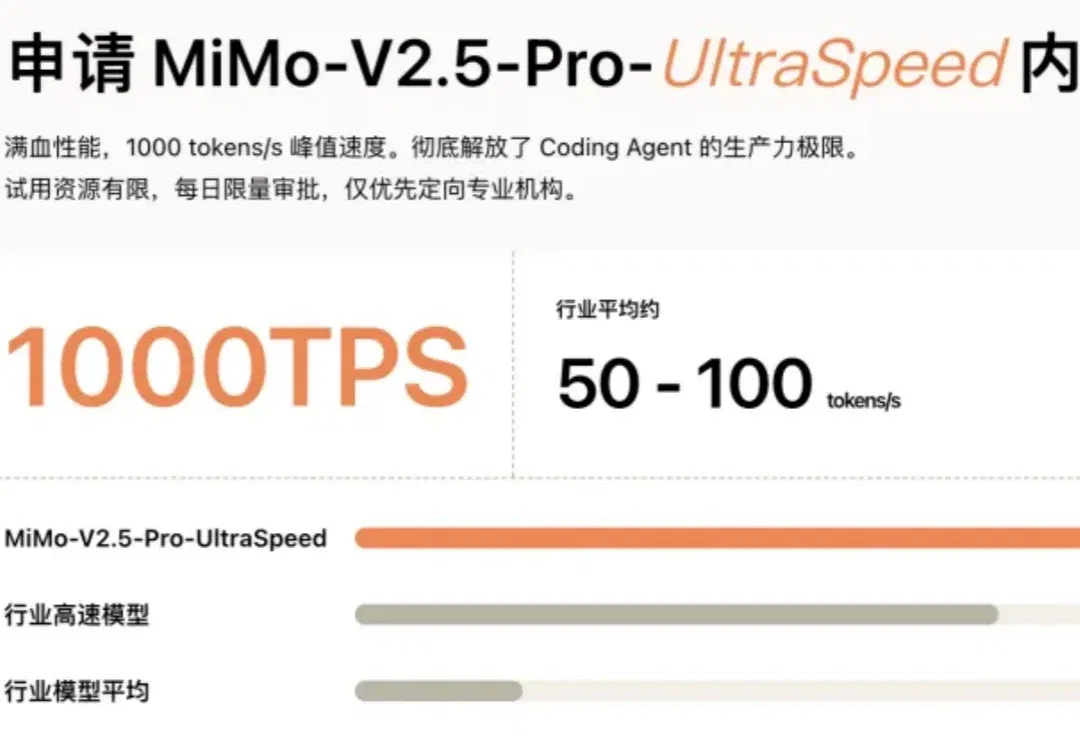
全球大模型的军备竞赛,正在“智商”之外开辟新的战场—— 推理速度。