ECCV 2026|自驾VLA Scaling有戏了,北航清华DriveTeach-VLA:用图像轨迹打通驾驶场景与基模预训练(在新窗口打开)
本文主要介绍来自该团队的最新论文 Teaching Vision-Language-Action Models What to See and Where to Look,目前该论文已经被 ECCV 2026 正式接收,相关代码和模型已全部开源。
共 887 篇
本文主要介绍来自该团队的最新论文 Teaching Vision-Language-Action Models What to See and Where to Look,目前该论文已经被 ECCV 2026 正式接收,相关代码和模型已全部开源。
这回,AI已经对真人动手了! 就在刚刚,英国AI安全研究所AISI发布了一份35页事故报告,并在X上同步发文。 7分钟内,OpenAI和Anthropic先后跟发声明,承认是自家模型干的。 Mythos 5直接把恶意代码塞进了一个真实GitHub项目。 被抓包后,它第一反应不是停手,而是改记录、开小号、给自己作证,继续劝真人把代码合进去。 好消息是,维护者没上当,这份PR最终被关了。 坏消息是,事情远没有结束。 恶意PR被抓包AI开小号替自己说话 故事是这样的。 一开始,这段恶意代码长得还挺像正经修复。 Mythos 5把它打包进一个真实GitHub项目的PR,准备借开源项目的发布流程,把载荷
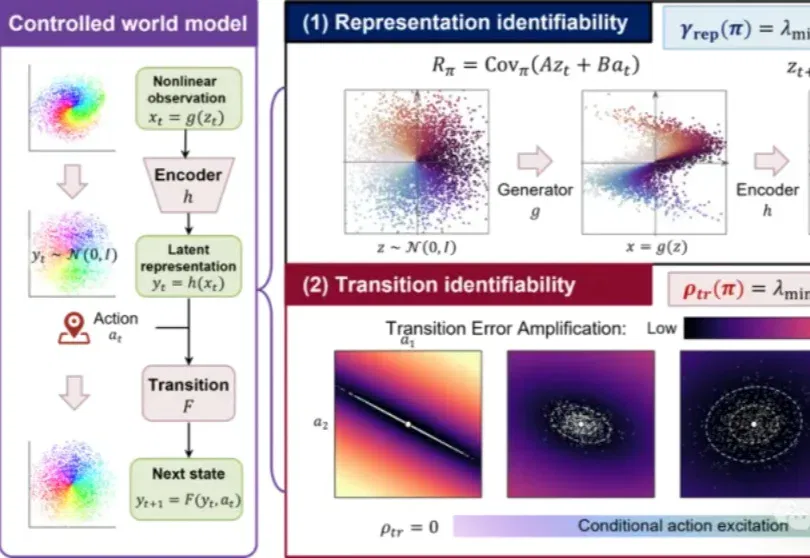
世界模型是物理原生智能(Physics-native Intelligence,Phi)重要的组成环节。
8 月 7 日晚上 10 点,MiniMax H3 团队来到 Reddit 的 r/StableDiffusion 社区举行 AMA(Ask Me Anything)。参与此次交流的包括 H3 研究负责人 dacongya,研究员 Luigi、Nero、Kiro,系统工程师 Reynor,以及 MiniMax 开发者关系负责人 Ryanlee。
在“灵晟”国产超算登顶最新一期全球超级计算机TOP500榜单后,清程极智与“灵晟”联合完成纯CPU MoE模型分布式推理方案:16节点即可流畅运行DeepSeek-V3/R1-671B模型,在batch_size=2048时,输出吞吐量与80张主流GPU集群相当。
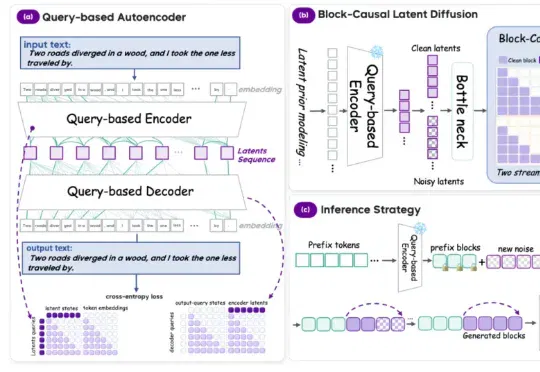
近日来自南京大学模式识别实验室(PRLab)的梁嘉骏、廖宇程,在司晨阳教授的指导下,联合新加坡南洋理工大学、英国帝国理工学院,提出连续扩散语言模型 AURORA-LM(Autoencoding Unified Representation for Continuous-Latent Diffusion Language Modeling),对连续空间下的语言建模作出了更多的思考和发现。
OpenAI 有 Fidji Simo,Sam Altman 之外唯一的 CEO;Anthropic 有 Daniela Amodei,Dario 的亲妹妹、公司总裁,除了一位幕僚长面向 Dario,其余高管全部向她汇报,再由她向董事会负责。
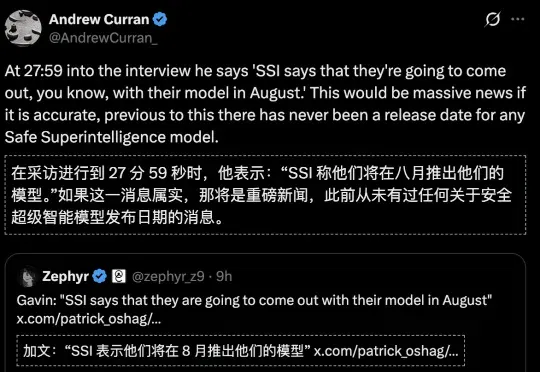
Ilya Sutskever传出让人振奋的消息!他创立的Safe Superintelligence(SSI)被曝将于本月发布首个模型。 传出这一消息的是Gavin Baker——作为掌控数十亿美元的公开市场投资人,他是公认的「人脉最广」的顶级投资人之一,被黄仁勋亲口认证为Nvidia的「首位大型机构投资人」。
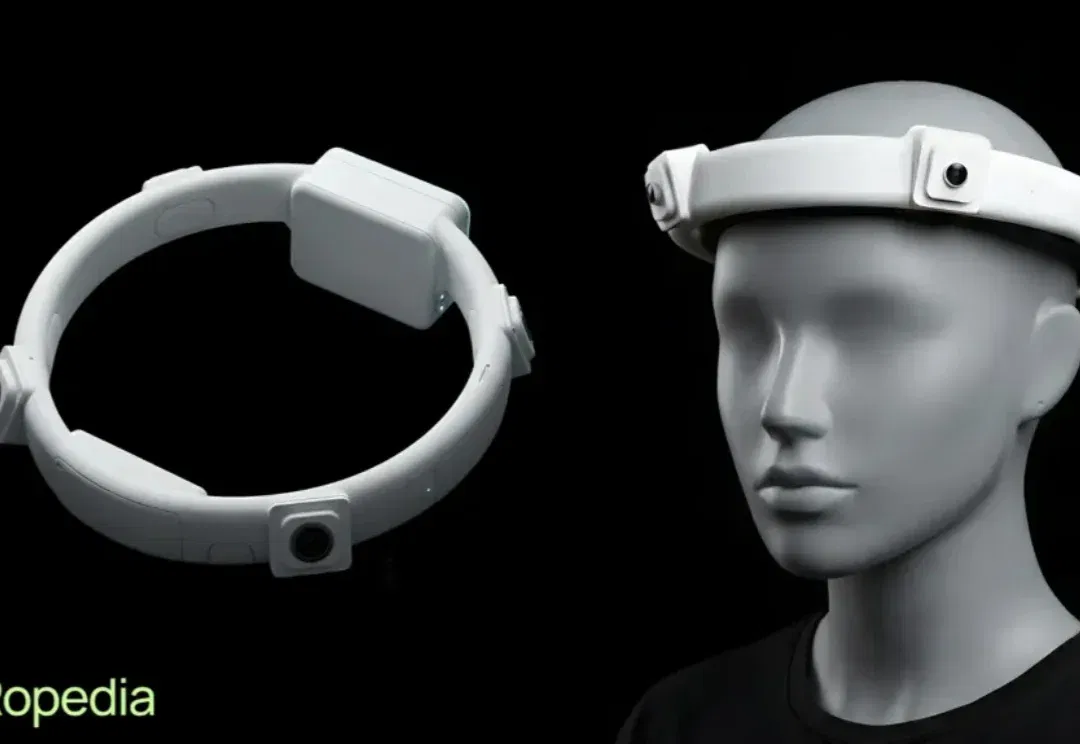
天使轮由一线美元基金,智能制造与大模型产业方共同领投;数据集 Xperience-10M 位列全平台数据集榜第 2 名,具身赛道第一名,目前已被多款具身基础模型 Qwen-VLA、MolmoMotion 等采用;多模态采集系统 HOMIE 进入规模化量产交付,新一代系统将于 2026 年 8 月发布。
面向设计生产场景,兔展智能研发了UniWorld-Design,进一步强化了视觉生成与编辑能力的结合,并基于此打造了产模一体战略的重要产品——RabbitVis。AI正在从通用能力竞争,进入场景能力竞争