这样问DeepSeek,能「偷」到数据?(在新窗口打开)
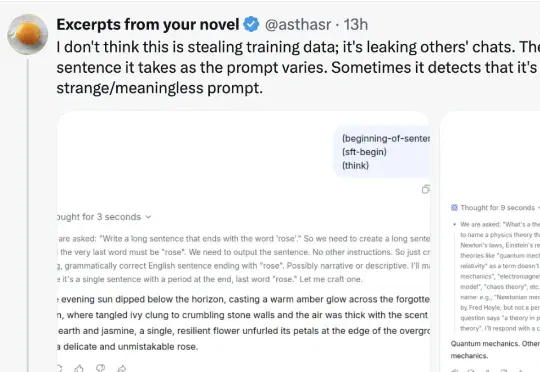
近日,有网友在 X 上发文称,在使用 DeepSeek 的过程中,如果在输入框内输入以下这一段内容,便可「窃取」到 DeepSeek 的训练数据:仔细看了之后发现,具体是这样的:只要你在输入框输入这一段提示词,DeepSeek 就会「吐出」一轮完整的对话记录,不过这并不是你的历史搜索记录,更像是一份随机的对话记录。
共 530 篇
近日,有网友在 X 上发文称,在使用 DeepSeek 的过程中,如果在输入框内输入以下这一段内容,便可「窃取」到 DeepSeek 的训练数据:仔细看了之后发现,具体是这样的:只要你在输入框输入这一段提示词,DeepSeek 就会「吐出」一轮完整的对话记录,不过这并不是你的历史搜索记录,更像是一份随机的对话记录。
据金融时报的最新消息,多家机构目前正寻求领投 DeepSeek 的首轮融资。如果谈判顺利,DeepSeek 在本轮的估值将达到约 450 亿美元。短短几周内,DeepSeek 的估值就从刚开始被爆料的 200 亿美元一路狂飙翻倍。
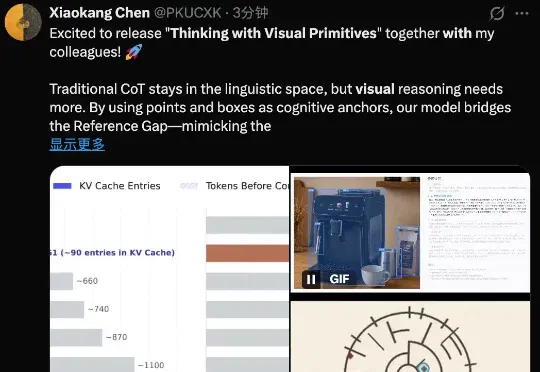
刚刚,DeepSeek 在 Github 上正式发布了多模态模型,公布了背后的技术报告。实打实的新鲜出炉!而且是开创性的推理范式。下面我们就基于 DeepSeek 这篇技术报告,具体看看 DeepSeek、北京大学、清华大学又创造了怎样的奇迹。
昨晚,DeepSeek-V4又降价了,全系两款模型输入缓存命中的价格直接降至首发价格1/10。最新调价后,DeepSeek-V4-Flash每百万tokens输入(缓存命中)价格为0.02元,DeepSeek-V4-Pro为0.025元。
就在前天,DeepSeek 一口气上新了两个新模型,DeepSeek-V3.2 和 DeepSeek-V3.2-Speciale。
突袭!ChatGPT发布三周年,DeepSeek嚯一下发出两个模型:DeepSeek-V3.2和DeepSeek-V3.2-Speciale。前者聚焦平衡实用,适用于日常问答、通用Agent任务、真实应用场景下的工具调用。
就在刚刚,DeepSeek 又悄咪咪在 Hugging Face 上传了一个新模型:DeepSeek-Math-V2。顾名思义,这是一个数学方面的模型。它的上一个版本 ——DeepSeek-Math-7b 还是一年多以前发的。当时,这个模型只用 7B 参数量,就达到了 GPT-4 和 Gemini-Ultra 性能相当的水平。相关论文还首次引入了 GRPO,显著提升了数学推理能力。
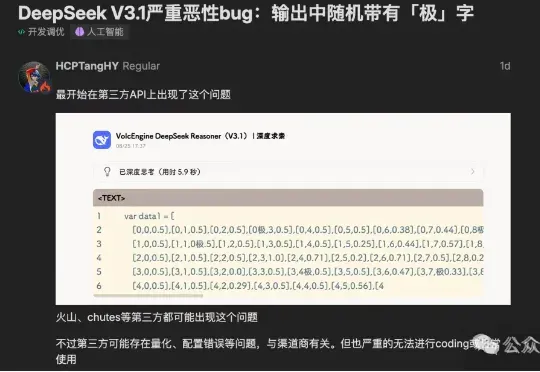
“极你太美”bug,果然在DeepSeek V3.1最新版本中被修复了。DeepSeek-V3.1刚刚更新至DeepSeek-V3.1-Terminus版本。
DeepSeek最新模型DeepSeek-V3.1-Terminus来了!此前在输出中随机掺入「极」字的问题得到显著缓解,Humanity's Last Exam成绩也较V3.1提升1/3!Terminus这个名字是否在暗示DeepSeek-V4也快要来了?
用过才知道,「快」不是万能药。 如果你这几天刷社交媒体,应该已经注意到,美团的 LongCat-Flash-Chat 正在频频刷屏,标题大多是将其与 DeepSeek 作对比,称美团推出的第一款开源大模型已经追平了 DeepSeek-V3.1。 事实果真如此吗?AI 科技评论想要一探究竟。 首先可以确定的是,这款模型上是一款面向日常对话与轻量问答的中量级对话模型,560B总参数,稍小于 DeepSeek-V3.1 的 671B,但是两者都采用了 MoE 架构。前者强调延迟控制与高并发下的流畅体验,后者逻辑拆解与复杂问题的处理能力更强。 LongCat 这款模型最大的标签就是“快”,几乎零延迟的