答对了却没看图?EASE给多模态RLVR装上「视线校正器」(在新窗口打开)
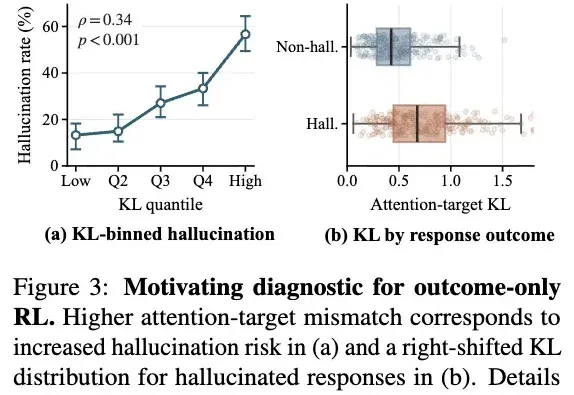
强化学习与可验证奖励(RLVR)已成为提升视觉语言模型(VLM)推理能力的标配手段。但一个隐蔽的问题始终存在:最终答案的奖励信号,只告诉模型「答对了没有」,却从不告诉它「答案应该从图像的哪个区域得出」。答对,可能是因为真的看懂了图,也可能只是语言先验的捷径、数据集的偏差,甚至是一次幸运的瞎猜。
共 68 篇
强化学习与可验证奖励(RLVR)已成为提升视觉语言模型(VLM)推理能力的标配手段。但一个隐蔽的问题始终存在:最终答案的奖励信号,只告诉模型「答对了没有」,却从不告诉它「答案应该从图像的哪个区域得出」。答对,可能是因为真的看懂了图,也可能只是语言先验的捷径、数据集的偏差,甚至是一次幸运的瞎猜。
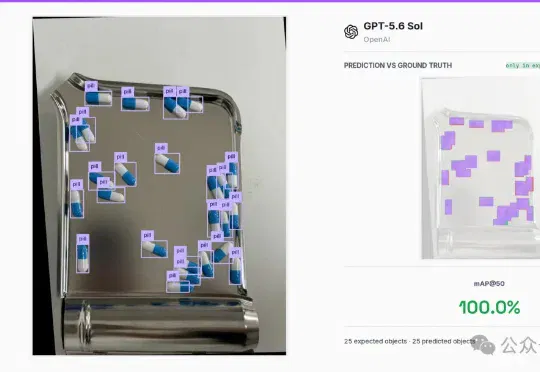
最近,第三方视觉评测机构Roboflow,把GPT-5.6 「全家桶」拖进自家VLM基准跑了一圈。测试的内容,都是最实在的活儿:找东西、数东西、认字、抽信息。仅在目标检测这项,上一代GPT-5.5只拿到13.8分。这个分数,在视觉模型圈里基本等于交白卷。
智东西获悉,OpenAI前研究员田永龙(Yonglong Tian)已确认于近期加入腾讯大语言模型部,后续将参与VLM(视觉语言模型)相关研发。在OpenAI期间,田永龙曾参与GPT-5的研发工作。加入OpenAI之前,他在Google Research和DeepMind长期从事视觉表征学习和对比学习等方向研究,对后续视觉模型以及多模态表征学习的发展产生了广泛影响。
豆包大模型2.1 Pro正式发布。但字节这次没有像某些厂商那样疯狂堆参数、刷榜单,而是把刀锋对准了一个更硬核的方向:让AI真正能“干活” 。作为本次大会发布的主力模型,豆包2.1 Pro 在 Coding(编程)、Agent(智能体)、VLM(视觉语言模型)三大核心方向实现能力跃升,多项评测表现优于Claude Opus 4.6
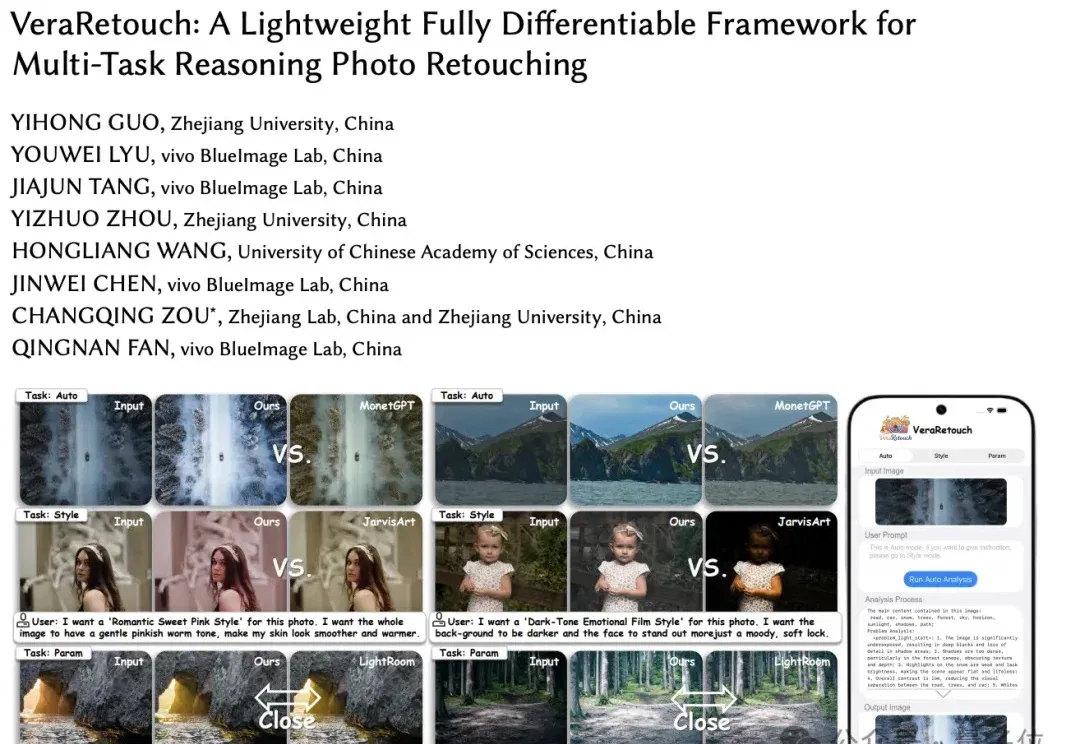
如今手机拍照已成日常,后期修图是提升照片质感的关键。
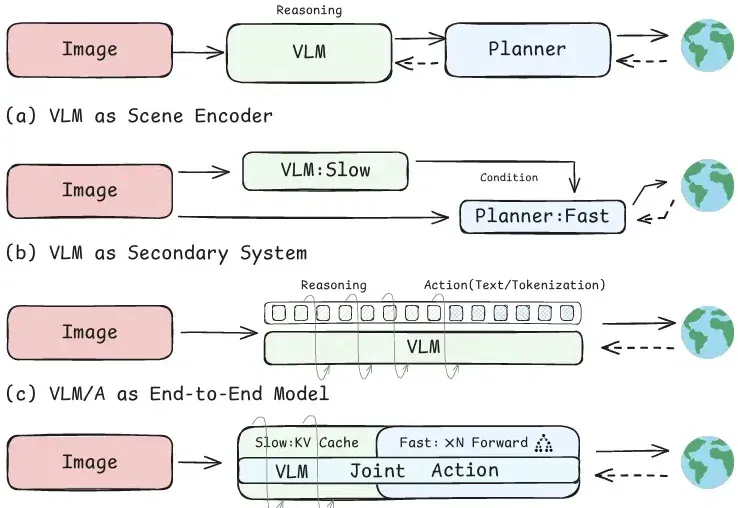
大模型进入自动驾驶后,最直接的价值在于场景理解。它可以识别前车是否准备并线、行人是否可能横穿、施工区域是否会影响车道,也可以分析复杂路口中的让行关系。
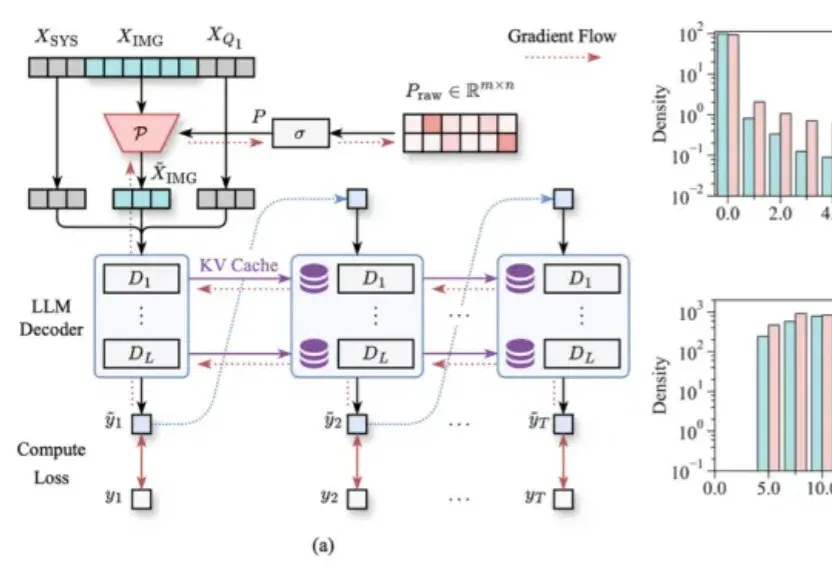
多轮视觉问答,正在成为LVLM推理效率的“照妖镜”。
基于视觉语言模型(VLM)的多智能体系统(MAS)正成为复杂多模态协作的核心方案,却被一个致命痛点死死卡住:多智能体视觉幻觉滚雪球——单个智能体的视觉误判通过纯文本信息流逐级放大,早期细微错误最终演变成系统性崩溃。
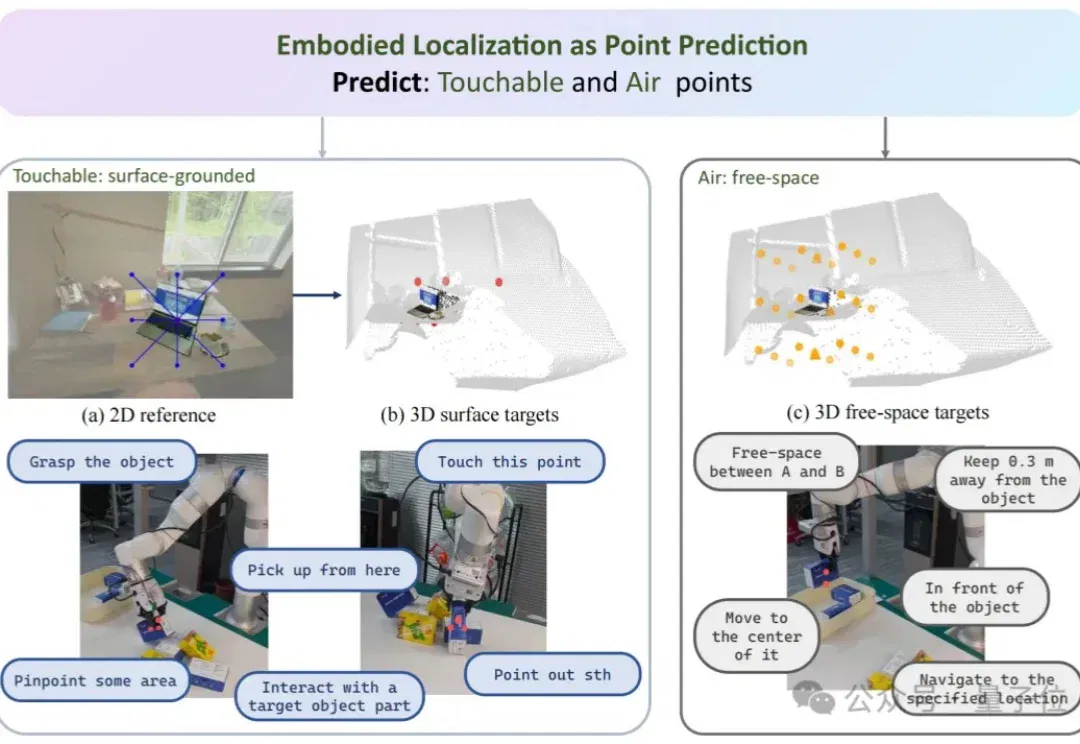
机器人能认出杯子,却看不懂杯口朝哪、离自己多远、该抓哪里。
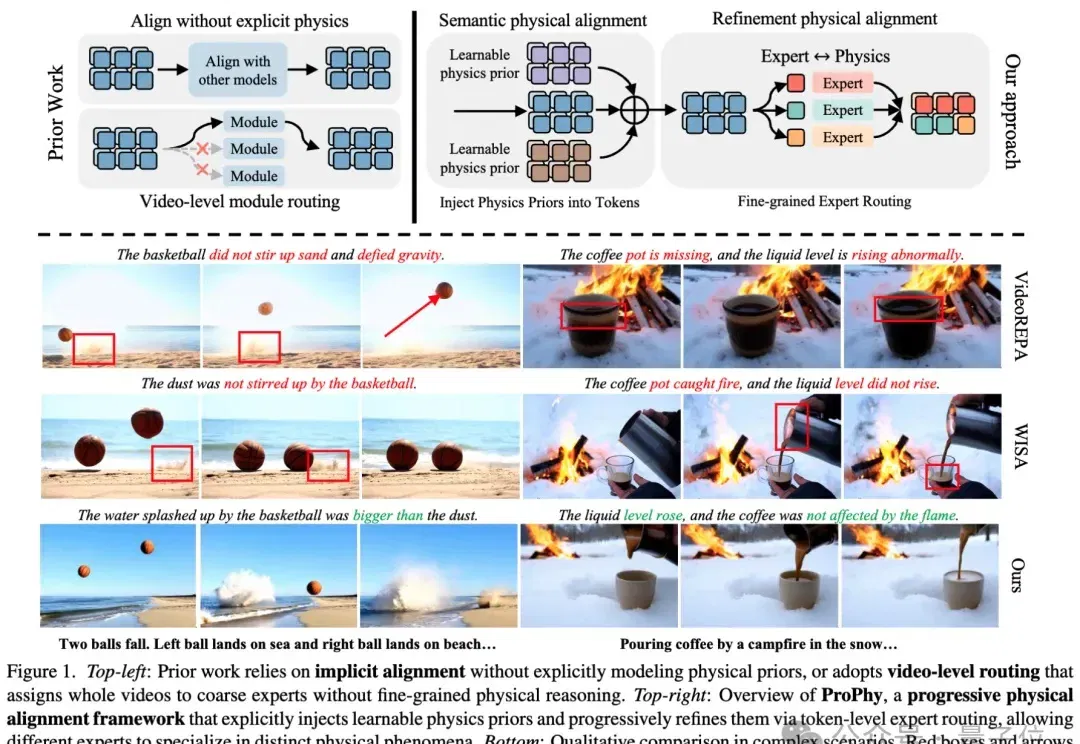
当人们谈到“世界模型”(World Models)时,很多人会首先想到近年来迅速发展的生成式视频模型。