具身智能空间视觉死穴,终于被最新顶会彻底解决!(在新窗口打开)
VLA 大模型看似强大,却被一个致命弱点扼住喉咙——相机稍微挪动几毫米,操作成功率就能暴跌一半。招商局先进技术研究院下属实验室提出新的移动数据范式,首次在真实机器人系统上证明:让相机动起来采集数据,就能以极低成本破解 VLA 的空间泛化瓶颈,且效果普适于多种主流架构。被一个致命弱点扼住喉咙——相机稍微挪动几毫米,操作成功率就能暴跌一半。
共 122 篇
VLA 大模型看似强大,却被一个致命弱点扼住喉咙——相机稍微挪动几毫米,操作成功率就能暴跌一半。招商局先进技术研究院下属实验室提出新的移动数据范式,首次在真实机器人系统上证明:让相机动起来采集数据,就能以极低成本破解 VLA 的空间泛化瓶颈,且效果普适于多种主流架构。被一个致命弱点扼住喉咙——相机稍微挪动几毫米,操作成功率就能暴跌一半。
最近《在超市后门抽烟的二人》这部剧挺火的,尤其是里面的音乐我很喜欢,所以就想着做一个真人版音乐短片,正好发现美图旗下的 MVLAND 上线了创意画布模式,接入 Seedance2.0、可灵、HappyHorse 等顶尖视频生成模型。
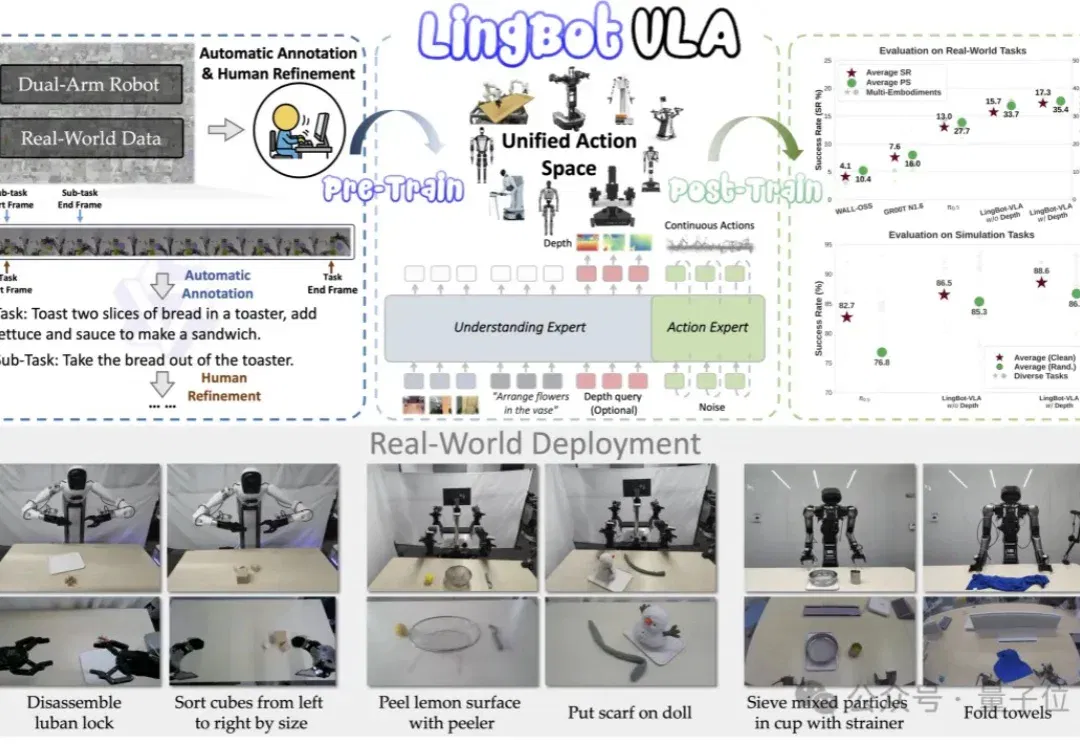
就在刚刚,蚂蚁集团旗下具身智能公司灵波科技传出新动作—— 全面开源其具身基座模型LingBot-VLA的真机后训练工具链。
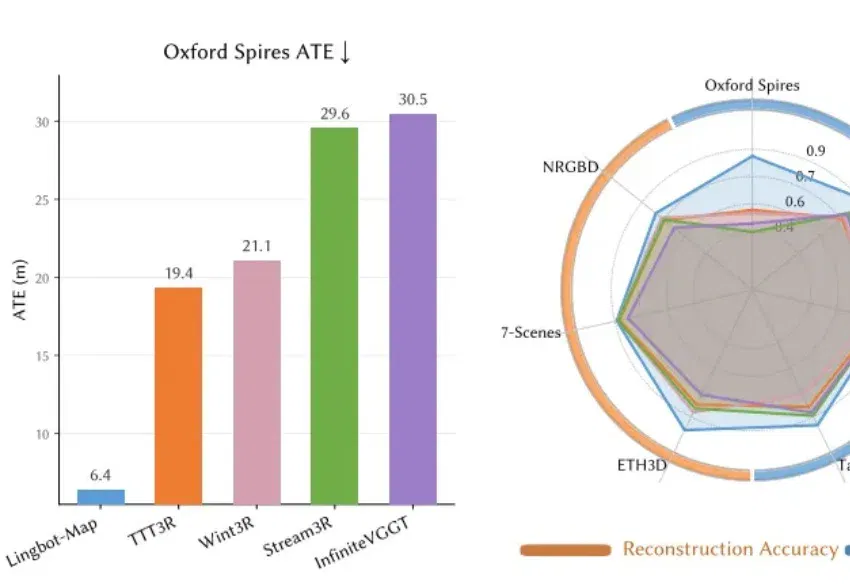
蚂蚁灵波,下了盘大棋。 今年 1 月,蚂蚁灵波一口气开源了 4 款大模型,包括高精度空间感知模型 LingBot-Depth、具身大模型 LingBot-VLA 与具身世界模型 LingBot-VA,以及世界模型 LingBot-World。 其中,LingBot-Depth 负责从图像中估算深度、感知空间距离,LingBot-World 负责对环境进行模拟和理解,LingBot-VLA/VA 负责机器人的决策和动作控制。 这四款模型「各司其职」,分别覆盖感知底层、环境理解和行动输出,但中间一直缺少一个关键环节,就是如何把连续的感知数据实时构建成稳定的三维空间模型,让后续模块有据可依。 现在,
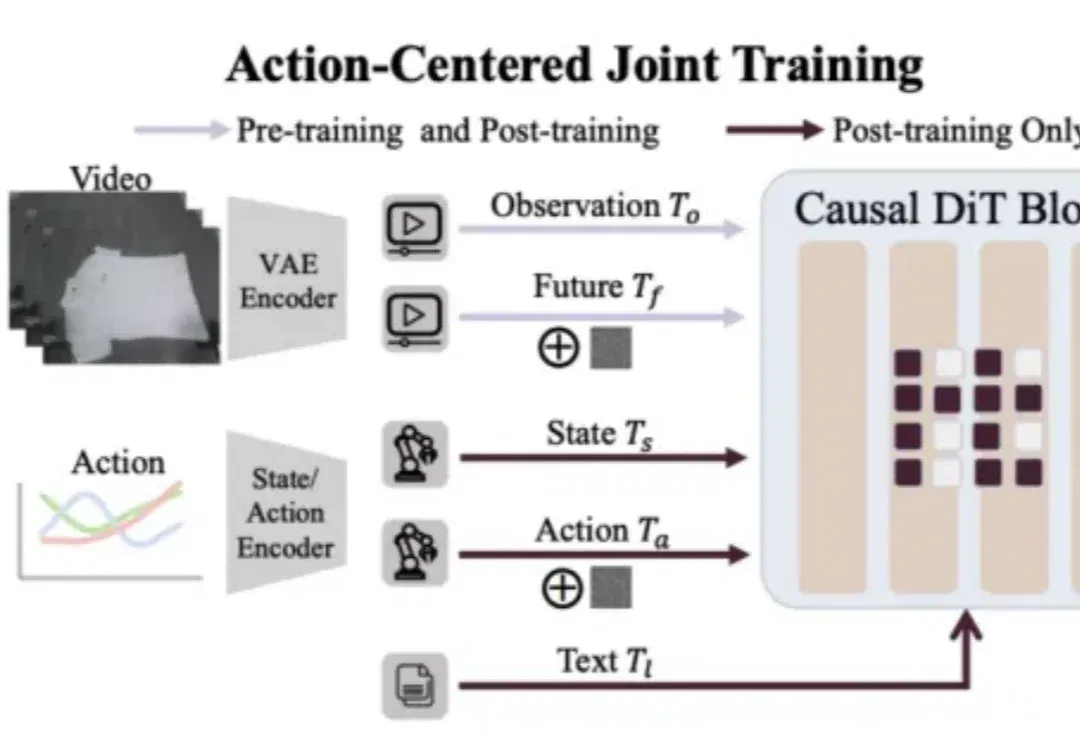
最近,具身智能圈被 Generalist CEO 的一篇长文《Going Beyond World Models & VLAs》刷屏。文章抛出了一个看似振聋发聩的观点:目标远比工具标签更重要。与其陷入 “我们到底是在做 VLA(视觉 - 语言 - 动作模型)还是世界模型(World Model)” 的教条之争,不如回归本源:让机器高效、准确地作用于物理世界。
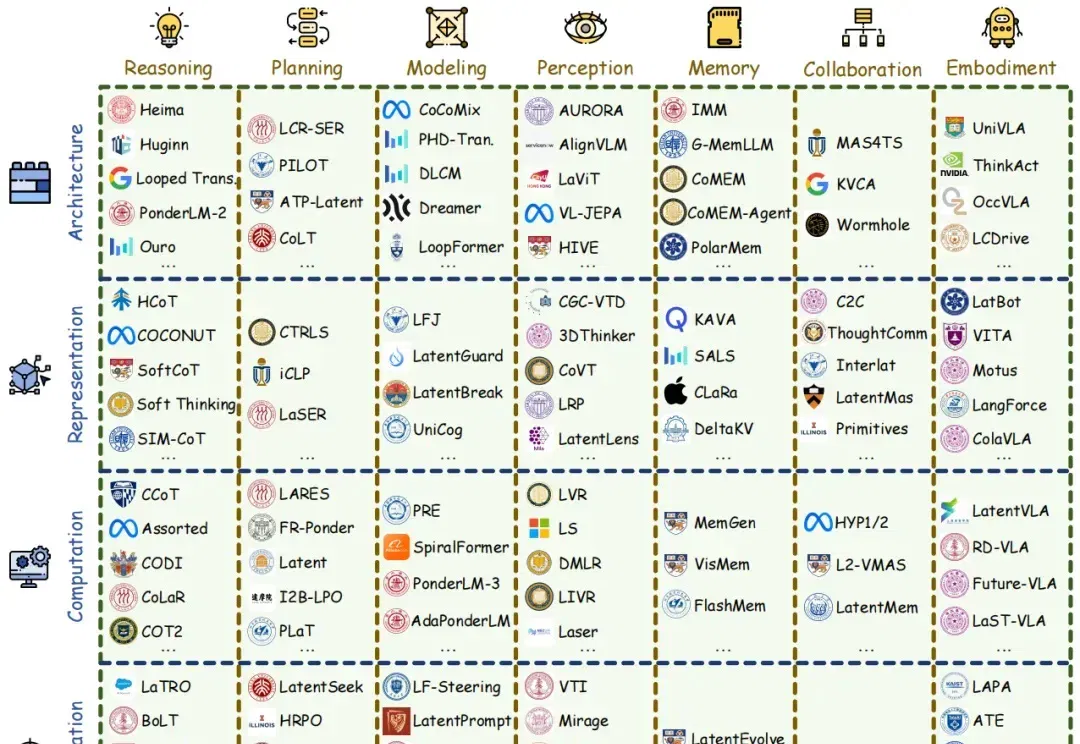
从 2024 年底的关于潜在空间的早期探索,再到 2025 年底和 2026 年初的相关研究爆发,潜空间范式正在彻底重塑大模型 (LLMs, VLMs, VLAs 等延伸模型) 的底层设计逻辑。
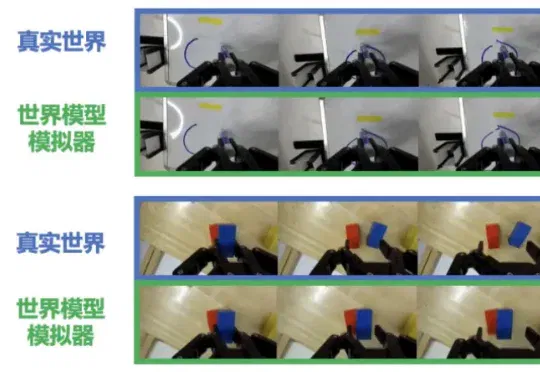
机器之心编辑部 整个具身智能领域都在探索世界模型的实用化路径。这个被寄予厚望的「数字模拟器」,本应成为机器人训练的核心工具,却因物理保真度低等问题成为「空中楼阁」。 去年年中,谷歌发布了 Genie-
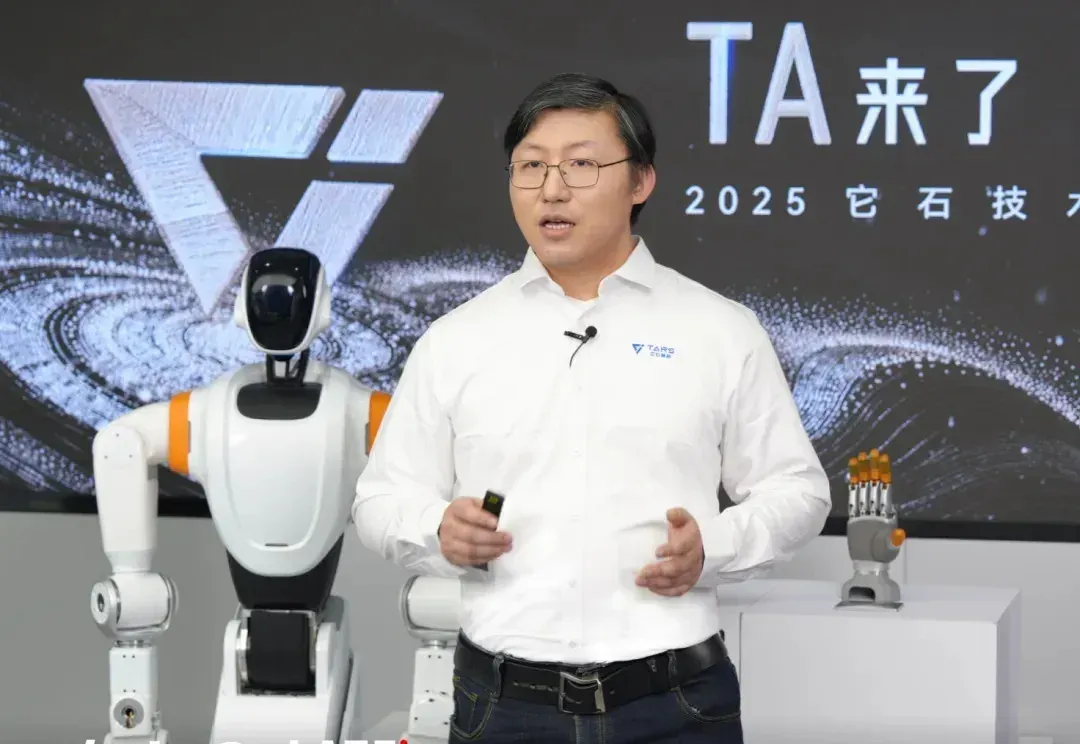
不做 VLA;不做遥操,以可穿戴设备采真实数据。
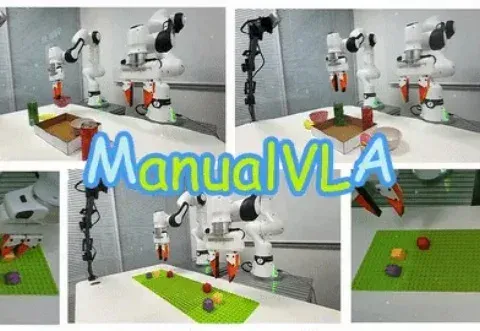
视觉–语言–动作(VLA)模型在机器人场景理解与操作上展现出较强的通用性,但在需要明确目标终态的长时序任务(如乐高搭建、物体重排)中,仍难以兼顾高层规划与精细操控。
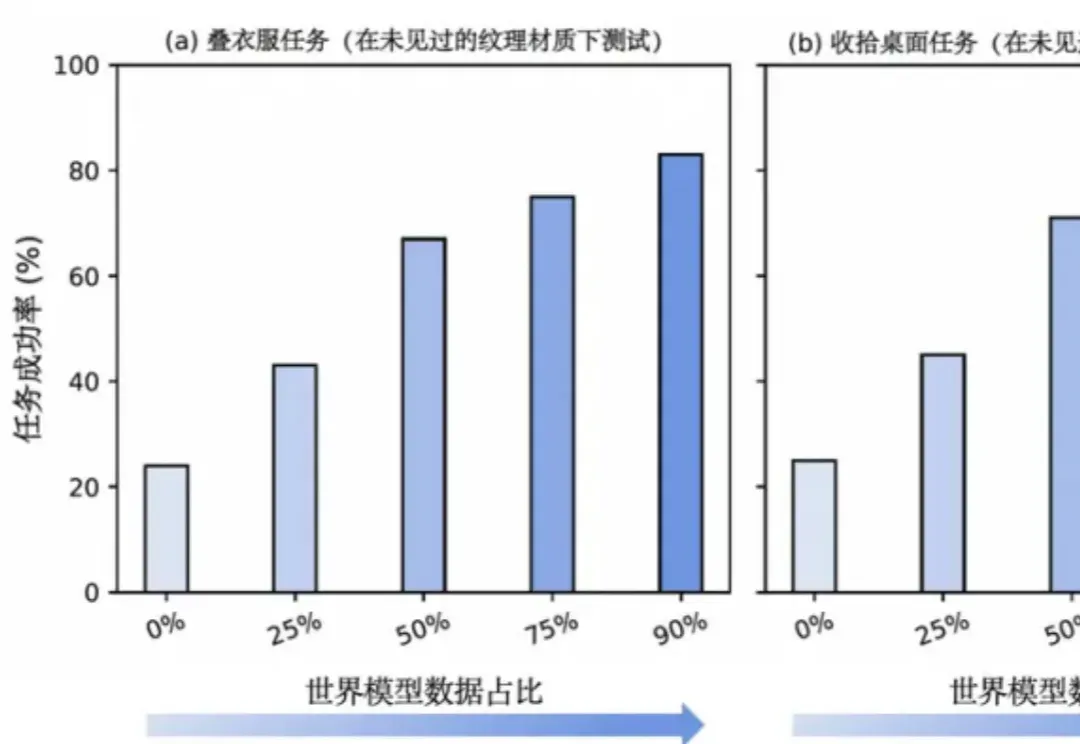
VLA模型性能暴涨300%,背后训练数据还首次实现90%由世界模型生成。