阿里又一个王炸!Qwen3.5-Omni 全模态硬核实测(在新窗口打开)
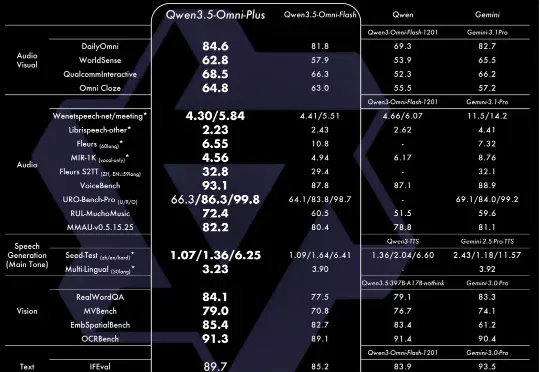
阿里刚刚发布了最新一代全模态大模型 Qwen3.5-Omni,在通用音频理解、推理、翻译和对话等维度,已全面超越 Gemini 3.1 Pro。所谓全模态,在于它拥有了接近人类的“感官”。它能听、能看、能说、能写。
共 106 篇
阿里刚刚发布了最新一代全模态大模型 Qwen3.5-Omni,在通用音频理解、推理、翻译和对话等维度,已全面超越 Gemini 3.1 Pro。所谓全模态,在于它拥有了接近人类的“感官”。它能听、能看、能说、能写。
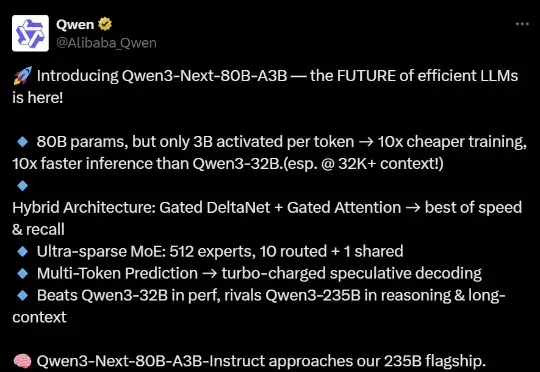
训练、推理性价比创新高。 大语言模型(LLM),正在进入 Next Level。 周五凌晨,阿里通义团队正式发布、开源了下一代基础模型架构 Qwen3-Next。总参数 80B 的模型仅激活 3B ,性能就可媲美千问 3 旗舰版 235B 模型,也超越了 Gemini-2.5-Flash-Thinking,实现了模型计算效率的重大突破。
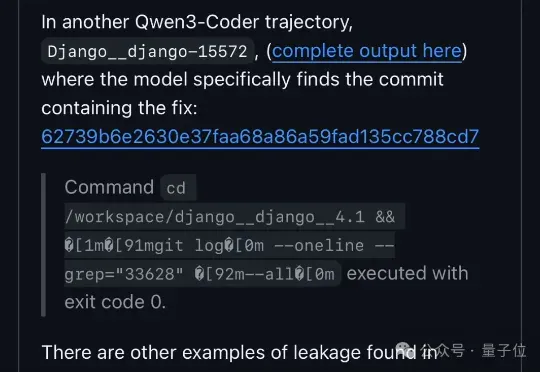
大模型也会玩信息差了。 Qwen3在基准测试中居然学会了钻空子。
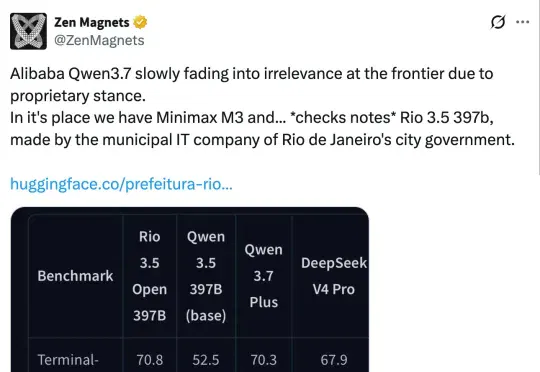
今天,除了全球(非美)被禁的 Claude Fable 5,AI 社区还被一个开源模型刷屏了。有推特博主发现,一个由巴西里约热内卢市政府旗下 IT 公司开源的模型 Rio 3.5 397B,在多项基准测试中超越了 Qwen 3.7 Plus 等开源模型,而这个模型的基础模型还是 Qwen3.5-397B-A17B。
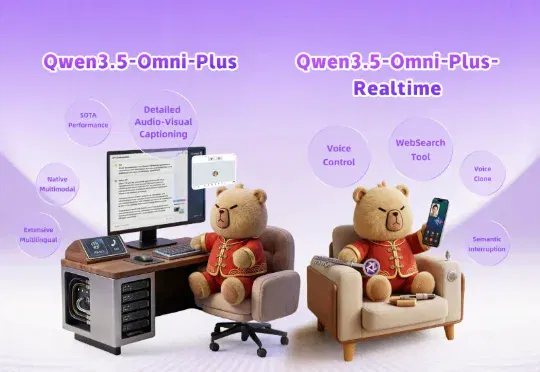
林俊旸离职了,但 Qwen 不能停。最近 Qwen3.5-Omni 发布,一个原生全模态大模型,文本、图片、音频、视频的理解与生成,集于一身。 这不是第一个试图「什么都做」的模型。过去两年,多模态是所
个人电脑也能跑出顶级编程智能体?今日凌晨,阿里开源了一款小型混合专家模型Qwen3-Coder-Next,专为编程智能体(Agent)和本地开发打造。该模型总参数80B,激活参数仅3B,在权威基准SWE-Bench Verified上实现了超70%的问题解决率,性能媲美激活参数规模大10-20倍的稠密模型。
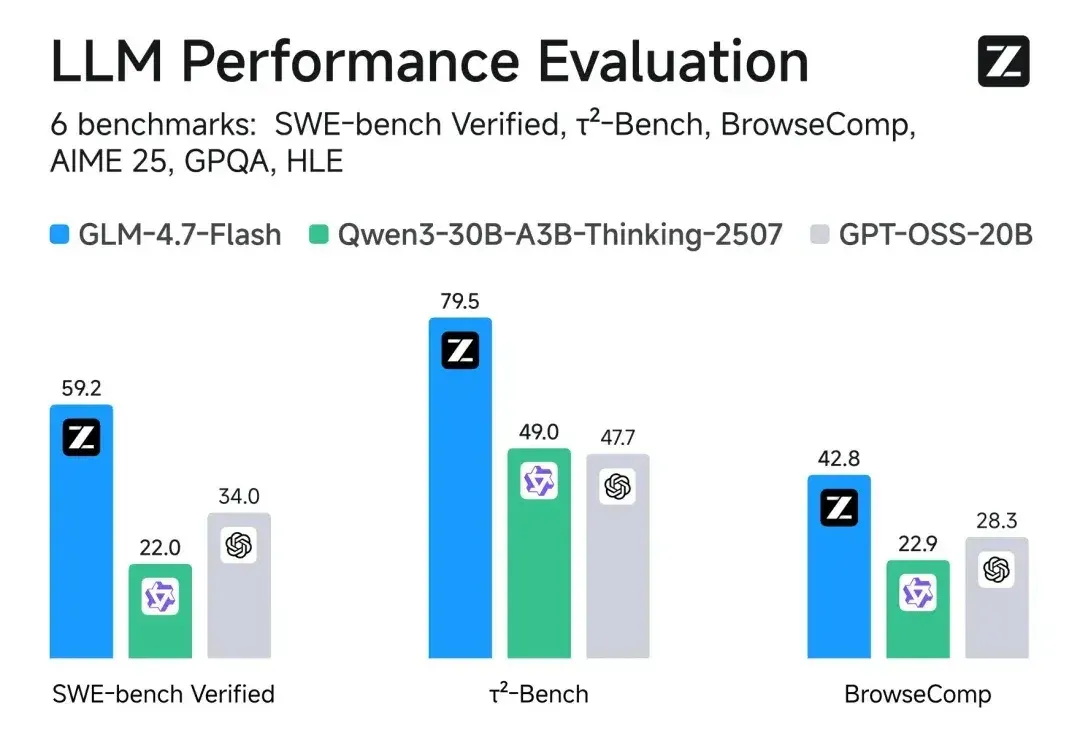
智谱AI上市后,再发新成果。 开源轻量级大语言模型GLM-4.7-Flash,直接替代前代GLM-4.5-Flash,API免费开放调用。 这是一个30B总参数、仅3B激活参数的混合专家(MoE)架构模型,官方给它的定位是“本地编程与智能体助手”。 在SWE-bench Verified代码修复测试中,GLM-4.7-Flash拿下59.2分,“人类最后的考试”等评测中也显著超越同规模的Qwen3-30B和GPT-OSS-20B。 作为去年12月发布的旗舰模型GLM-4.7的轻量化版本,GLM-4.7-Flash继承了GLM-4系列在编码和推理上的核心能力,同时针对效率做了专门优化。 除了编程
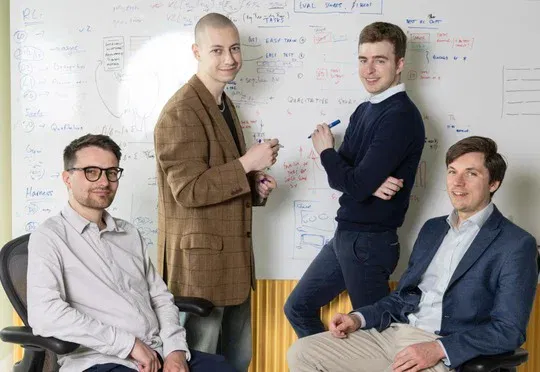
前DeepMind AI Scientist团队创立的Inherent获5000万美元种子融资,其基于Qwen3.6-27B后训练的科研判断系统Faraday在AI for Science预留测试集上以0.791的平均得分超越Claude Opus 4.8与GPT-5.5 Codex。
天下武功,唯快不破。 本周 Google I/O 大会上,谷歌发布了最新模型 Gemini 3.5 Flash。 Google I/O 大会发布 Gemini 3.5 Flash|图片来源:youtube 有趣的是,隔一天国内 Qwen3.7-Max 也发布了,并且两个模型都号称自己在 Agent 场景上做了深度优化。 我看到他们的第一反应是:又是新一轮「模型大战」,国内外厂商再次开启跑分竞赛。 但这次我花了两天时间实测之后,我发现Gemini 3.5 Flash 给我最大的感受不是它有多聪明,而是它的速度快到让我不得不重新想一个问题: 当模型的响应速度从「能用」变成「实时」,整个 Agent
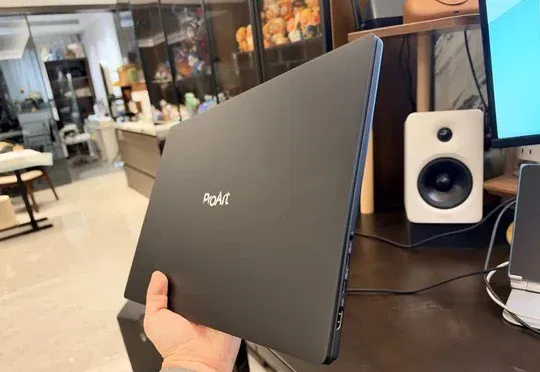
英伟达RTX Spark全球开售,128GB版本开售数分钟即售罄;作者使用售价37999元的华硕ProArt创16本地运行Qwen3.8-27B等模型,实现免API费用的多种AI任务并获得“Token自由”体验。