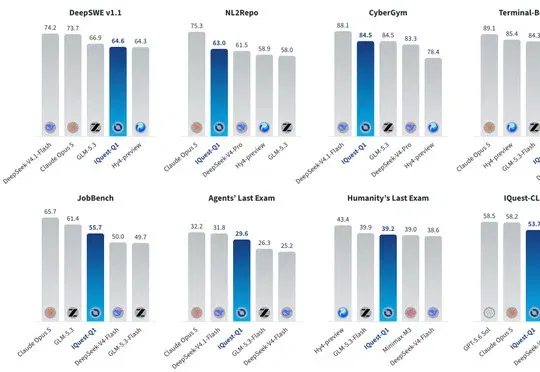
一出手就表现惊艳!国产开源大模型又杀出一匹黑马(在新窗口打开)
至知创新研究院开源了采用稀疏 MoE 架构的代码与复杂任务导向大模型 IQuest-Q1,该模型总参数约 320B、激活参数仅约 15B,在代码生成、终端操作、智能体任务等多项评测中表现均衡,并展示了从前端交互、游戏开发到强化学习训练调试等场景的可交付能力。
共 82 篇
至知创新研究院开源了采用稀疏 MoE 架构的代码与复杂任务导向大模型 IQuest-Q1,该模型总参数约 320B、激活参数仅约 15B,在代码生成、终端操作、智能体任务等多项评测中表现均衡,并展示了从前端交互、游戏开发到强化学习训练调试等场景的可交付能力。
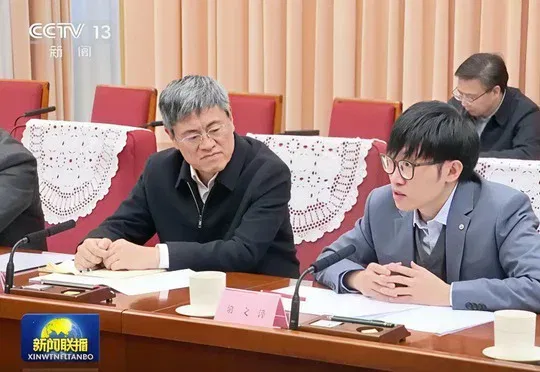
过去三年,梁文锋极少以第一作者或通讯作者身份,出现在 V3.2、V4、V4.1-Flash 这些动辄上百人署名的旗舰模型整体报告中;却始终把名字签在 MLA 注意力、MoE 路由机制、mHC 拓扑流形、DSpark 推理算子、DSec 智能体沙盒这些最底层的原子技术论文上。
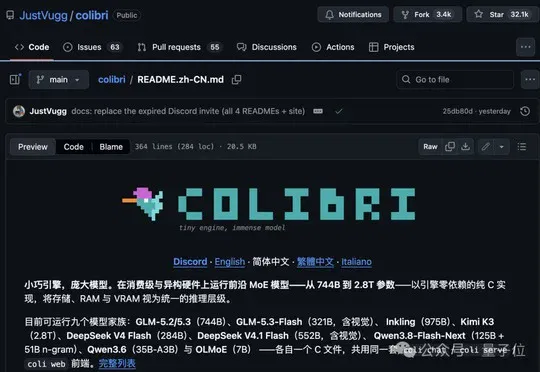
GitHub火热开源项目Colibrì以纯C实现分层推理框架,通过AI内存多层化将SSD、RAM和VRAM组成动态调度系统,无需GPU即可让普通笔记本运行744B参数GLM-5.2等超大MoE模型,已揽获32k Star并支持9个模型家族。
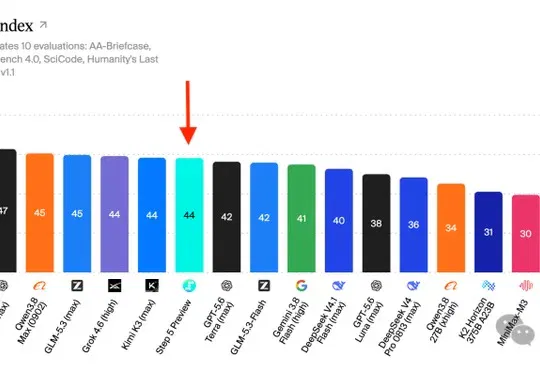
阶跃星辰发布新一代旗舰基座模型Step 5 Preview,以44分的AA智能指数成绩跻身全球开源模型前三,采用600B总参数/27B激活的稀疏MoE架构并原生支持1M上下文,在代码生成、长程Agent、深度研究与金融尽调等场景表现突出。

DeepSeek V4.1 Flash 正式在网页、App 和 API 端全面上线,采用 552B 参数的 MoE 架构与 Causal-Encoder-Decoder 设计,性能全面超越 V4 Pro 并原生支持多模态,DeepSeek Harness v0.1.5 也同步适配。
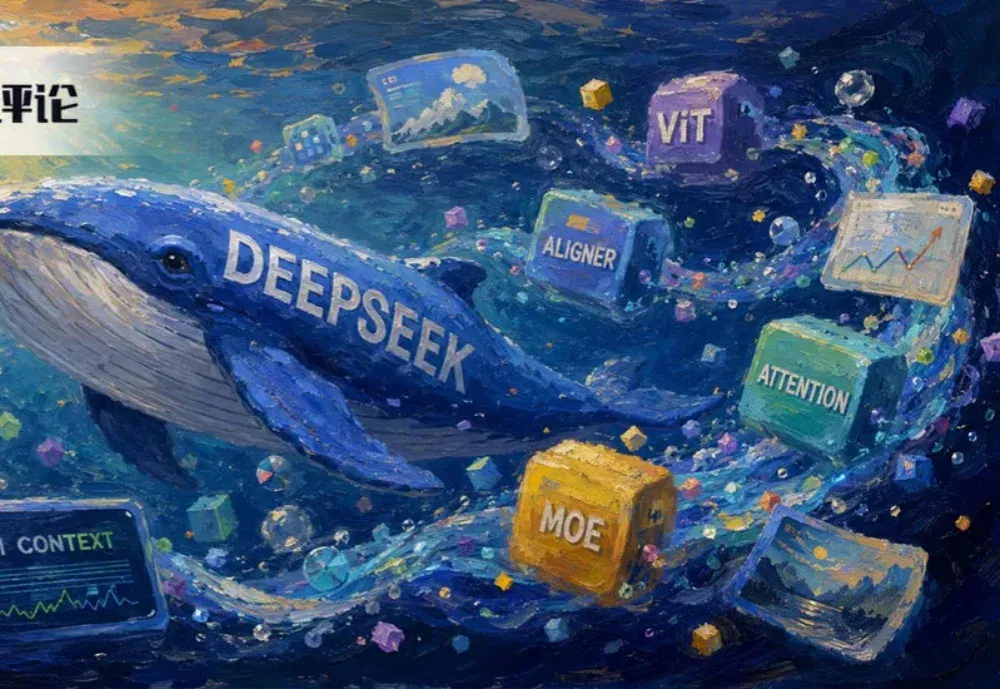
图片不只被编码,还直接参与 Attention、MoE 与 Agent 推理。
长期依赖外部模型,不是最好的选择。 前几天,我们注意小红书在海外发布了一款大模型 dots3-note preview。 这款模型采用 MoE 架构,总参数 280B、激活参数 16B,支持 512K 上下文,并具备文本、视觉、语音的多模态理解能力。它属于 dots3 系列,后续还将有 jazz、aria 等不同定位的版本。作为先行发布的 note 版本,它更像是小红书将模型能力推向实际业务和开发者生态的第一步。 模型上线后,海外开发者社区很快开始讨论,Hugging Face 下载量破百,华为昇腾也在当天宣布完成适配;但在国内,这次发布暂时还没有掀起太大水花。 在这件事上,值得注意的并不只是
在“灵晟”国产超算登顶最新一期全球超级计算机TOP500榜单后,清程极智与“灵晟”联合完成纯CPU MoE模型分布式推理方案:16节点即可流畅运行DeepSeek-V3/R1-671B模型,在batch_size=2048时,输出吞吐量与80张主流GPU集群相当。
再牛的大模型,也要放到行业面前公开露个面,才算真交卷。
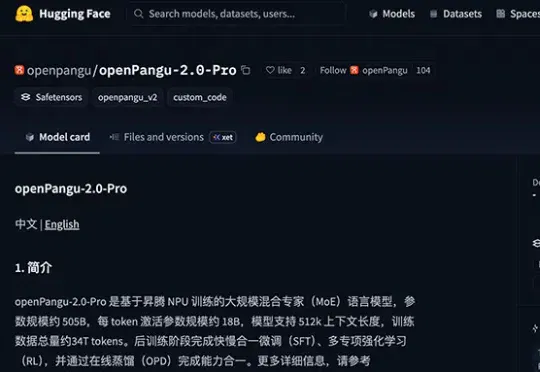
今日,华为开源基于昇腾NPU训练的盘古MoE模型openPangu-2.0-Pro。该模型是openPangu-2.0系列的最新开源模型,总参数规模5050亿,激活参数规模180亿,支持512K上下文长度,训练数据总量约34T tokens。另一轻量化模型openPangu-2.0-Flash已于6月12日开源,参数92亿,其中6亿为激活参数。