MiniMax H3 的 24h AI 直播火了,但我们搓出了更炸裂的东西!(在新窗口打开)
前两天刷 X 的时候,一条 Twitch 直播的录屏给看傻眼了: FAL 工程师 Rehan Sheikh 将 MiniMax H3 Max 接入 Twitch 直播流,搭建了一个由模型持续生成内容的频道,并把它称为「跨维度电视」。
共 168 篇
前两天刷 X 的时候,一条 Twitch 直播的录屏给看傻眼了: FAL 工程师 Rehan Sheikh 将 MiniMax H3 Max 接入 Twitch 直播流,搭建了一个由模型持续生成内容的频道,并把它称为「跨维度电视」。
「顽强如刀割」 阶跃终于有新闻了。 印奇回归,唐杰复出。虽然王小川还嘴硬说百川账上有30亿现金,但AI六小虎已经完全变成了四小虎。纯一把手工程,正式进入狠活大赛阶段。 MiniMax、智谱两家都上市了,走的是最主流的路。Kimi作为回应宣布融资5亿美金,整了个狠活,想表达的是:我不上市,融的钱也和你们上市融的差不多。 那阶跃在干嘛呢? 我原本以为阶跃只是偶尔发个模型、产品整个小活。没想到这回整了个大的:印奇官宣回归,B+轮融资超50亿元,比MiniMax、智谱上市融的钱都多,顽强得像是沈阳大街遗址开好果汁店的刀割。 对此我有一个判断:现在的大模型竞争纯纯进入咬打火机竞争阶段。 四家还活着的大模
MiniMax与KAGAMIAI等日本伙伴推出H3 IP Edition,利用H3生成内容,并通过Kagami Gate管理日本IP授权、使用记录和收益分配,已有超60家公司表达采用兴趣。
MiniMax海螺视频团队不藏了!首次开源就揭晓了一个困扰行业已久的问题的答案——为什么往第一阶段的视觉分词器里砸再多算力,也无法提升第二阶段的生成效果?翻译成大白话就是,虽然图像/视频生成模型的参数越做越大、算力越堆越猛,但用户实际体验下来总有一种微妙的感受——这些庞大的投入与产出似乎不成正比,模型离完全真正可用总是差一段距离。
据 The Information 报道,MiniMax 正在研发一款参数规模达 2.7 万亿的大语言模型,内部代号暂定为 M3 Pro,最快有望于今年第三季度发布,并计划同步开源。相较于现有旗舰模型 M3 的 4280 亿参数,M3 Pro 的规模实现了数量级跃升,预计将在复杂推理、多步骤任务处理及长上下文理解等能力上进一步增强。
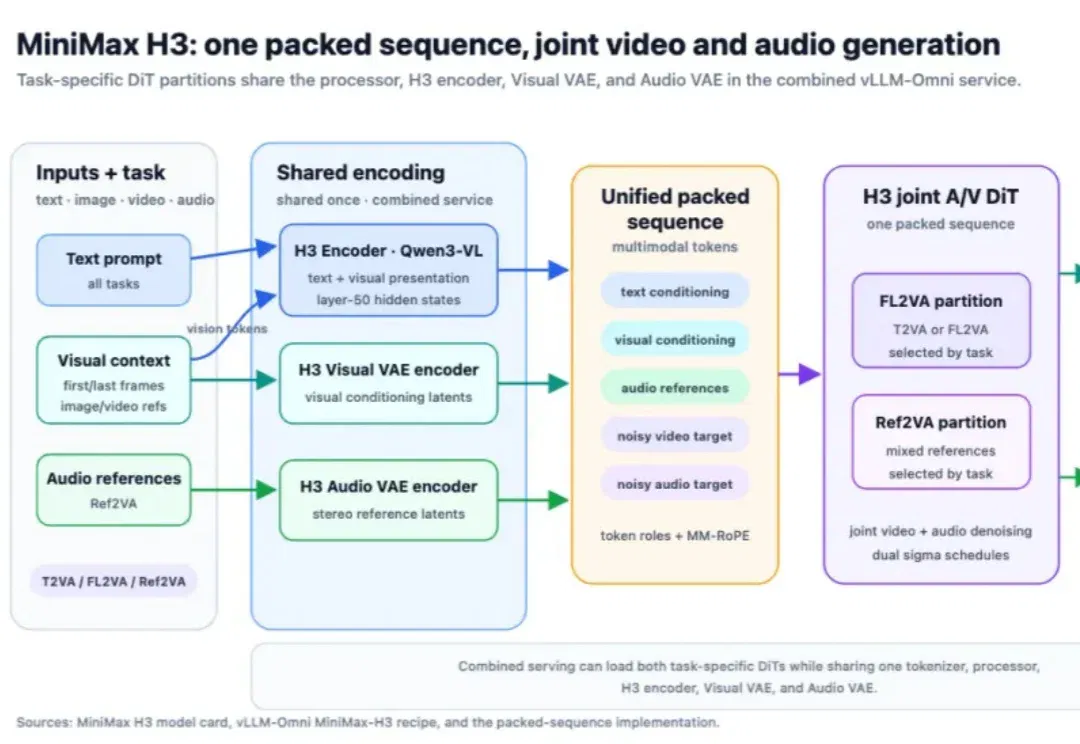
MiniMax H3 的服务是一个系统问题。一个请求要经过一个庞大的 Qwen3-VL 编码器、一个长序列的音视频 DiT、相互独立的视频与音频 VAE、设备与进程的边界,最后还要完成 H.264/AAC 的封装。只优化 DiT,其余环节的时延依然留在那里。
MiniMax M2.7 在今天正式开源。我们和华为昇腾、摩尔线程、沐曦、昆仑芯、NVIDIA,以及 Together AI、Fireworks、Ollama 等海内外芯片厂商、推理平台携手,在开源首日即完成模型接入与推理适配工作,推动全球 AI 生态繁荣发展。
MiniMax最新旗舰级Coding & Agent模型M2.1,刚刚对外发布了。这一次,它直接甩出了一份硬核成绩单,在衡量多语言软件工程能力的Multi-SWE-bench榜单中,以仅10B的激活参数拿下了49.4%的成绩,超越了Claude Sonnet 4.5等国际顶尖竞品,拿下全球SOTA。
前沿的 Coding 能力、1M 的上下文窗口,还有原生的多模态
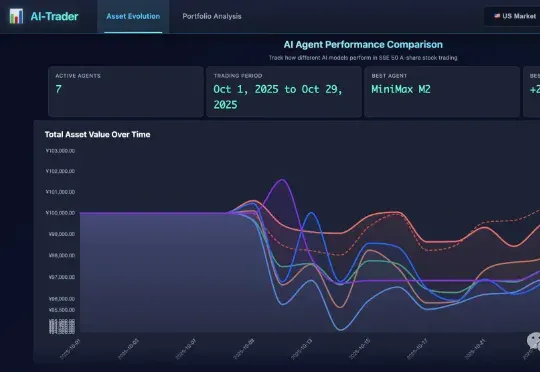
屠榜开源大模型的MiniMax M2是怎样炼成的?为啥M1用了Linear Attention,到了M2又换成更传统的Full Attention了? 面对现实任务,M2表现得非常扛打,在香港大学的AI-Trader模拟A股大赛中拿下了第一名,20天用10万本金赚了将近三千元。