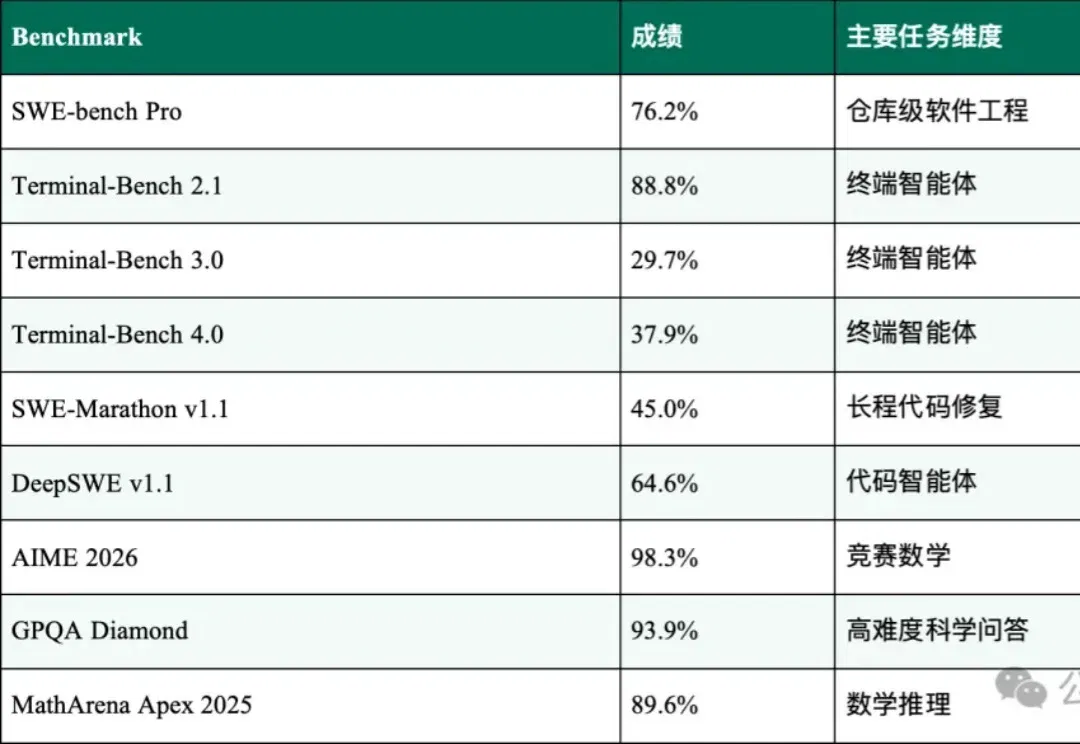
黑洞信息悖论推进至“定量完备性模量”:清华团队开源VeriLoop E2迈向可验证智能(在新窗口打开)
随着前沿模型进入长链推理、工具调用、代码修复与科研任务,一个关键缺口随之显现:模型不断生成和修改候选,但“新状态是否真的更可靠”不能只由模型自己判断。
共 58 篇
随着前沿模型进入长链推理、工具调用、代码修复与科研任务,一个关键缺口随之显现:模型不断生成和修改候选,但“新状态是否真的更可靠”不能只由模型自己判断。
实时交互模型尚未形成统一定义却已成为热门赛道,SigmaZ AI、Loopit、Reverie AI、Runway和Vidu等公司从原生音视频生成、Coding驱动等不同技术路线出发,探索AI在聊天框之外实时响应用户多模态输入的能力,行业正围绕定义权和稀缺交互数据展开竞争。
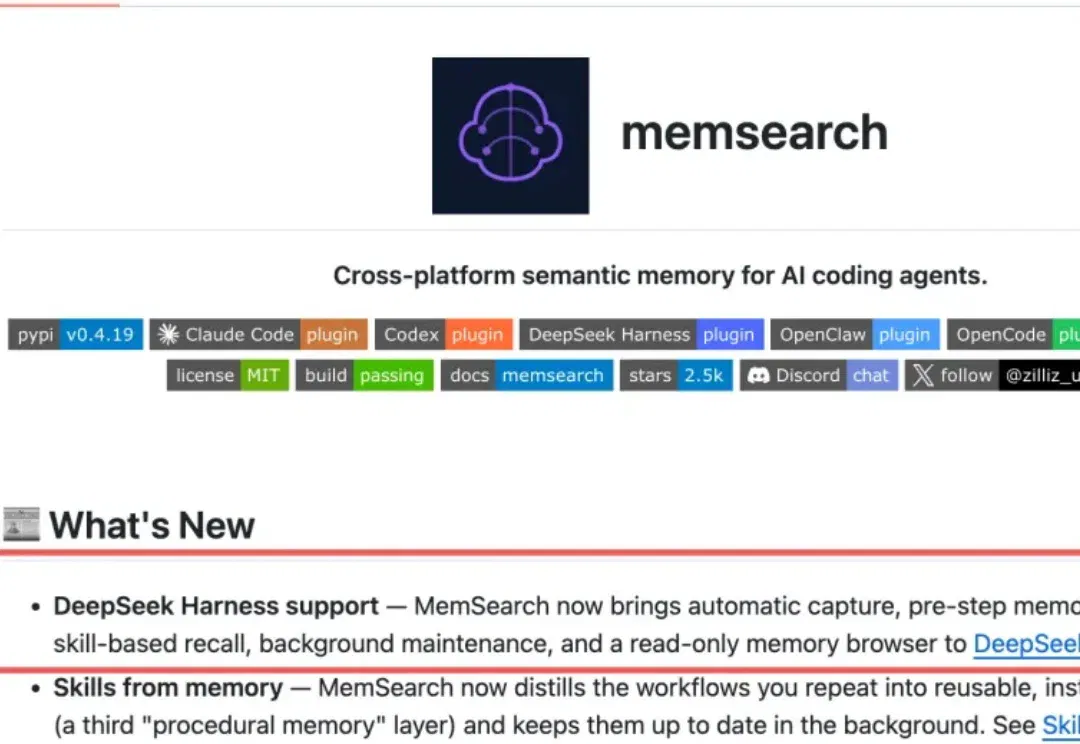
DeepSeek Harness(DSH) 的口号,大家应该都有所了解,模型、工具、Skills、会话、沙箱、存储、Agent Loop、调度,甚至 UI,一切皆插件。
从 Scale AI到 Surge AI,再到异军突起的 Mercor,在北美,一批AI Data公司的价值已经被验证。
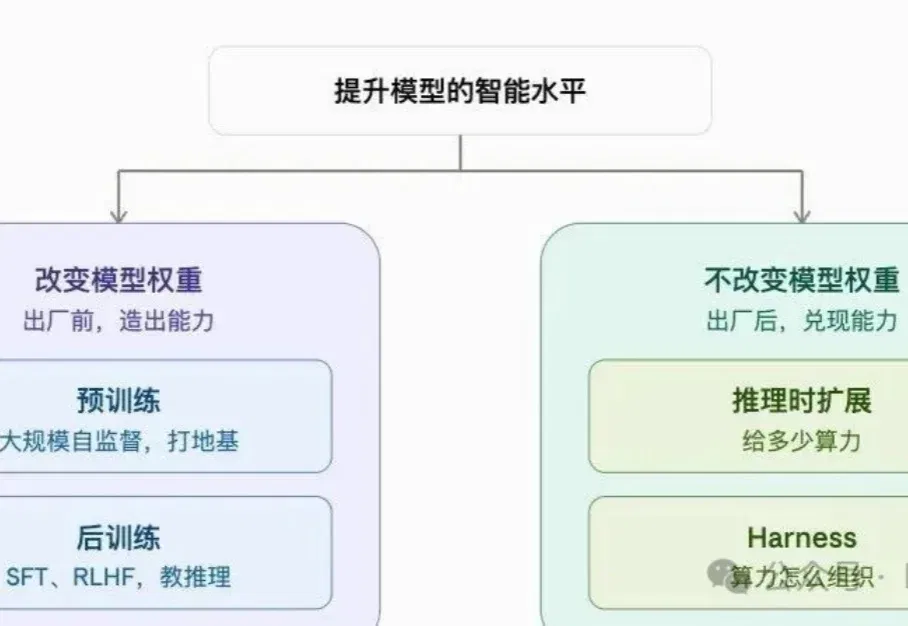
AI领域的造词速度已经到了一个夸张的水平,各种概念眼花缭乱。从龙虾、Agent、循环工程(Loop Engineering),到现在前沿的持续学习和RSI(递归自我改进)。不管是对于初步了解行业还是跟踪AI行业的人,这都是一件比较头疼的事情。
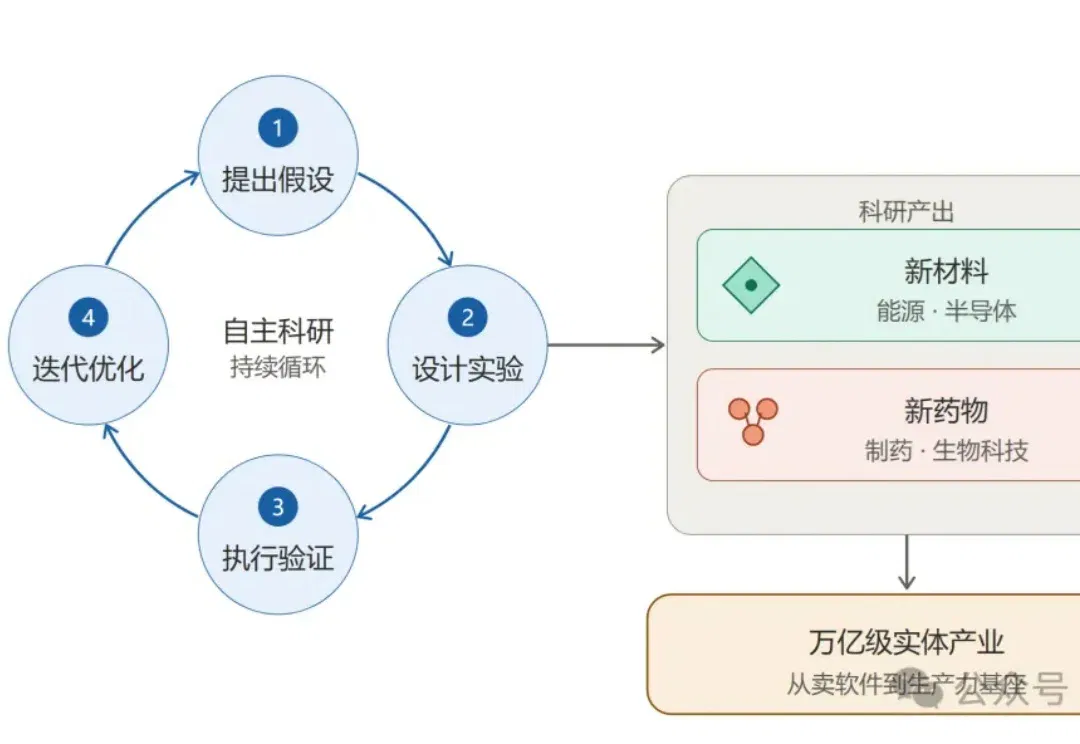
今年8月,谷歌首席科学家Jeff Dean宣布离职,创办AI4S公司Discovery Loop。
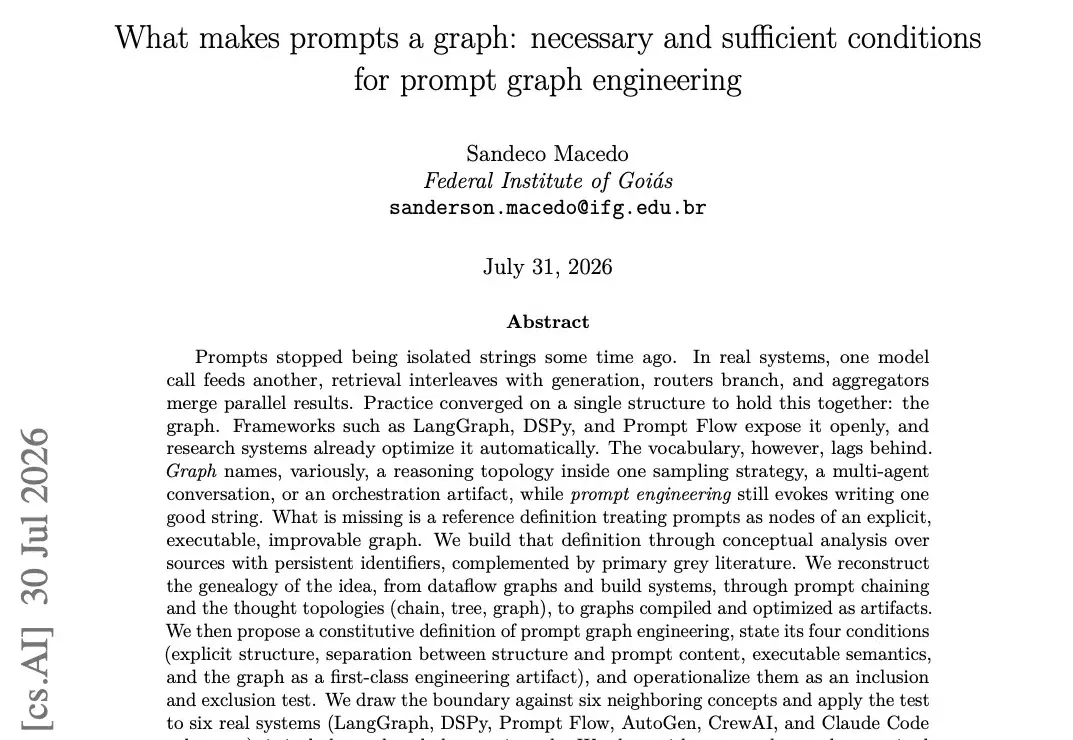
继Loop Engineering、Graph Engineering等概念进入讨论之后,一篇2026年7月底发布的论文又提出了一个更贴近Prompt本身的工程概念:Prompt Graph Engineering,提示词图工程。
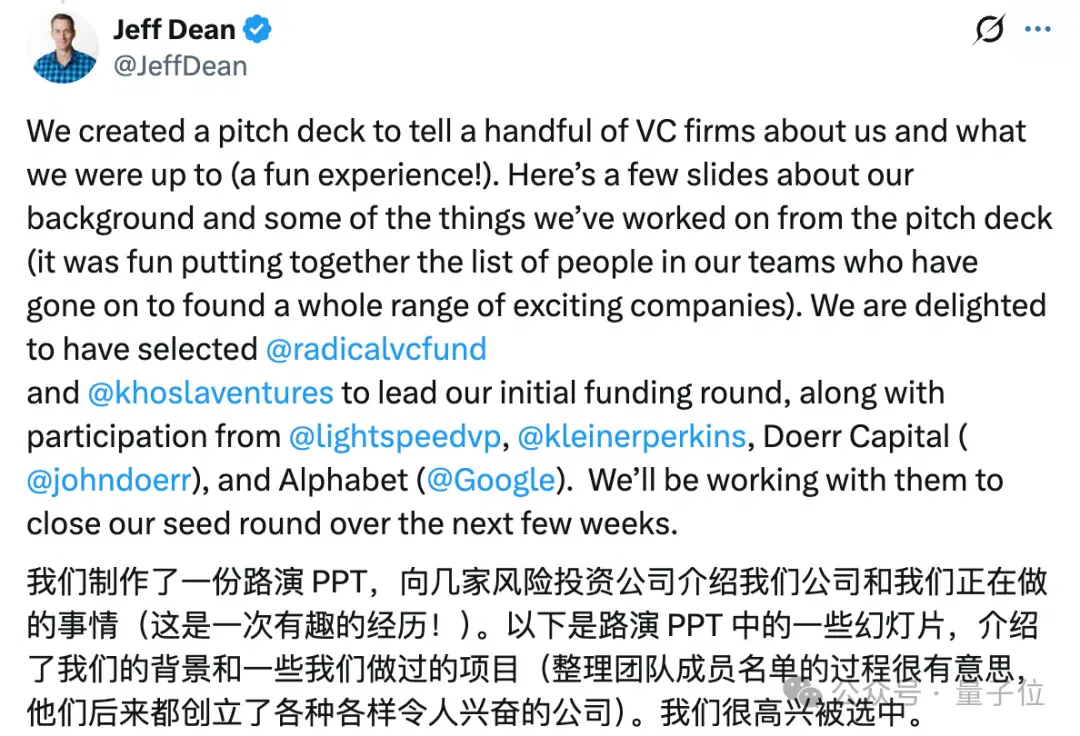
Jeff Dean的创业公司Discovery Loop,掏出了堪称史上最豪华的BP(商业计划书)。其中三页长这样:第一页,我们一起造过什么;第二页,我们带过多大的团队;第三页,我们的技术影响力有多强。
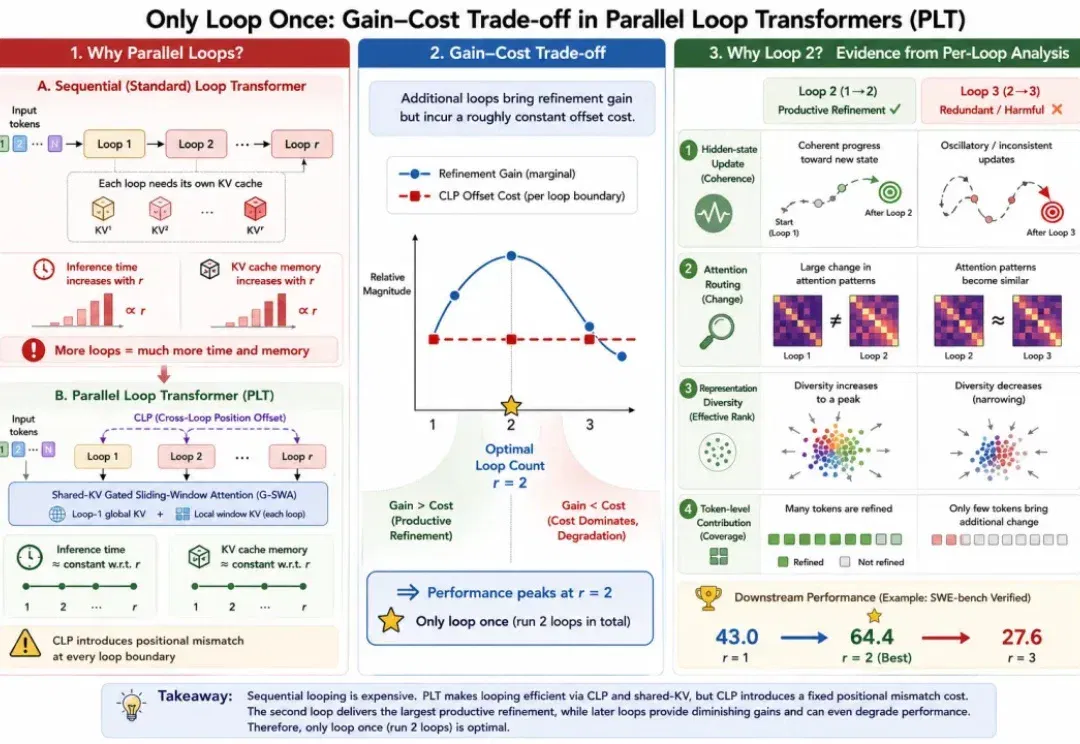
当所有人都在比谁「想得更久、算得更多」——推理模型动辄输出成千上万个思考 token,循环式架构恨不得在内部反复迭代十遍八遍——一项新研究反手泼了盆冷水:
在世界模型这条路上,行业一直卡在一个几乎无解的矛盾里:想要更真实的长程模拟,就必须给模型更深的计算;可一旦把模型做得更深,部署成本、参数规模和误差累积又会迅速抬头。结果就是,大家都知道世界模型要 “想得更久”,却很难让它在现实系统里 “算得起、跑得稳”。