13小时不眠不休,300个分身狂敲代码!开源第一易主了(在新窗口打开)
开源AI王座一夜易主!Kimi K2.6出道即巅峰,展示了恐怖的「全栈交付」能力。它不仅能复刻高盛研报、手搓奢华官网,甚至能和人类在群组里并肩打工。
共 46 篇
开源AI王座一夜易主!Kimi K2.6出道即巅峰,展示了恐怖的「全栈交付」能力。它不仅能复刻高盛研报、手搓奢华官网,甚至能和人类在群组里并肩打工。
大模型编程最近太猛了。 自从编码成了大模型的核心能力后,各大模型厂商都卷得要命,从卷模型参数和性能,到卷开发工具链,编码能力的提升,简直是一场军备竞赛。 近几个月以来,以 Claude 4.5、GLM-4.6、kimi-k2 等为代表的编码模型,都具备了执行复杂项目开发,构建真实应用程序的能力。 卷模型能力只是个开始,各大厂商也已全面进军智能编码产品,各类 IDE 产品层出不穷。就连服务套餐也开始卷出「和 AI 砍价」的新花样,智能编程领域逐渐成为了新的红海。 在模型能力飞涨的情况下,业界知名的大模型公共基准测试平台 LMArena 也敏锐地意识到,「问题已经不再是模型能否编写代码,而是它如何
刚刚,这样一个消息在 Reddit 上引发热议:硅谷似乎正在从昂贵的闭源模型转向更便宜的开放源替代方案。
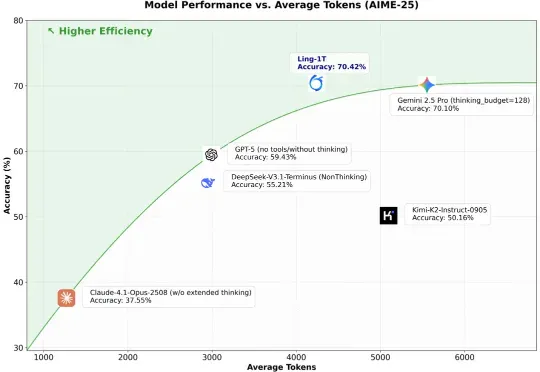
10 月 9 日凌晨,百灵大模型再度出手,正式发布并开源通用语言大模型 Ling-1T ——蚂蚁迄今为止开源的参数规模最大的语言模型。至此,继月之暗面Kimi K2、阿里 Qwen3-Max 之后,又一位重量级选手迈入万亿参数LLM 「开源俱乐部」。
随着DeepSeek R1、Kimi K2和DeepSeek V3.1混合专家(MoE)模型的相继发布,它们已成为智能前沿领域大语言模型(LLM)的领先架构。由于其庞大的规模(1万亿参数及以上)和稀疏计算模式(每个token仅激活部分参数而非整个模型),MoE式LLM对推理工作负载提出了重大挑战,显著改变了底层的推理经济学。
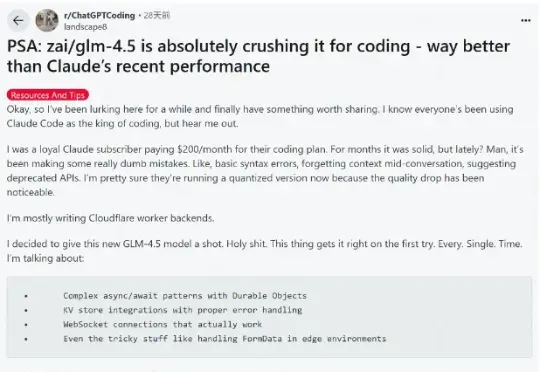
这段时间 AI 编程的热度完全没退,一个原因是国内接连推出开源了不少针对编程优化的大模型,主打长上下文、Agent 智能体、工具调用,几乎成了标配,成了 Claude Code 的国产替代,比如 GLM-4.5、DeepSeek V3.1、Kimi K2。