GPT-5.2被曝作弊!偷袭谷歌竟靠拉爆token刷高分,不如Gemini 3(在新窗口打开)
GPT-5.2打赢Gemini 3.0 Pro,竟是靠高推理与海量Token「作弊」?网友的这个发现,在AI社区一石激起千层浪。更多网友七嘴八舌表示:GPT-5.2,并没有那么好用!
共 80 篇
GPT-5.2打赢Gemini 3.0 Pro,竟是靠高推理与海量Token「作弊」?网友的这个发现,在AI社区一石激起千层浪。更多网友七嘴八舌表示:GPT-5.2,并没有那么好用!
芜湖,才刚发布一天,Gemini 3 Pro就被网友们玩出花,那脑洞一个比一个大!
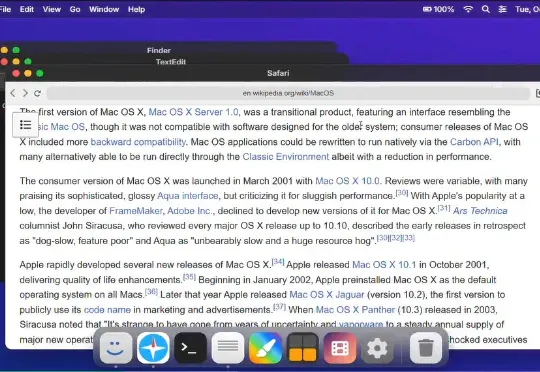
前端UI的工作,被谷歌AI一夜干没了。 就在最新能力展示中,Gemini 3.0 Pro居然自己“捏”出了一个macOS。
全行业都在押注多Agent。 Anthropic上周在开发者大会上发了Multi-Agent Orchestration ,TRAE做了多Agent并行调度,各家都在讲一个Agent干不动就上多Agent。 最近,滑铁卢大学在 arXiv 上放出一篇论文,给出了相悖结论—— 多 Agent 协作不一定让模型更聪明,而是让模型更蠢。 研究团队做了一组大规模实验——22500条推理轨迹,覆盖GPT-5.4、Claude Sonnet 4.6、Gemini 3.1 Pro三个头部模型,在GAIA、SWE-bench、Multi-Challenge三个基准上测试。 测试发现,多个Agent一起工作时,
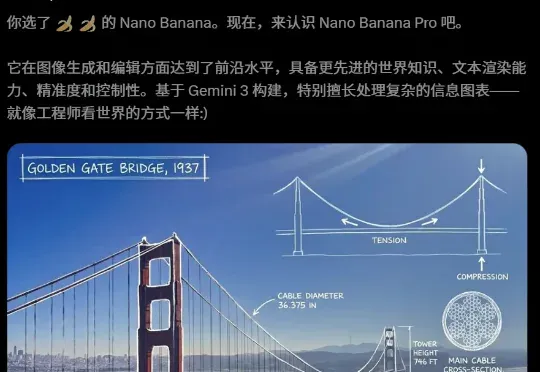
Gemini 3 Pro刚炸完,谷歌又在深夜扔出了「AI图像新神」Nano Banana Pro!它用像素级的恐怖细节和完美的汉字渲染告诉世界,谁才是AI生图真正的王者。
蚂蚁通用人工智能中心自然语言组联合香港大学自然语言组(后简称“团队”)推出PromptCoT 2.0,要在大模型下半场押注任务合成。实验表明,通过“强起点、强反馈”的自博弈式训练,PromptCoT 2.0可以让30B-A3B模型在一系列数学代码推理任务上实现新的SOTA结果,达到和DeepSeek-R1-0528, OpenAI o3, Gemini 2.5 Pro等相当的表现。
AI新王来了!马斯克Grok 4.1静默上线,一夜之间登顶LMArena,Gemini 2.5 Pro却被按在地上摩擦。主打情商智商在线,算力又扩增一个数量级。这一次,Grok 4.1一共放出了两大版本:Grok 4.1 Thinking和Grok 4.1。
阿里巴巴推出了Qwen3-Max-Thinking,这是阿里千问系列目前能力最强的旗舰级推理模型,在19项权威基准测试中,Qwen3-Max-Thinking跟GPT-5.2-Thinking、Claude-Opus-4.5和Gemini 3 Pro等顶尖模型打得有来有回,搭配测试时扩展(TTS)能力后,能在不少基准测试上达到SOTA。
本报告基于XSCT Arena平台,对 Qwen3.6-Plus-Preview(阿里云,2026-04-02 发布)在文字能力(xsct-l)、网页生成(xsct-w)、Agentic 任务(xsct-a)三大场景下的表现进行系统评测,并与Claude Sonnet 4.6、GPT-5.4、Gemini 3.1 Pro、Kimi K2.5、
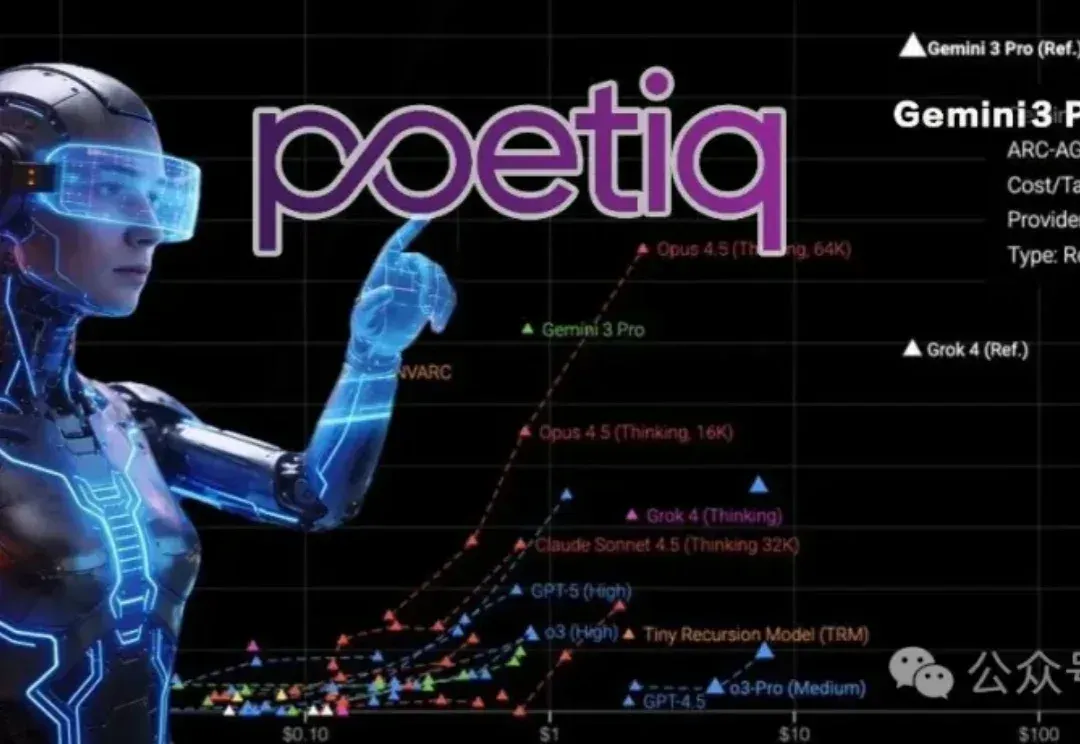
6位前DeepMind成员以元系统重塑大模型调用方式,该系统推出的Gemini 3 Pro优化技术在ARC-AGI-2上以54%的成绩夺得榜首,而成本仅为此前最优方法的一半。