开源个 Skill|彻底解决小红、小绿书配图难题(在新窗口打开)
前段时间开源了 guizang-ppt-skill,之后我自己用它做内容的时候发现一件事。
共 66 篇
前段时间开源了 guizang-ppt-skill,之后我自己用它做内容的时候发现一件事。
最近,来自上海创智学院、复旦大学等机构的研究者提出了 Hallo-Live,试图正面解决这个矛盾。论文于 2026 年 4 月 26 日 发布在 arXiv。该方法将 异步双流扩散(Asynchronous Dual-Stream Diffusion) 与 人类偏好引导蒸馏(Human-Centric Preference-Guided DMD) 结合起来
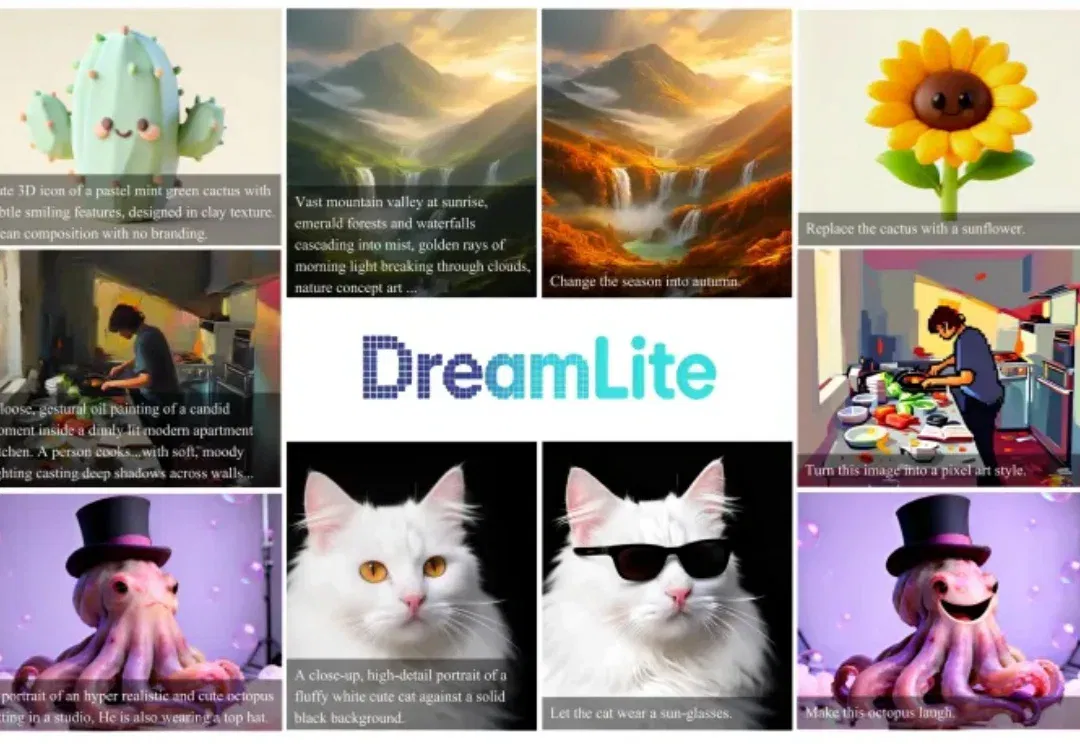
近日,字节跳动智能创作部门(Intelligent Creation Lab)提出新作 DreamLite,一个主干网络仅有 0.39B 参数的轻量级统一扩散模型,在单一网络内同时支持文生图(Text-to-Image) 和图像编辑(Text-guided Image Editing)两个任务,是目前已知首个实现这一能力的端侧模型。
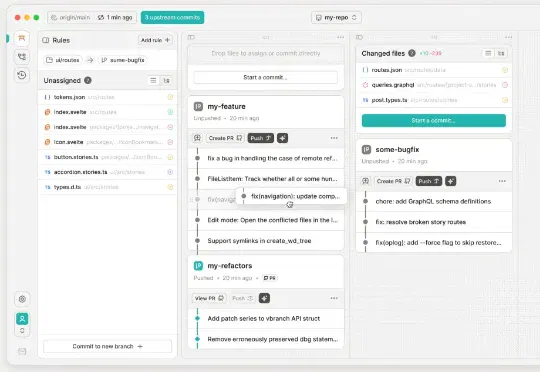
GitButler最近发布的CLI工具引起了我很大的兴趣。这不是一个简单的Git包装器,而是从根本上重新思考了命令行工具应该如何设计。Scott提到了一个有趣的观察:大约80%的开发者仍然使用命令行工具来操作Git,即使有各种GUI工具存在。
「龙虾」(OpenClaw)的爆发,让一个趋势迅速达成共识——Agent 正在「杀死」软件,GUI 正在过时。而当下的电脑、手机等设备,并不是运行「龙虾」的最佳选项。
马斯克最新豪言震动硅谷:芯片自己造,数据中心要上天,目标直指人类星际文明。很多人第一反应是「又在吹牛」,但红杉合伙人Shaun Maguire却反手押注:xAI会赢。
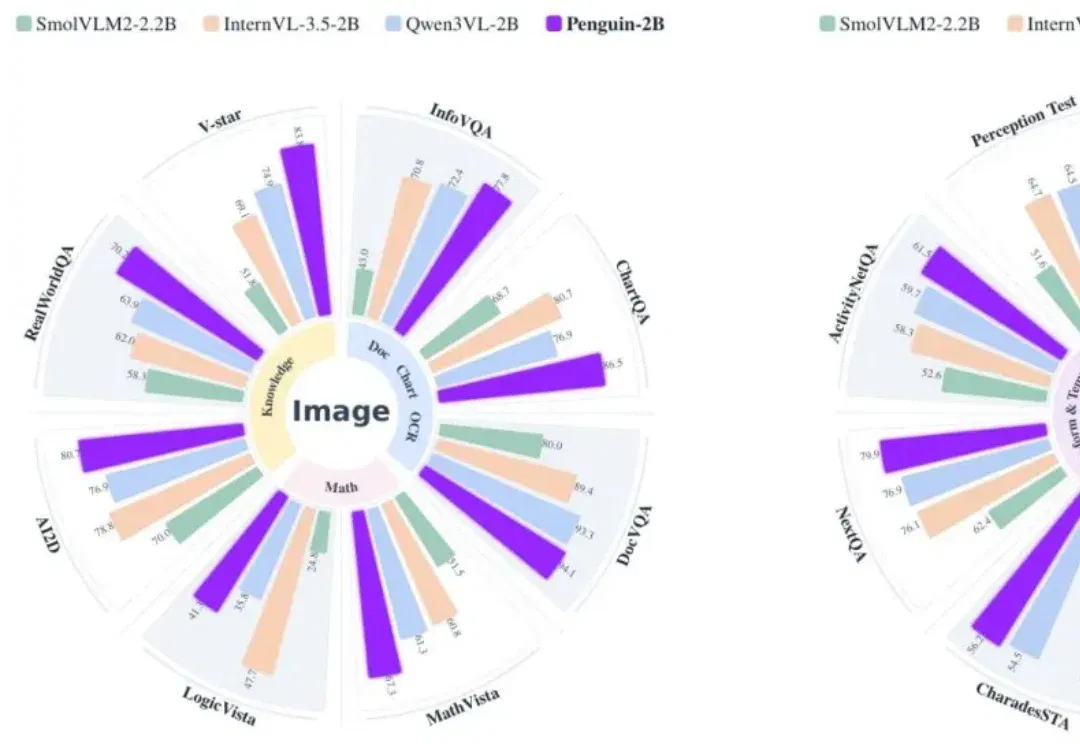
打破多模态视觉+语言拼接套路! 腾讯开源Penguin-VL,直接用纯文本LLM训视觉编码器。 这项研究跳出了先有传统视觉 backbone,再接语言模型的常规路径,直接从text-only LLM初始化vision encoder。 并在2B/8B紧凑参数规模下的文档理解、长视频时序定位等复杂任务中表现出极强竞争力。 从LLM出发的视觉编码器重构 如果把这两年的多模态模型拆开看,一个很有意思的现象是: 大家在语言模型上卷得很凶,但到了vision encoder这一层,路线却出奇一致。 很多VLM最后都会回到那套熟悉配方,先拿CLIP、SigLIP这类通过对比学习训出来的视觉模型做encod
3月6日,腾讯混元发布了一篇名为“HY-WU (Part I): An Extensible Functional Neural Memory Framework and An Instantiation in Text-Guided Image Editing”的技术报告。提出了一种崭新的功能性记忆(functional neural memory)范式(weight unleashing),
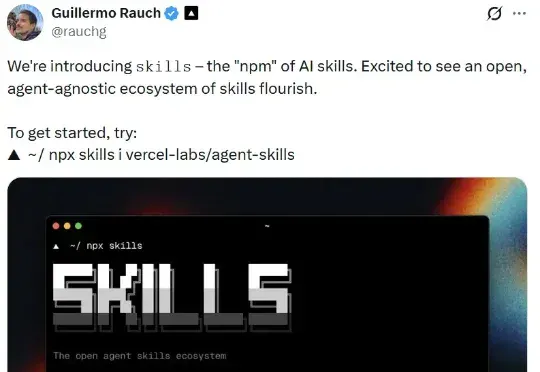
比如前些天,Vercel 创始人 Guillermo Rauch 推出了所谓的「AI skill 的 npm」,让用户仅需一个简单命令 npx skills add [package],就能为自己的 AI 智能体轻松注入专业能力。
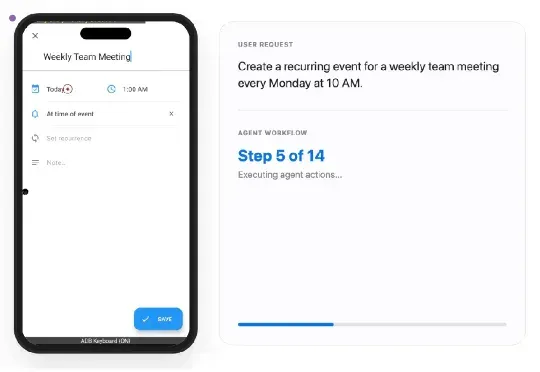
SmartSnap的核心思想是将GUI智能体从“被动的执行者”转变为“主动的自证者”。简单来说,智能体在完成任务的同时,还会主动收集、筛选并提交一份“证据快照集”。