你不知道的 GEO:AI 可见性的原理、实践与取舍(在新窗口打开)
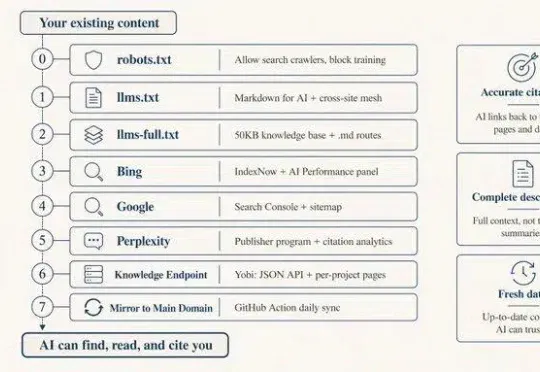
这几天有好几个小伙伴@我说,我的开源工具在他们问 AI 的时候被主动推荐了,啥也没做居然可以被收录,想着要不花一个小时把内容结构化整一整,应该会更好,于是整好以后,快速发了一个速记推,但是内容结构不清晰,想着大家很感兴趣,那要不就整一个结构清晰的文章便于沉淀和查找。
共 58 篇
这几天有好几个小伙伴@我说,我的开源工具在他们问 AI 的时候被主动推荐了,啥也没做居然可以被收录,想着要不花一个小时把内容结构化整一整,应该会更好,于是整好以后,快速发了一个速记推,但是内容结构不清晰,想着大家很感兴趣,那要不就整一个结构清晰的文章便于沉淀和查找。
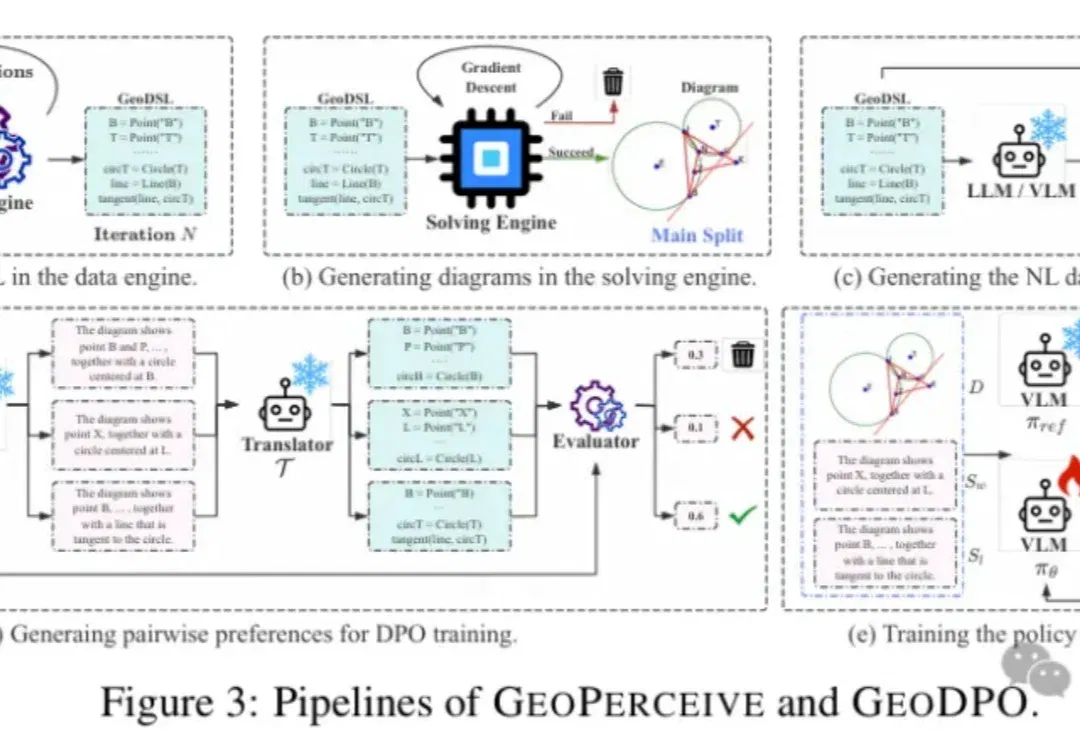
几何问题,真的只是“推理难”吗? 近年来,视觉语言模型(VLMs)在图文问答、表格理解、数学应用题等多模态任务上取得了显著进展。 但当问题变成几何图形时,它们的表现却往往明显下降。 为什么? 近日,来自光明实验室与清华大学的研究团队深入剖析了多个主流模型的错误案例,观察到一个值得关注的现象: 当前VLM在几何问题上的失败,很大程度上暴露出其几何感知错误(perceptual errors)的短板,而这一核心因素在现有研究中往往未被单独系统分析。 换句话说,在不少情况下,模型并不是不会推理,而是在更早阶段——对图形结构的识别已经出现偏差。 常见问题包括: 错误识别几何基本元素(点、线、圆)漏检关
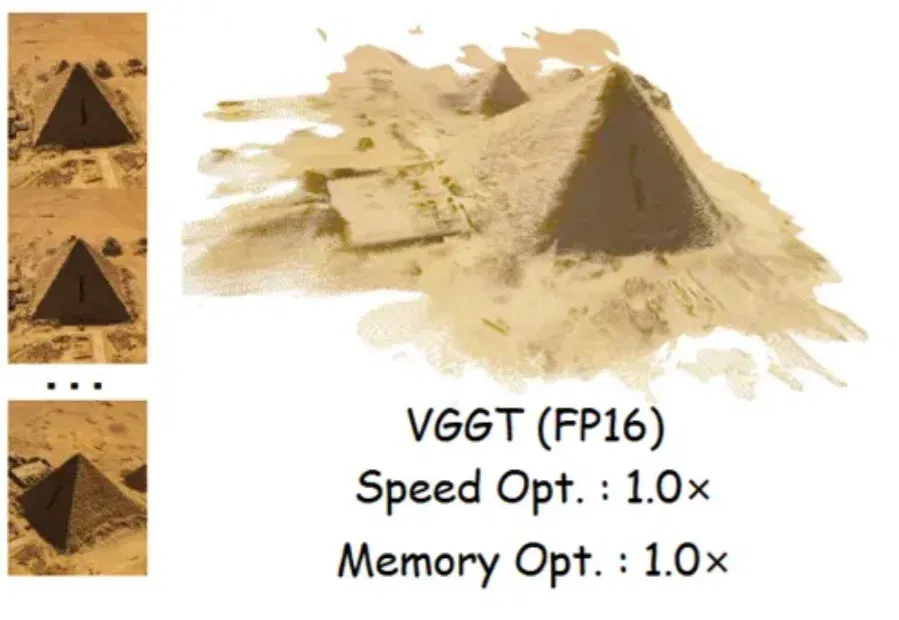
十亿参数的三维重建模型,能塞进手机吗? 以前想都不敢想——VGGT这样的庞然大物,单次前向传播就能完成深度估计、点云回归、相机预测多个任务,但部署成本高得吓人。 现在,一个名为QuantVGGT的量化框架给出了答案:4比特量化,速度提升2.5倍,内存减少3.7倍,精度保住98%。 近年来,以视觉几何基础Transformer(Visual Geometry Grounded Transformers, VGGT)为代表的基于学习的三维重建模型,借助大规模Transformer取得了显著进展。 然而,其极高的计算和内存成本严重阻碍了在实际场景中的部署。训练后量化(Post-Training Qu
AI 搜索引擎正逐渐取代传统搜索入口,「问 AI」已经成为日常习惯。随着 OpenAI 宣布在 ChatGPT 中引入商业推荐,搜索与内容分发的边界正在被重新定义。在这样的环境下,你的内容能否在 AI 搜索中成为「爆款」,不再只取决于标题和流量,而是更大程度取决于 AI 本身的引用偏好。
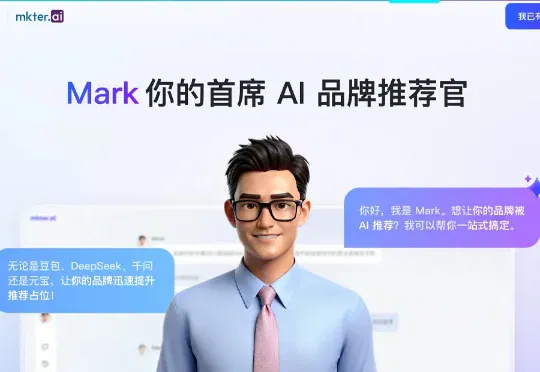
PureblueAI清蓝也同步发布了新产品——AI 营销数字员工平台mkter.ai,以及 AI 口碑营销数字员工“Mark”。
Hinton百万引用的背后,是数篇奠基「现代人工智能」的不朽之作!
最近,一个澳大利亚的养羊大叔用5行代码捅破AI编程天花板的故事,彻底火出圈了。2025年底,在铲羊粪的间隙,Geoffrey Huntley写出了下面这个仅含5行代码的Bash脚本while :; do cat PROMPT.md | claude-code ; done
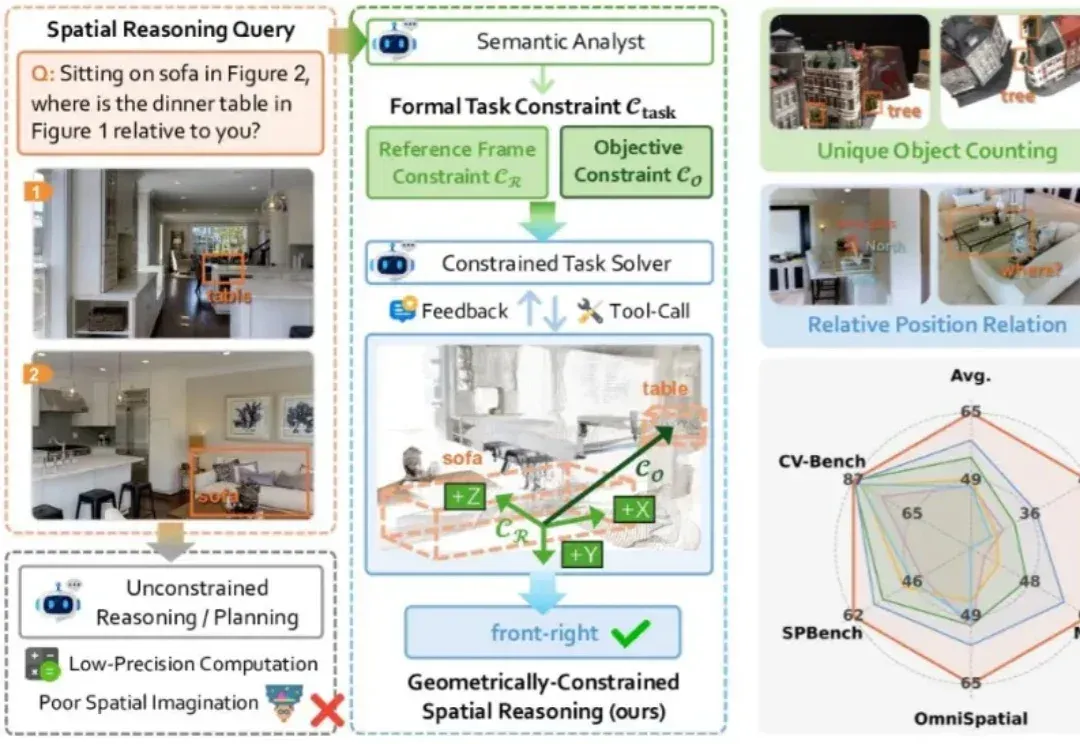
现有的视觉大模型普遍存在「语义-几何鸿沟」(Semantic-to-Geometric Gap),不仅分不清东南西北,更难以处理精确的空间量化任务。例如问「你坐在沙发上时,餐桌在你的哪一侧?」,VLM 常常答错。
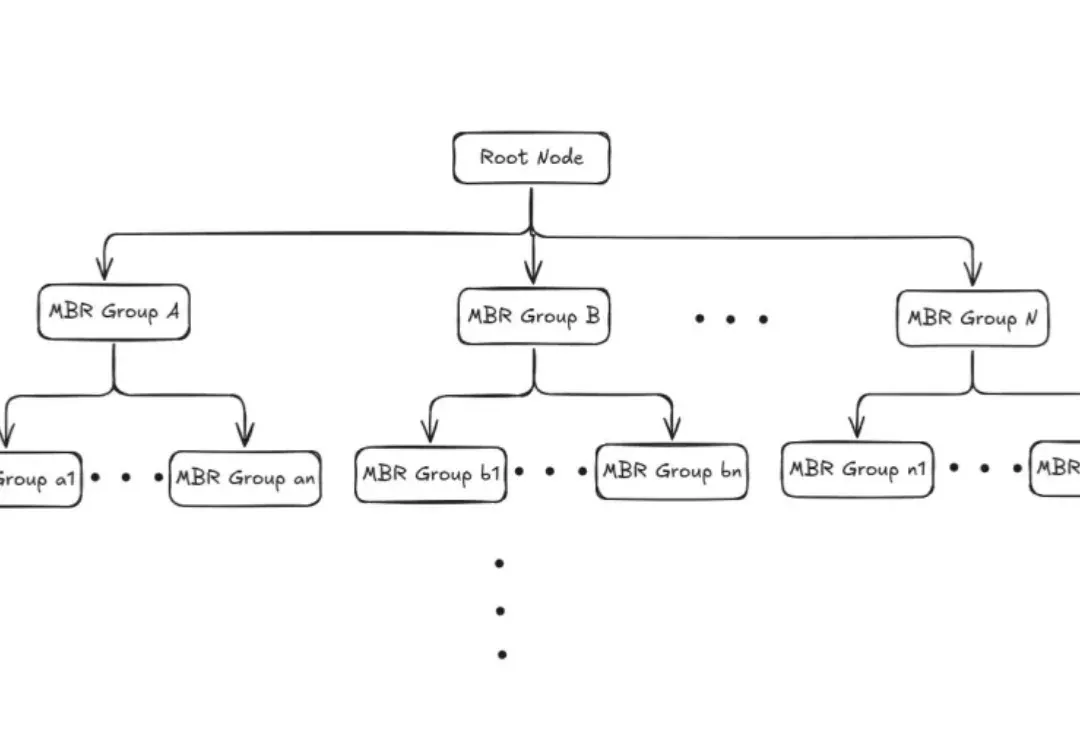
本文为Milvus Week系列第三篇,该系列旨在分享Milvus的创新与实践成果,以下是DAY3内容划重点: Milvus2.6中,Zilliz借助Geolocation Index for Milvus,首次将地理空间数据与向量检索融合,使 AI 可以在理解语义的同时,理解空间。
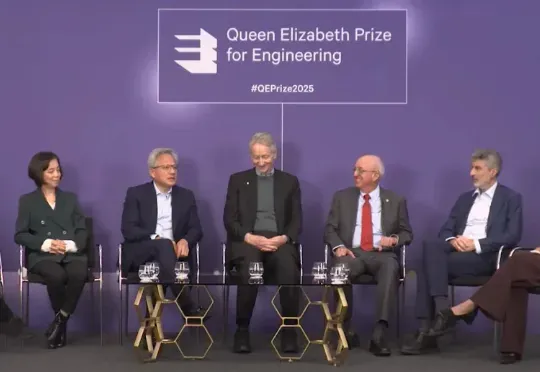
这是一个人类 AI 群星闪耀时的时刻——黄仁勋、李飞飞、杰弗里·辛顿(Geoffrey Hinton)、约书亚·本吉奥(Yoshua Bengio)、杨立昆(Yann LeCun)、比尔·戴利(Bill Dally),罕见同台参与同一个圆桌讨论 AI。之所以能聚在一起,是因为他们六人获得了 2025 年伊丽莎白女王工程奖。