速递|AI基础设施公司Cornelis获2.05亿美元融资(在新窗口打开)
AI基础设施公司Cornelis完成2.05亿美元融资并发布Active Compute Fabric网络技术,以开放架构与Nvidia竞争,解决GPU等待数据造成的算力浪费问题。
共 68 篇
AI基础设施公司Cornelis完成2.05亿美元融资并发布Active Compute Fabric网络技术,以开放架构与Nvidia竞争,解决GPU等待数据造成的算力浪费问题。

If I Had One Bet on Robot Learning, I’d Bet on Cross-Entropy. 大语言模型的成功揭示了一个适用于一维序列数据的清晰 Scaling Law:通过自回归训练,并采用交叉熵(cross-entropy)目标函数预测下一个 token 的概率分布,模型能够建模非常复杂的语义概率分布,并随着数据规模和模型规模的增长持续提升性能。

「麻烦你,帮我看一下。」 一副 AI 眼镜的价值,可能就藏在少说一次这样的话里。 到了陌生的地方,视障用户最需要的不是一个什么都能聊的 AI,而是一个能告诉他周围有什么、该注意什么的帮手。该提醒时及时提醒,没必要时就安静,别在耳边说个不停。 京东在本次 JDD 上展示的 AI 眼镜,瞄准的正是这个需求:接入 JoyAI-VL-Interaction 模型,通过第一视角持续理解周围环境,为全盲及低视力人群提供辅助,减少「必须问人」的时刻。 这是一副充满爱与希望的智能眼镜。它也是观察京东 AI 路线的一个小切口。 JDD 期间,京东发布并开源JoyAI-Echo WM 实时可交互世界模型,并带来一
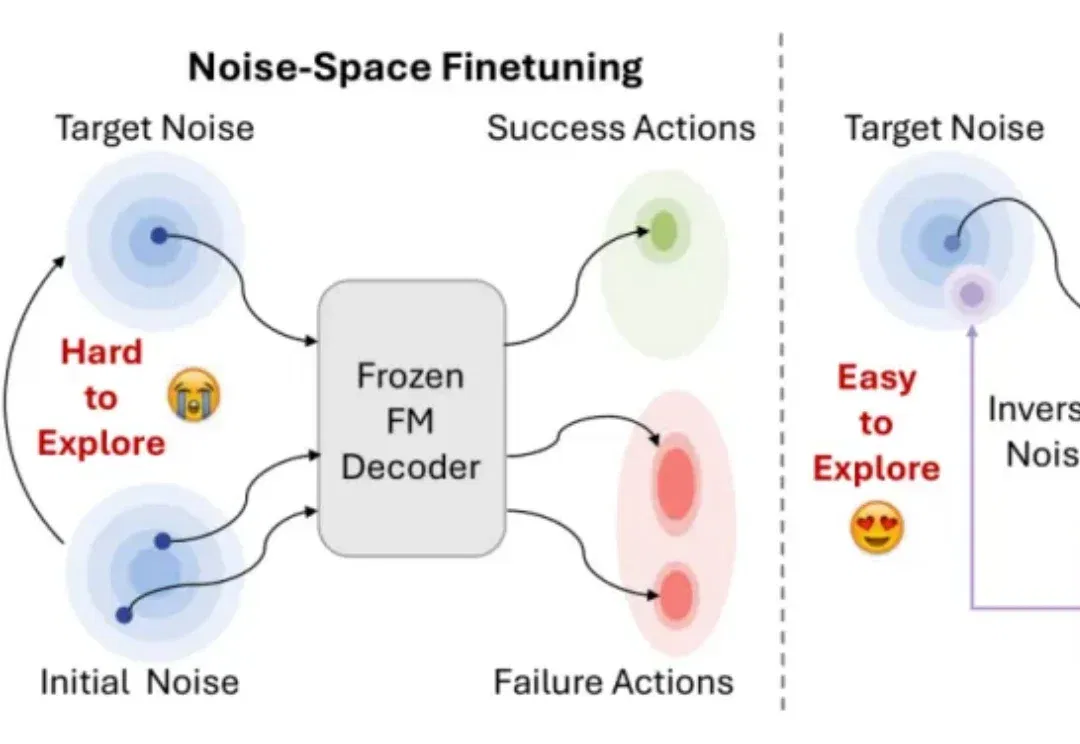
视觉 - 语言 - 动作模型(Vision-Language-Action Model,VLA)正在成为机器人操作的重要基础模型。经过少量示范微调后,VLA 已经能够完成抓取、放置、堆叠等多种任务。然而,一旦任务涉及精密接触、狭小容差或分布外位置,模型的成功率仍会明显下降。
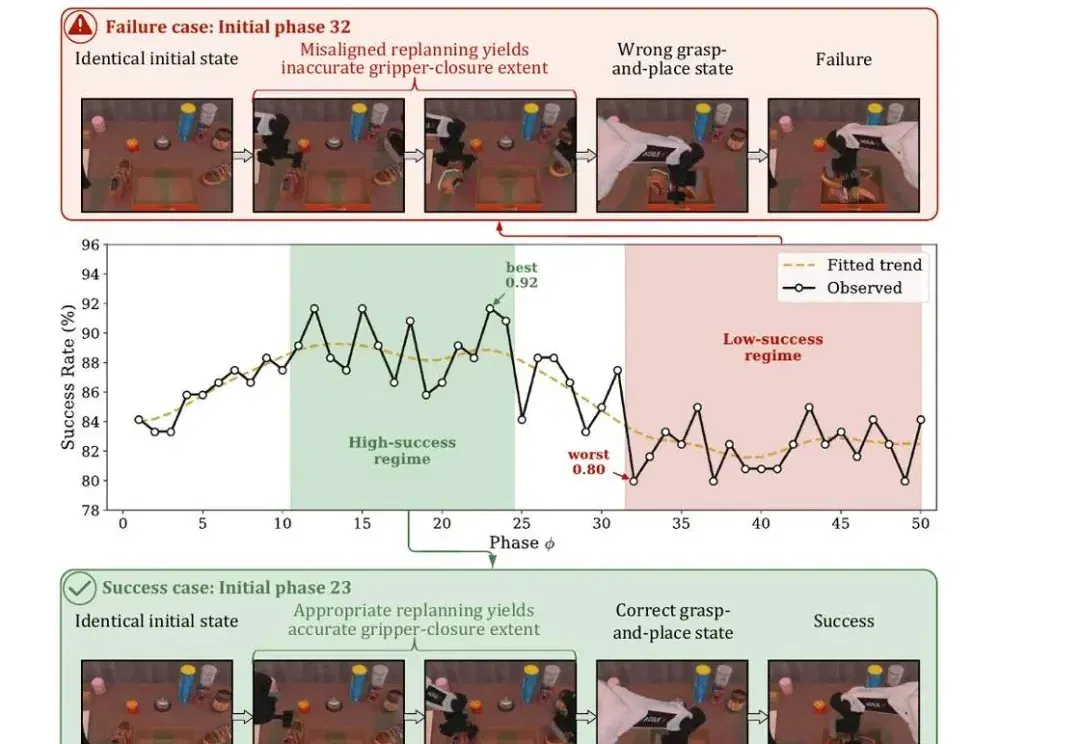
在 action chunking 已成为 VLA 标配的今天,「一次执行多少步」几乎被所有工作当作一个固定的超参数。
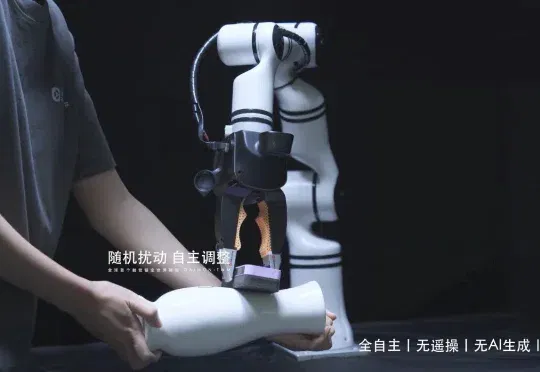
8 月 10 日,戴盟机器人正式发布全球首个触觉锚定世界模型 Daimon-TWM(Tactile-grounded World Model),以原生触觉贯穿物理认知、推演决策和瞬时反应全阶段。这个 “物理交互脑” 不仅能理解正在发生的物理接触,还能预测下一步交互会发生什么,并根据瞬息万变的反馈及时修正动作。
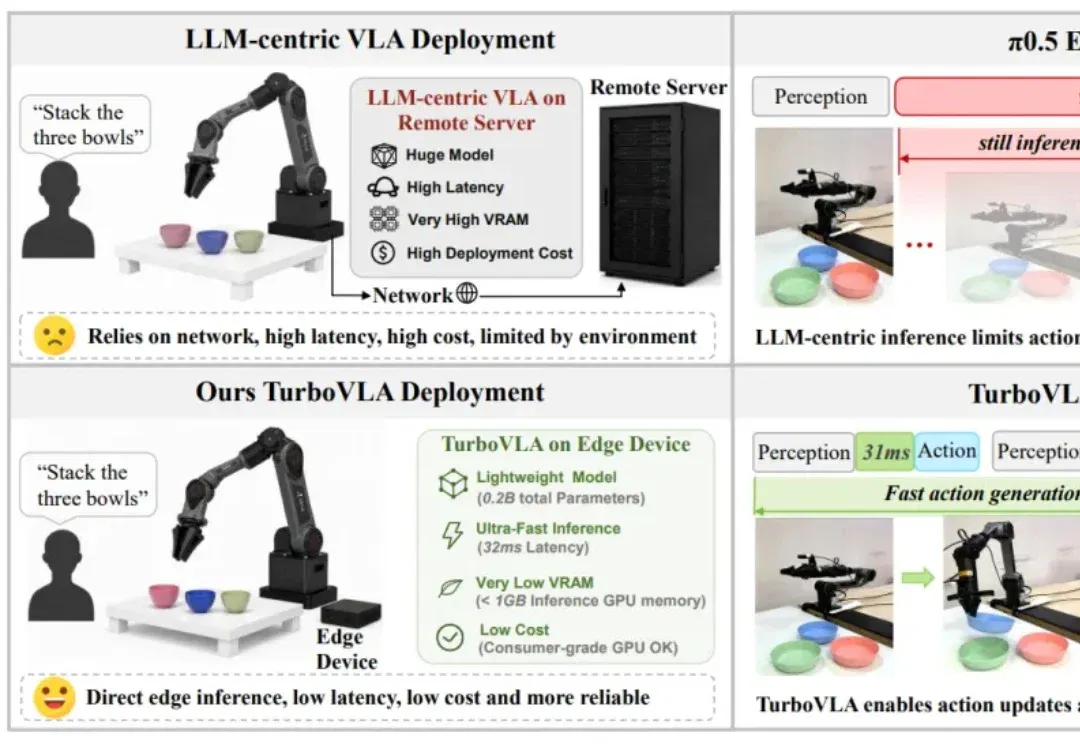
近年来,视觉 — 语言 — 动作模型(Vision-Language-Action Model,VLA)正逐渐成为通用机器人控制的重要技术路线,但当这些模型真正进入高频闭环执行时,一个矛盾越来越突出:模型越来越大、语义能力越来越强,动作更新却未必足够快。
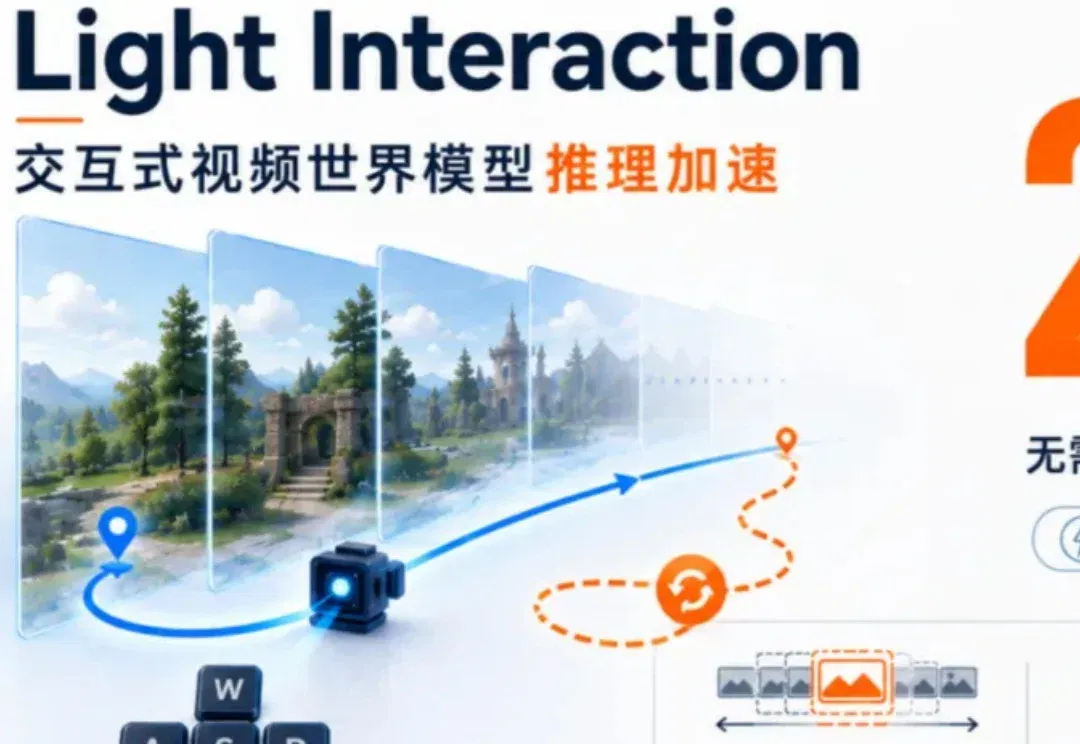
交互式视频世界模型正在从「一次性生成短片」走向「像游戏一样边操作边生成」。但长轨迹交互会迅速放大上下文、显存和多步去噪开销。Light Interaction不改模型参数、不重新训练,只在推理阶段把相机轨迹变成调度信号,动态选择历史上下文、在回访状态复用去噪输出,并用面向自回归生成的3D稀疏注意力降低计算。
AI旅行社 Fora 宣布完成一轮由 Forerunner 和 Tactile Ventures 领投的 6000 万美元 D 轮融资 ,公司估值达 10 亿美元。 Fora 成立于 2021 年,是一个双重平台:它通过提供支持客户沟通和旅行规划的基础设施,让人们可以轻松成为旅行顾问;
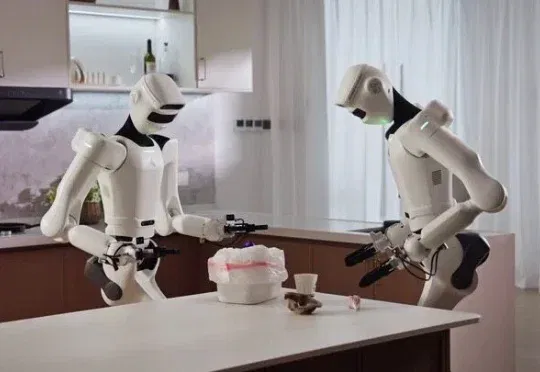
WAIC 前夕,星尘智能(Astribot)新模型 Lumo-2,直接在官网甩出 20 + 真机视频 ——这背后,是星尘智能发布的第二代具身基座模型,也是业内首个面向家庭场景的隐式世界 - 动作模型(Latent World-Action Model),同步发的,还智能体 Agent Philia。