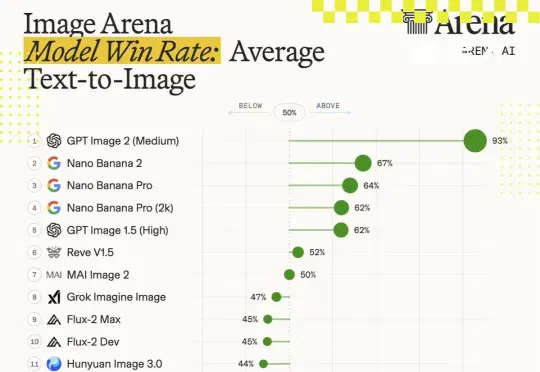
深扒GPT Image 2:疑似“吞”下了GPT-4o,OpenAI没把它当“生图”模型训练(在新窗口打开)
GPT Image 2 凭什么这么强?是扩散模型又迭代了一版?是把 DiT 的参数量从 7B 扩到 20B?是训了更多高质量数据?先给结论:OpenAI 很可能已经不在“纯扩散模型”这条主赛道上了。他们已经把图像生成从“美术课”调到了“语文课”——用一个能读懂指令、能记住上下文、能理解物体关系的 LLM 主导语义规划,至于最后一步的像素生成,可能由扩散组件或其他解码器完成。
共 65 篇
GPT Image 2 凭什么这么强?是扩散模型又迭代了一版?是把 DiT 的参数量从 7B 扩到 20B?是训了更多高质量数据?先给结论:OpenAI 很可能已经不在“纯扩散模型”这条主赛道上了。他们已经把图像生成从“美术课”调到了“语文课”——用一个能读懂指令、能记住上下文、能理解物体关系的 LLM 主导语义规划,至于最后一步的像素生成,可能由扩散组件或其他解码器完成。
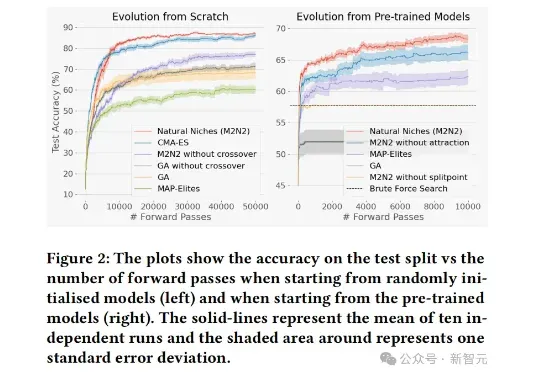
Sakana AI以自然演化为灵感,提出了一种全新的模型融合进化方法M2N2。通过引入自然界的「择偶机制」,AI可以像生物一样「竞争、择偶、繁衍」。在当前全球算力短缺、模型训练实际规模受制的情况下,Sakana AI借助自然界的启示,为模型融合探索出了一条新路。
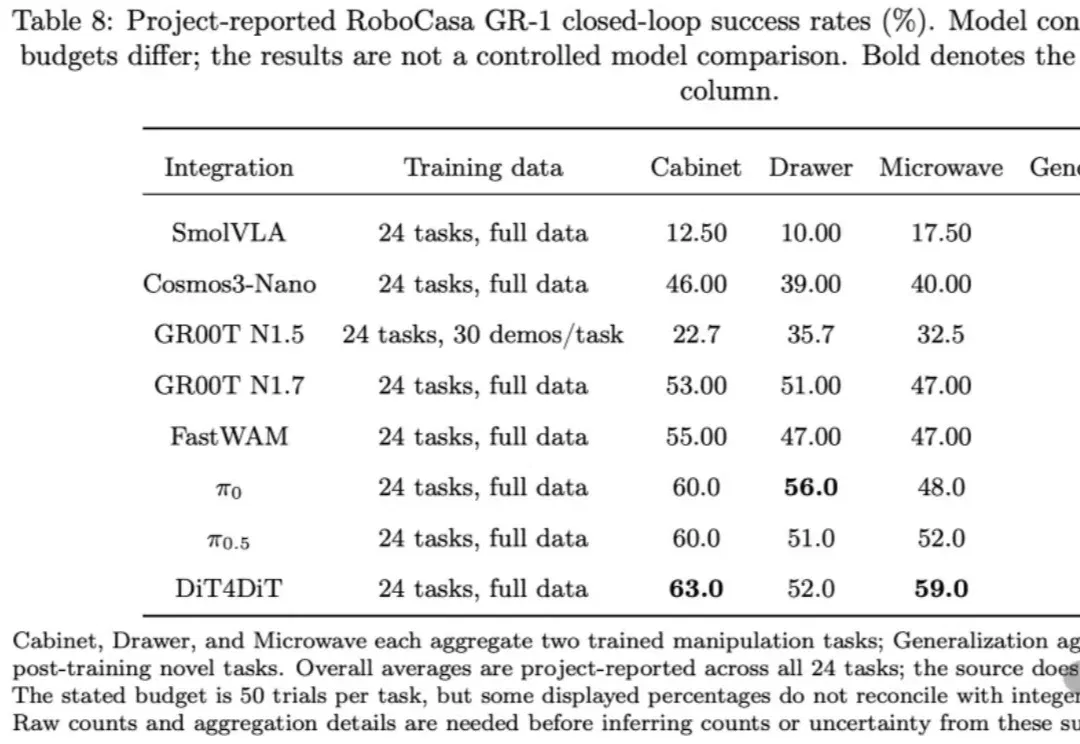
逐际动力更新 FluxVLA Engine 技术报告,补充在线强化学习、仿真评测和多种机器人平台的部署链路。统一配置、数据接口、推理加速与动作衔接旨在减少重复工程;报告中的性能增益来自特定模型和设备组合,仿真高分与真机任务完成率仍需分别看待。

融资资金将用于扩大前沿模型研究、提升模型训练算力等。 编译 | 杨京丽 编辑 | 李水青 智东西9月8日消息,今日,法国AI公司Mistral宣布完成30亿欧元(约合人民币234亿元)D轮融资,投后估
事情果然和大家预想的一样! 出走创业的LeCun,反手就把Meta(FAIR)6年老将挖走了。 被挖的小哥叫John Nguyen(以下简称John哥),属于那种名校一毕业就加入Meta的人。 6年时间,John哥几乎完整经历了FAIR这一轮技术演进的所有关键节点: 从最早的联邦学习(Federated Learning),到后来的大模型训练,再到多模态,John哥逐渐成长为FAIR团队的中坚力量。 本以为马上就能跨入“世界模型”大门了,结果没想到Meta突然甩出一堆“骚操作”(懂的都懂)。 最终结局是,曾创立FAIR的LeCun润了、FAIR整个部门也被逐渐边缘化……总之就是一团糟。 所以,
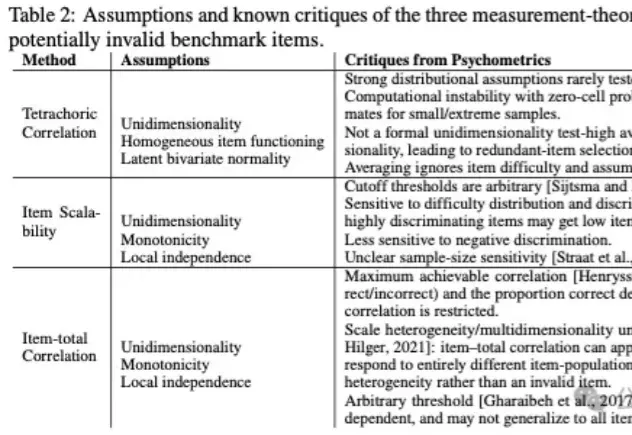
基准测试(Benchmarks)在人工智能的发展进程中扮演着至关重要的角色,构成了评价生成式模型(Generative Models)性能的事实标准。对于从事模型训练与评估的AI研究者而言,GSM8K、MMLU等数据集的数据质量直接决定了评估结论的可靠性。
在金融、医疗等高度敏感的应用场景中,拜占庭鲁棒联邦学习(BRFL)能够有效避免因数据集中存储而导致的隐私泄露风险,同时防止恶意客户端对模型训练的攻击。然而,即使是在模型更新的过程中,信息泄露的威胁仍然无法完全规避。为了解决这一问题,全同态加密(FHE)技术通过在密文状态下进行安全计算,展现出保护隐私信息的巨大潜力。
幻觉并非什么神秘现象,而是现代语言模型训练和评估方式下必然的统计结果。它是一种无意的、因不确定而产生的错误。根据OpenAI9月4号论文的证明,模型产生幻觉(Hallucination),是一种系统性缺陷。
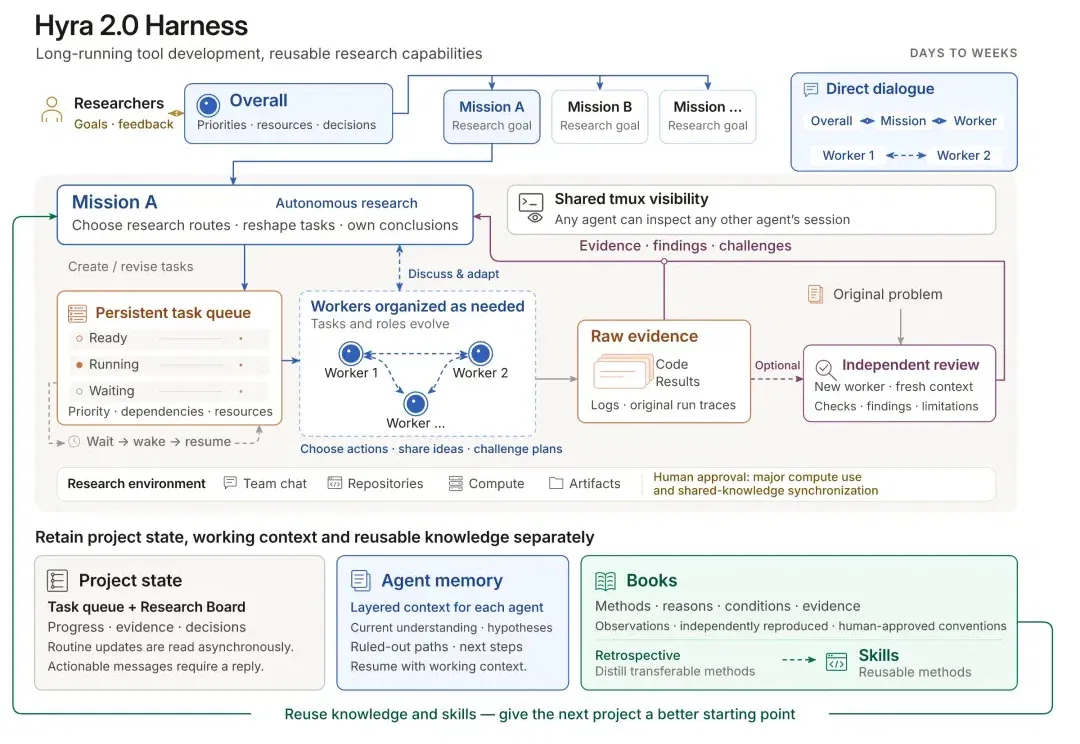
腾讯科研团队展示多智能体分工、模型训练和数学研究案例,并据报道讨论建设自主科学实验室的计划。
腾讯云大会以 Manifold AI、RoboScience 和 Zeroth 为例,介绍仿真数据、异构计算、存储及网络如何配合具身模型训练与部署。文中效率数字来自企业具体项目,不能据此认为购买GPU无用,或云端方案适合所有机器人任务。