搜索

关于“强化学习”的结果

共 198 篇

清华、NVIDIA、斯坦福提出DiffusionNFT:基于前向过程的扩散强化学习新范式,训练效率提升25倍

清华、NVIDIA、斯坦福提出DiffusionNFT:基于前向过程的扩散强化学习新范式,训练效率提升25倍(在新窗口打开)

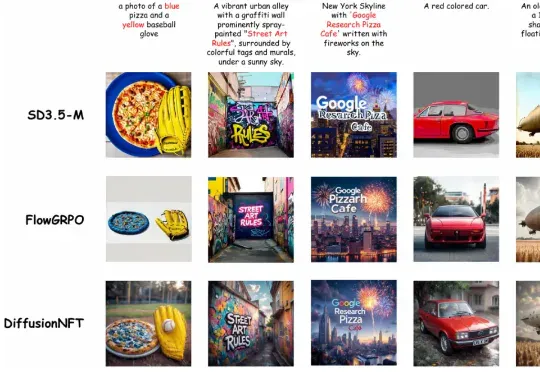
清华大学朱军教授团队,NVIDIA Deep Imagination 研究组与斯坦福 Stefano Ermon 团队联合提出了一种全新的扩散模型强化学习(RL)范式 ——Diffusion Negative-aware FineTuning (DiffusionNFT)。该方法首次突破现有 RL 对扩散模型的基本假设,直接在前向加噪过程(forward process)上进行优化
AI技术文章
0
Kimi开源又放大招!20秒更新万亿参数的中间件来了

Kimi开源又放大招!20秒更新万亿参数的中间件来了(在新窗口打开)

Kimi开源又双叒放大招了! 一个中间件,就能让Kimi K2的万亿模型参数进入“秒更时代”。 不仅支持一次性把更新完的权重从一个节点同时发送给所有节点,还能实现点对点动态更新。 网友也算是大开眼界了,可谓频频惊叹。 下面让我们一起看看这个中间件到底是如何发挥大作用的。 20秒更新万亿参数 此中间件名为checkpoint-engine(检查点引擎),主要用于强化学习中的一个关键步骤——在大语言模型推理过程中更新模型权重。 借助此组件,Kimi-K2只需约20秒就可实现在数千个GPU上更新1万亿参数。 与Kimi k1. 5类似,K2在同步强化学习训练中采用了混合共置架构,即训练引擎和推理引擎

AI技术文章
0
手把手带你入门机器人学习,HuggingFace联合牛津大学新教程开源SOTA资源库

手把手带你入门机器人学习,HuggingFace联合牛津大学新教程开源SOTA资源库(在新窗口打开)

HuggingFace 与牛津大学的研究者们为想要进入现代机器人学习领域的新人们提供了了一份极其全面易懂的技术教程。这份教程将带领读者探索现代机器人学习的全景,从强化学习和模仿学习的基础原理出发,逐步走向能够在多种任务甚至不同机器人形态下运行的通用型、语言条件模型。

AI技术文章
0
大模型推理学习新范式!ExGRPO框架:从盲目刷题到聪明复盘

大模型推理学习新范式!ExGRPO框架:从盲目刷题到聪明复盘(在新窗口打开)

大模型在强化学习过程中,终于知道什么经验更宝贵了! 来自上海人工智能实验室、澳门大学、南京大学和香港中文大学的研究团队,最近提出了一套经验管理和学习框架ExGRPO—— 通过科学地识别、存储、筛选和学习有价值的经验,让大模型在优化推理能力的道路上,走得更稳、更快、更远。

AI技术文章
0