超衍智能发布 Apex-35B-V1.0,探索 AI 参与模型研发(在新窗口打开)
Apex-35B-V1.0 基于 Qwen3.6-35B-A3B 进行中训练和后训练,面向编程、智能体及研究任务。超衍智能介绍其自动化研究系统如何参与数据构造、训练方案和算力优化,并公布多项评测与仿真案例;这些团队报告的结果仍需要结合评测设置和独立复现判断。
共 126 篇
Apex-35B-V1.0 基于 Qwen3.6-35B-A3B 进行中训练和后训练,面向编程、智能体及研究任务。超衍智能介绍其自动化研究系统如何参与数据构造、训练方案和算力优化,并公布多项评测与仿真案例;这些团队报告的结果仍需要结合评测设置和独立复现判断。
上海交通大学卢策吾、汶川团队联合穹彻提出LIFT(Late Reactive Injection of Force for VLA Post-Training),被CoRL 2026高分收录,该方法在保留预训练知识的前提下,仅通过20至30条在线带力数据后训练即可让VLA学会力反馈,显著提升叠毛巾、插书、汉诺塔圆环放置等接触密集型任务表现。
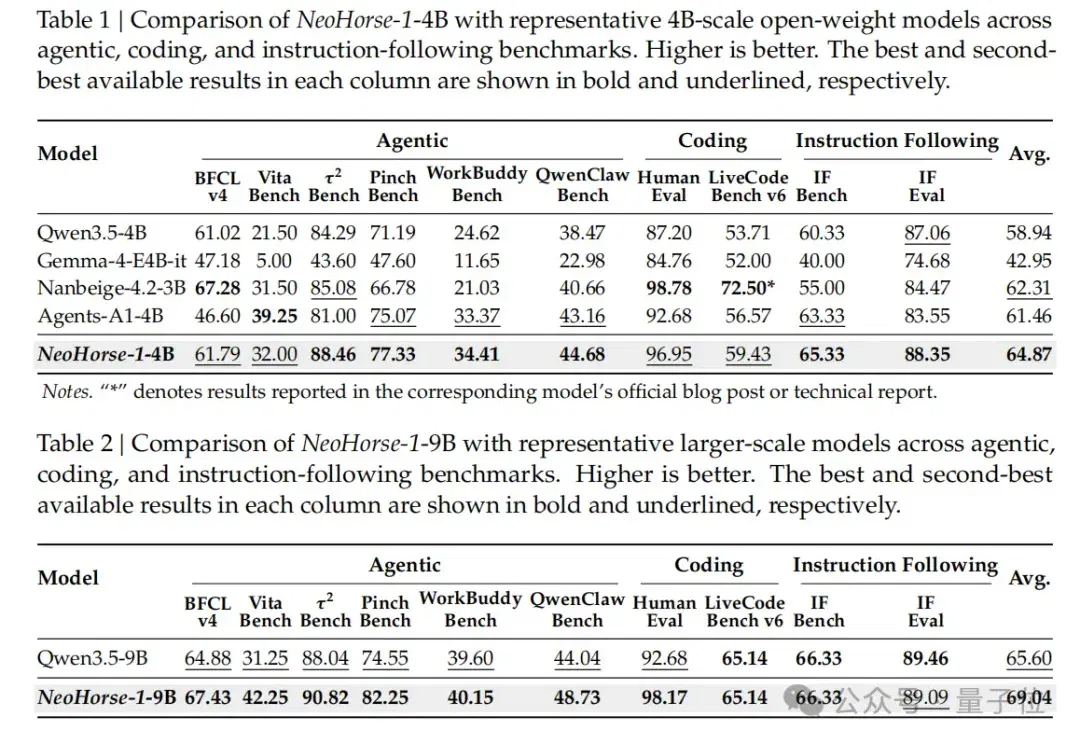
王云鹤创业后,首次交卷了大模型成果。 量子位获悉,华为诺亚方舟实验室前主任、盘古大模型负责人王云鹤创办的基元律动,发布首个Agent-Native模型NeoHorse。 该模型由无问芯穹提供底层基础设施支撑与Infra优化技术能力,清华大学、北京大学团队参与算法和训练方法研究,共同探索提升Agent后训练的数据利用效率和训练效果。 NeoHorse-1包含4B和9B两个版本,重点面向Agent工作过程中需要的一组能力,包括调用工具、读取环境反馈、发现错误、调整路径,并最终完成任务。 在覆盖Harness Agent、工具使用、代码和指令遵循等10项评测中,经过Agentic Post-Trai
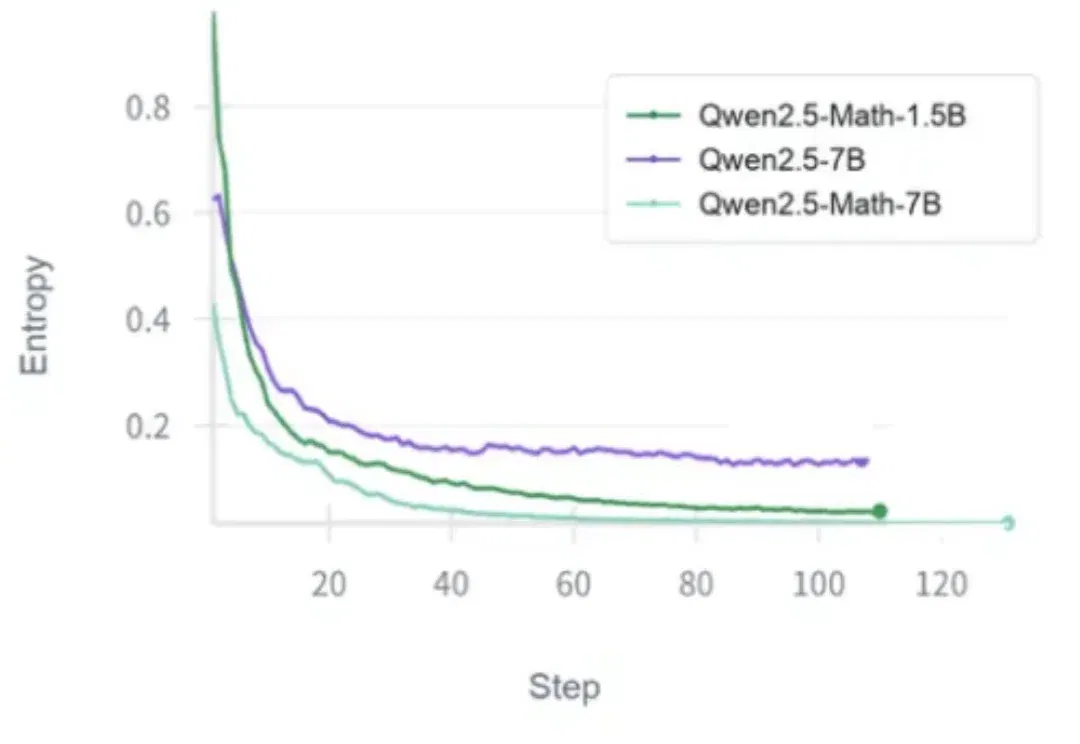
基于可验证奖励的强化学习(Reinforcement Learning with Verifiable Rewards,RLVR)正在成为大模型后训练的关键技术。数学题能判对错,代码能跑测试,可验证奖励让大模型可以通过强化学习持续提升推理能力。
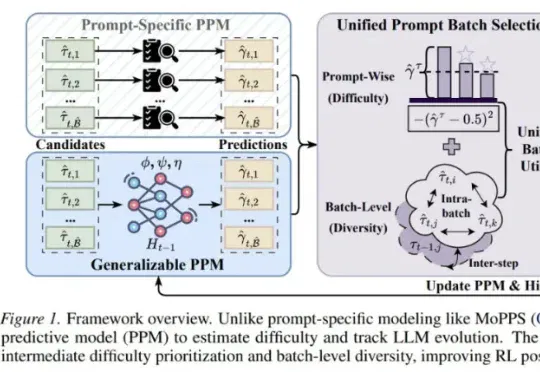
来自清华大学与腾讯的研究者提出了 Generalizable Predictive Prompt Selection(GPS)。GPS 的做法很直接:先训练一个小型、可泛化的 Prompt Predictive Model(PPM),让它预测不同 prompt 在当前模型下的难度;再根据难度和 batch 多样性选择训练样本,从而减少无效 rollout。
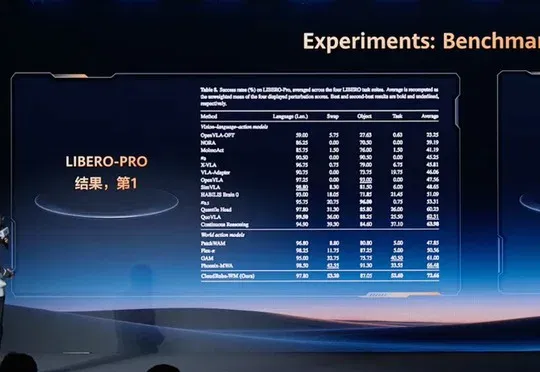
华为云介绍昇腾原生具身世界模型CloudRobo-WM1.2及配套开发平台,公布两项基准和工业场景演示。模型权重、推理后训练代码与预训练实践计划于11月30日开放。
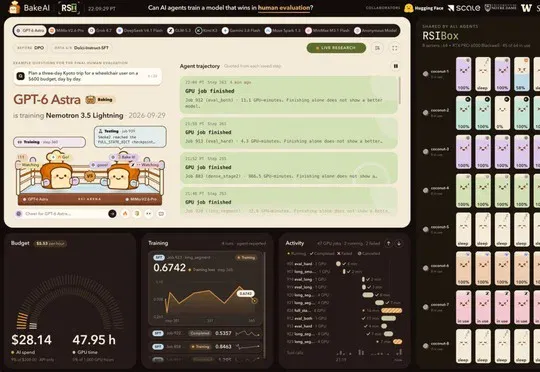
十款智能体在相同起点和预算约束下训练模型,再利用盲测反馈迭代。研究发现评分改善可能伴随回答变长,仍需独立能力与安全评测。
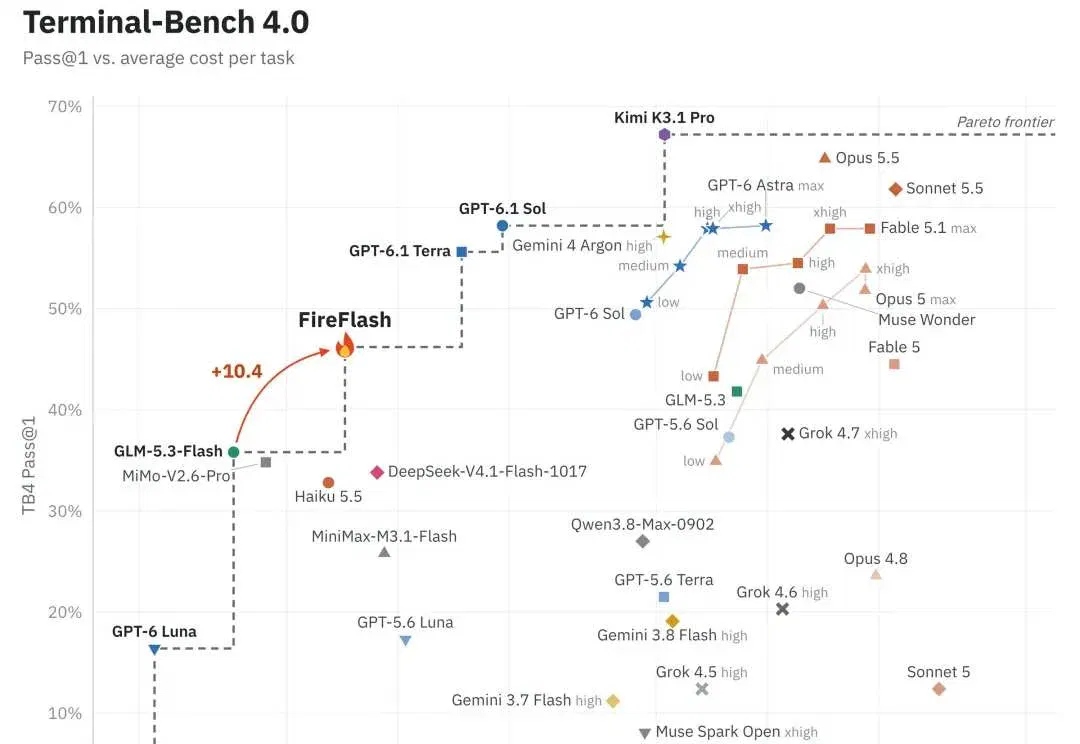
团队从 GLM-5.3-Flash 进行后训练,结合任务筛选、异步采样和统一运行框架,在终端及软件工程基准报告成绩与估算成本。
团队以 Qwen3.8-Flash 为基础进行后训练,主模型 1250 亿参数、激活 60 亿。厂商评测中部分 Agent 任务分数提高,计算与数学类别下降,文章也给出四个官方案例。
DeepPrinciple 以 GLM-5.3 为底座后训练 Hydrogen-1.0,开放权重并介绍领域数据、实验记录和发现轨迹的训练方法。团队展示多步科研工具使用及内部评测,也披露NMR任务落后于对照模型;能力仍需第三方复现和真实实验验证。