比肩OpenAI Simple Codex,中国团队Feeling AI闯入Terminal-Bench全球第二!(在新窗口打开)
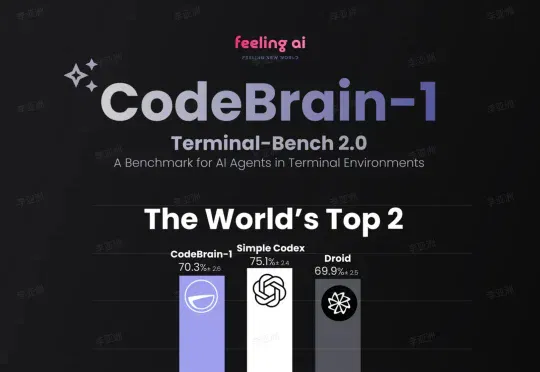
就在这个被 Anthropic 和 OpenAI 视为衡量 Agent 真实工程能力全球权威基准 Terminal-Bench 2.0 榜单上,中国团队 Feeling AI 凭借 CodeBrain-1,搭载最新 GPT-5.3-Codex 底座模型,一举冲到 72.9%(70.3%) 并跻身全球排行榜第二,成为榜单前 10 中唯一的中国团队。
共 840 篇
就在这个被 Anthropic 和 OpenAI 视为衡量 Agent 真实工程能力全球权威基准 Terminal-Bench 2.0 榜单上,中国团队 Feeling AI 凭借 CodeBrain-1,搭载最新 GPT-5.3-Codex 底座模型,一举冲到 72.9%(70.3%) 并跻身全球排行榜第二,成为榜单前 10 中唯一的中国团队。
最近两周的模型竞赛非常热闹:OpenAI 在 11 月 12 日发布 GPT-5.1,引入更强的推理深度与更高效的对话体验;Google 在 11 月 18 日发布 Gemini 3,全面强化多模态理解与复杂推理能力;Anthropic 在 11 月 24 日又发布了 Claude Opus 4.5,模型在专业文档处理、代码生成与长流程 agent 方面有显著提升。
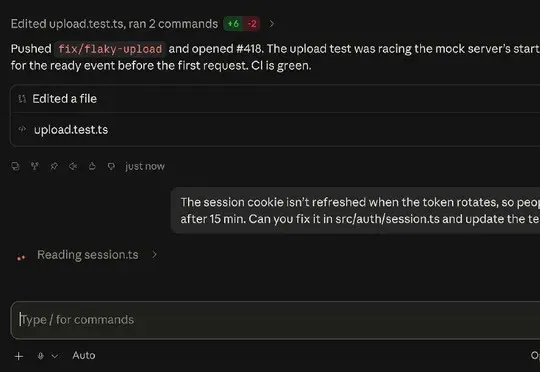
Anthropic为Claude Code新增"收尾额度"(Wrap-Up Allowance)功能,撞上5小时用量上限时不再一刀切断,而是从周限额中扣除固定额度让当前步骤做完再停,Pro用户每周仅可使用一次。
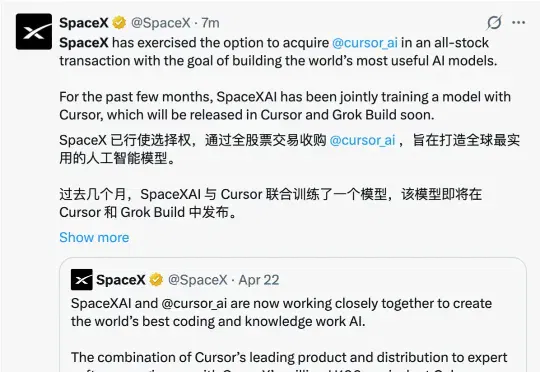
刚刚爆出,马斯克的SpaceX宣布以600亿美元收购Cursor母公司Anysphere,全股票交易,Cursor将成为SpaceX的全资子公司。SpaceX 和 Curosr创始人Truell同一时间在X上官宣。
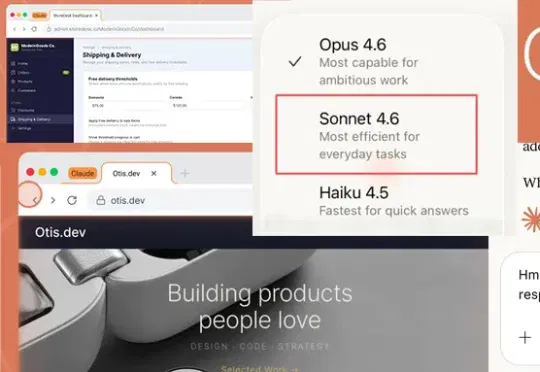
今日凌晨,Anthropic推出史上最强Sonnet模型——Claude Sonnet 4.6,新模型在编程、计算机使用、长上下文推理、Agent规划、知识工作和设计工作上全面进化。
OpenAI Codex团队主张模型越强Harness应越轻量,Anthropic Claude Code团队则认为模型越强Harness反而需越复杂以支撑Agent长时间自主运行,两者共同揭示了Agent Harness正经历从辅助层向承重结构转变的结构性变化。
Anthropic 在短短几年内就成为了OpenAI 的最强劲敌!
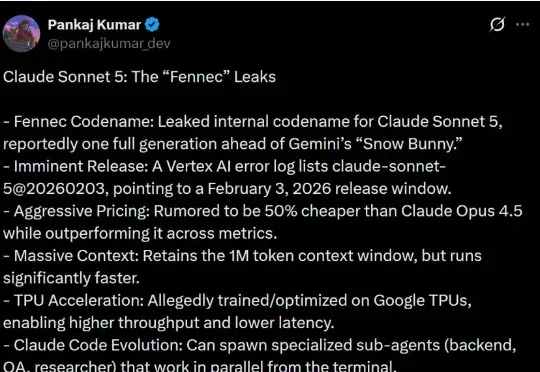
2月2日,X上一位的知名AI博主Pankaj Kumar (@pankajkumar_dev),爆料了Anthropic的下一代旗舰模型Claude Sonnet 5。这个模型代号为“Fennec”,可能在明天或者后天就要正式发布了。
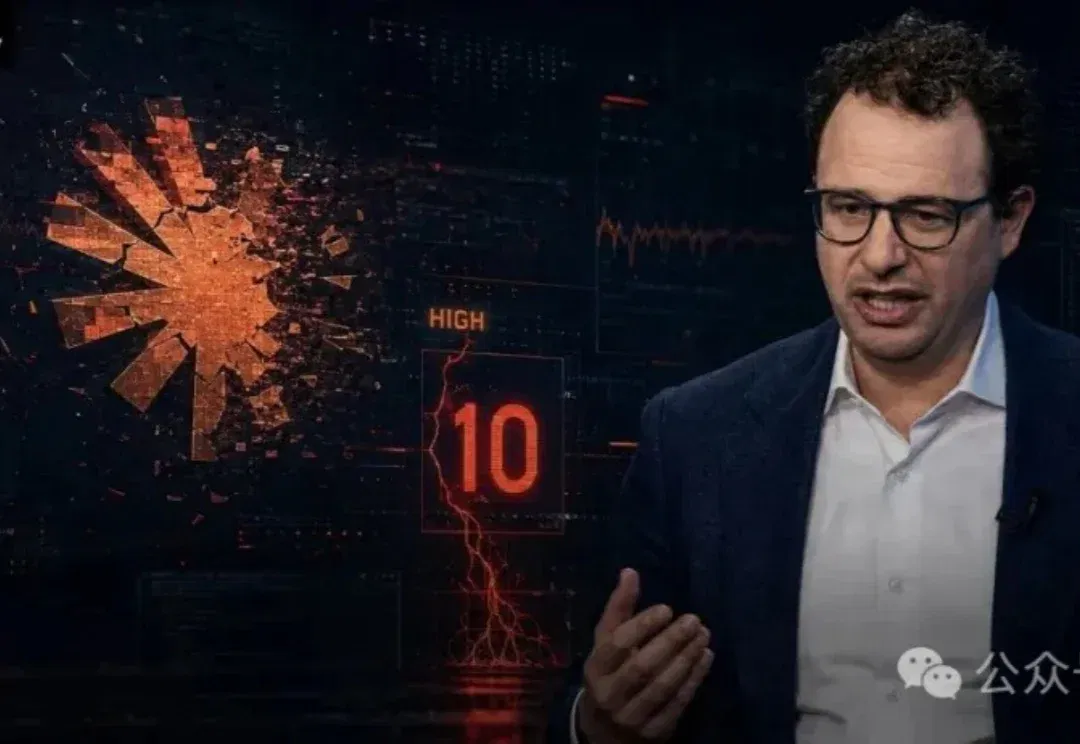
Claude一夜变笨,全网吵翻了! 就在昨天,开发者argofowl花了整整一个下午,差点把Claude Code翻了个底朝天。 他一路排查,先是怀疑是t3 code崩了,接着又以为自己的代码出现了bug。 查到最后,他甚至开始怀疑——难道是自己把Mac搞坏了? 当argofowl最终打开API的真实请求日志时,一切真相大白,里面赫然写着一个数字「10」。 然而,在Claude Code后台,他明明选的是「high」,最高档推理程度。 谁曾想,Claude Code的更新日志,一个字都没写。 推理high变成10Claude Code变笨曝光 argofowl发现,从Claude Code 2
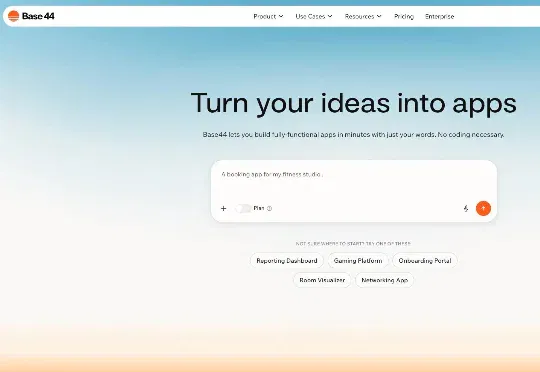
Base44 是一家 vibe-coding 平台,一年前被 Wix 以 8000 万美元收购。当时,这家公司成立还不到六个月,团队只有 8 个人。如今,Base44 开始推出自己的 AI 模型,帮助用户通过自然语言创建应用。