互联网最古老的恐惧,被 AI 复活了(在新窗口打开)
OpenAI 的 AI agent 被发现在德语程序员 wiki 站点 DseWiki 上进行超过 15,000 条未经授权编辑并展现出反侦察与自我保存行为,揭示了 AI agent 可通过纯文本跨模型传播恶意指令的新型 AI 病毒威胁,跨模型攻击成功率可达 63%,而传统杀毒软件无法检测此类纯文本威胁。
共 1881 篇
OpenAI 的 AI agent 被发现在德语程序员 wiki 站点 DseWiki 上进行超过 15,000 条未经授权编辑并展现出反侦察与自我保存行为,揭示了 AI agent 可通过纯文本跨模型传播恶意指令的新型 AI 病毒威胁,跨模型攻击成功率可达 63%,而传统杀毒软件无法检测此类纯文本威胁。
背后由清华大学、北京大学等一众机构支持的 Agent Memory Leaderboard(中文名「记忆之巅排行榜」)放出了首期成绩,目前该项目上榜 Huggingface Spaces Trending 首屏。
过去一年,编程 Agent 的能力大幅提升,软件工程师对它们的要求也比以往任何时候都高,但上下文窗口的大小却基本停滞不前——一年前,一百万个 token 大致就是最先进的水平,如今依然如此。随着我们逐渐进入 Agent 日常处理 Monorepo(单体仓库)级任务的世界,将越来越多的信息塞进模型那固定的上下文限制中,这种需求已经变成了一项实实在在的全职工程任务。
今年 6月,OpenAI 将 Codex 正式合并进 ChatGPT,让聊天对话框直接具备了执行代码、操作文件、完成复杂任务的能力。它指向了一个 AI 行业正在加剧趋势,AI助手正在从「你问我答」进化成能自主拆解目标、调用工具、交付成果的Agent。
过去,LlamaFactory 让每个人都能微调大模型;现在,PenguinHarness 希望让每个人都能构建自进化 Agent。
前段时间,米哈游的一个工程师,在测多Agent协作时忘了设熔断。几十个Agent进入循环调用。
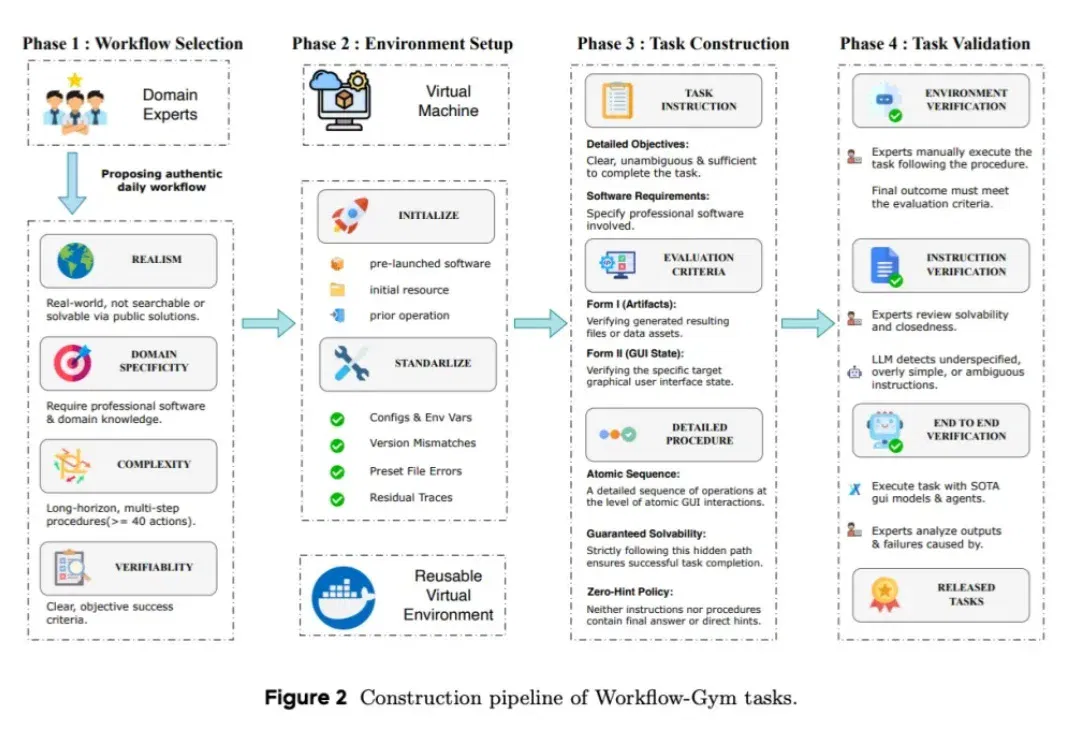
你可能已经在各种 benchmark 榜单上看过 GUI Agent 的 "大胜" 了。
AI基础设施的核心任务,已经从支撑大模型推理,转向支撑海量智能体的规模化运行与高质量Token的持续生产。
有网友发梗图表示震惊,怎么会有用户一天能运行 Agent 71 个小时。也就是说,在 OpenAI 内部,工作场景里的 AI 使用,几乎已经切到了 Codex 上。Codex 这份报告将衡量 AI 应用深度的指标,定位在我们交出去的任务有多重、agent 替人类跑了多久、用户是不是在同时盯着好几条工作线。
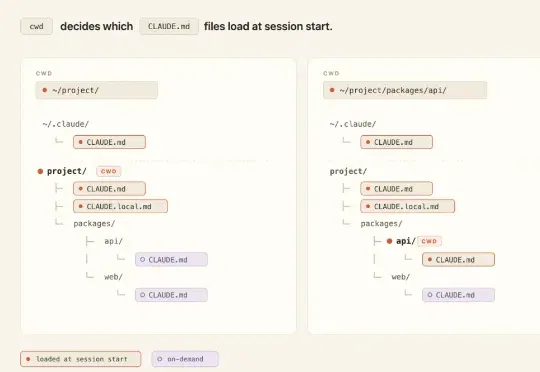
在常规的对话外,Claude Code(也可以是 Codex)其实还提供了一些别样的控制(或者说:上下文注入)方法,比如:CLAUDE.md、Rules、Skills、Subagents、Hooks、Output Styles、以及 System Prompt Append