搜索

关于“token”的结果

共 619 篇

智谱和 MiniMax,把大模型做成了两种生意

智谱和 MiniMax,把大模型做成了两种生意(在新窗口打开)

中国大模型商业化的一次分层。 两家中国大模型公司,在五天里先后交出了上市后的首份中报。 MiniMax 先出:上半年收入 1.17 亿美元,同比增长 283%;8 月 ARR 超过 8 亿美元。智谱随后公布:上半年收入 9.54 亿元人民币,同比增长近 400%;8 月 ARR 达到 16 亿美元。 如果只看 ARR,结论似乎很简单:智谱更高,MiniMax 紧随其后;两家公司都在讲 Token 调用量暴涨、企业客户增加、模型能力开始换来收入。 把数字放回财报,事情会变得复杂一些。 智谱上半年确认收入约 1.42 亿美元,MiniMax 为 1.17 亿美元,两者实际收入规模相差不远;两家的经
AI资讯
0
英伟达震撼首测Vera Rubin,DeepSeek吞吐暴涨30倍!

英伟达震撼首测Vera Rubin,DeepSeek吞吐暴涨30倍!(在新窗口打开)

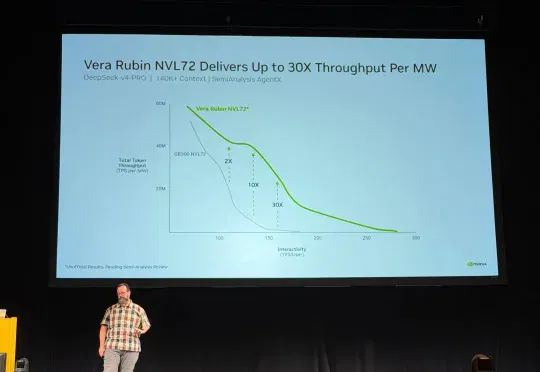
就在刚刚,英伟达史上首次公布了下一代旗舰级机柜 Vera Rubin NVL72 的首次片上实测数据。而且,这次实测直接拉来了DeepSeek-V4-Pro,跑最真实的「智能体编码」任务!结果令人吃惊:对比当前的主力机皇GB300 NVL72,Vera Rubin的每兆瓦吞吐量最高飙升了30倍、Token成本最高暴降了35倍!

AI资讯
0
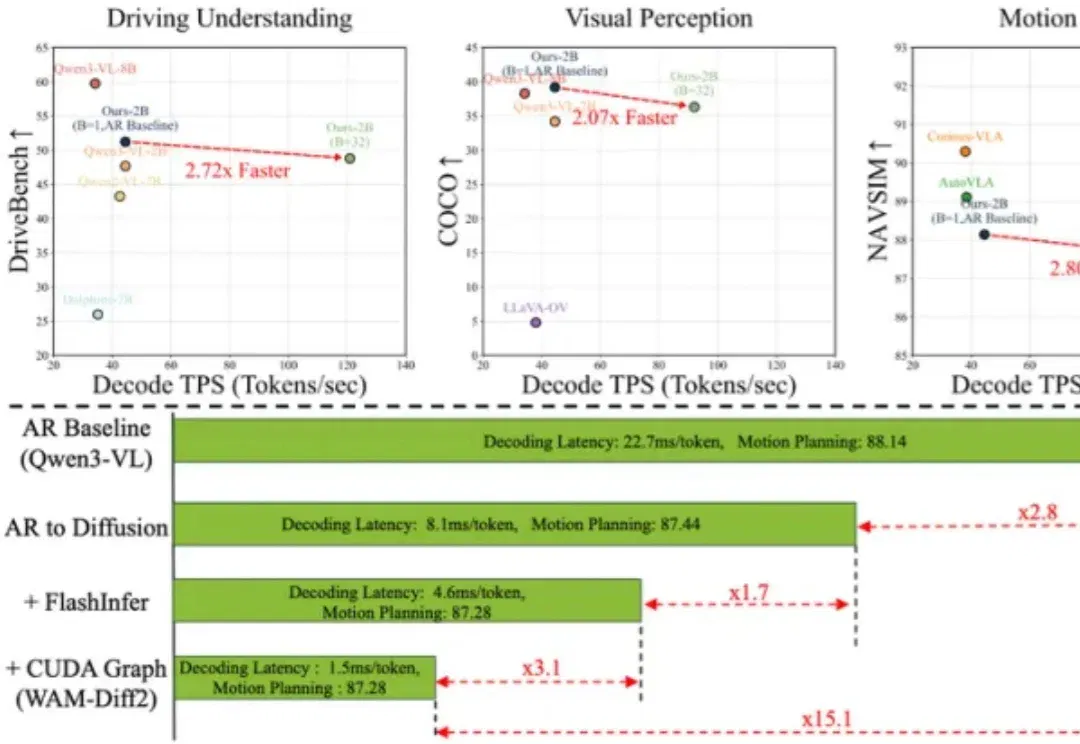
解码提速15.1倍、多任务性能不降:复旦&引望WAM-Diff2打通自动驾驶VLA自回归—扩散转换

解码提速15.1倍、多任务性能不降:复旦&引望WAM-Diff2打通自动驾驶VLA自回归—扩散转换(在新窗口打开)

视觉 - 语言 - 动作(VLA)模型已成为端到端自动驾驶的主流技术路线,但基于自回归(AR)解码的现有架构面临双重结构性瓶颈:其一,逐 Token 串行生成导致推理延迟随序列长度线性增长,严重制约实时部署;其二,训练阶段依赖真实前缀的 teacher forcing 机制,使模型在推理时暴露于自身生成的误差之上,引发长时序累积的曝光偏差(exposure bias)。

AI技术文章
0
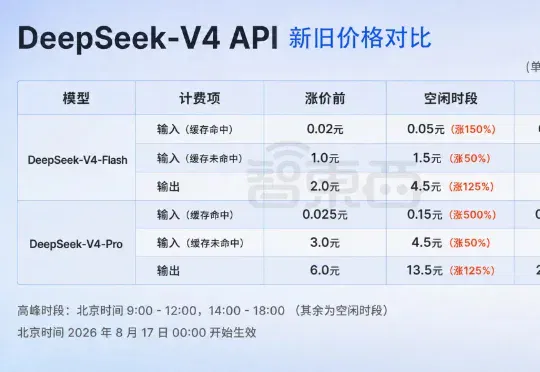
最高涨1100%!DeepSeek新定价今日生效

最高涨1100%!DeepSeek新定价今日生效(在新窗口打开)

今日零时起,DeepSeek正式执行新版API价格,DeepSeek-V4-Flash和DeepSeek-V4-Pro两款主力模型首次采用峰谷定价,闲时价格统一为高峰时段的一半。此次调整同步抬高了两款模型的基础价格。DeepSeek-V4-Flash高峰时段每百万Tokens缓存命中输入、缓存未命中输入和输出价格分别为0.1元、3元和9元,闲时分别降至0.05元、1.5元和4.5元。

AI资讯
0