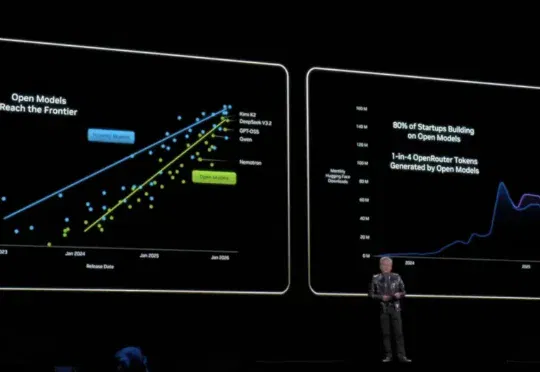
英伟达叫板DeepSeek?怒投260亿美元,要打造最强开源模型(在新窗口打开)
据 2025 年的一份财务文件显示,英伟达将在未来五年内投入 260 亿美元用于构建开源人工智能模型。据《WIRED》杂志报道,英伟达高管证实了这一此前从未被报道过的消息。
共 530 篇
据 2025 年的一份财务文件显示,英伟达将在未来五年内投入 260 亿美元用于构建开源人工智能模型。据《WIRED》杂志报道,英伟达高管证实了这一此前从未被报道过的消息。
百度再一次沦为了计量单位! 百度实习生创立4年的公司,市值正式超越百度,这可能是又一个deepseek时刻的开始。 就在3月10日,同在港股上市的MiniMax和百度悄然完成了位次调换,MiniMax的市值达到了3826亿港币,一举超过百度的3363亿。 前者近日接连暴涨,正是得益于最近火爆出圈的“全民养虾”潮,背后直接利好大模型厂商,而包括MiniMax、月之暗面和智谱AI合称“龙虾三兄弟”。 其中MiniMax专注的多模态大模型,刚好踩中了大家养虾最大的痛点,那就是token消耗太厉害成本太贵。而MiniMax直接把token价格打到0.3美元/百万token的地板价,只有国际主流模型的1
今天刷到一张梗图,逗得我嘎嘎乐: 这阵子,OpenClaw 把大家搞得很上头,但 token 花钱如流水,月薪两万养不起一只「小龙虾」。 终于,腾讯 基于 OpenClaw 开源生态推出了一键安装版本 ——QClaw,主打简单、零门槛部署,无需准备服务器、无需输入命令行、无需额外配置 IM 工具,下载就能直接用。 咱们普通人也能玩上「龙虾」了。 和 OpenClaw 一样,它可以让人们通过对话聊天的方式操控自己的电脑,无需复杂配置,即可直连 DeepSeek、Kimi、MiniMax 等主流大语言模型。 若选择「自定义大模型」,千问、混元、豆包等也是随便选,但需要提供 API Key。 QCl
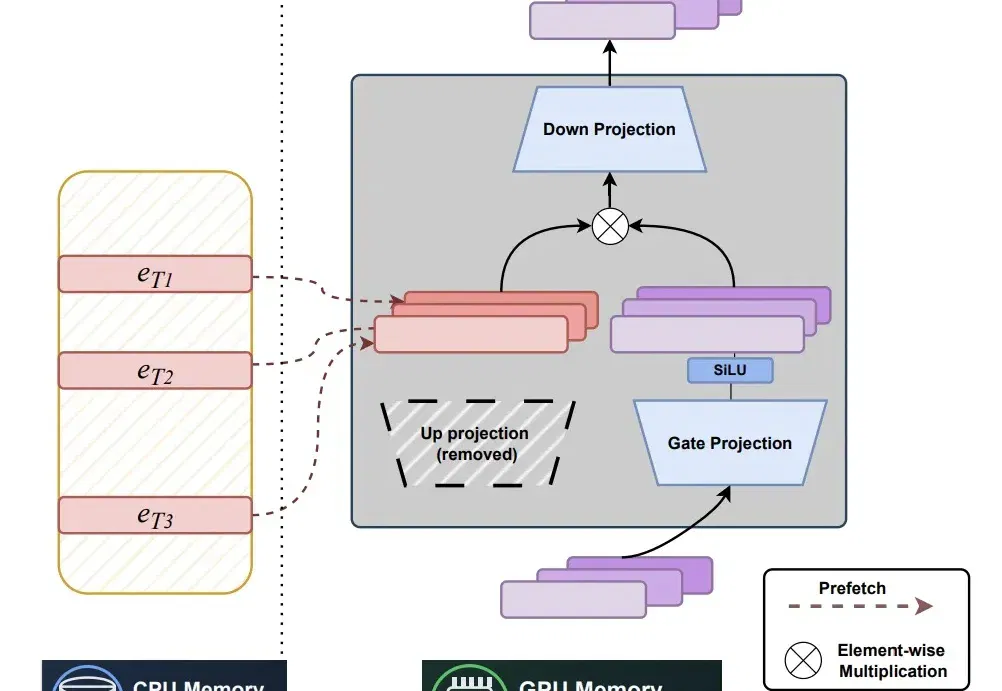
近年来,随着大语言模型规模与知识密度不断提升,研究者开始重新思考一个更本质的问题:模型中的参数应如何被组织,才能更高效地充当「记忆」。
这篇文章就想从更高层的角度抽丝剥茧:OpenClaw到底做对了什么,为什么是它火,以及这跟我们有什么关系。我有一个暴论:OpenClaw火的原因,和去年这个时候DeepSeek火的原因,是高度类似的。
机器之心编译 如果把人生看作一个开放式的大型多人在线游戏(MMO),那么游戏服务器在刚刚完成一次重大更新的时刻,规则改变了。 自 2022 年 ChatGPT 惊艳亮相以来,世界已经发生了深刻变化。在
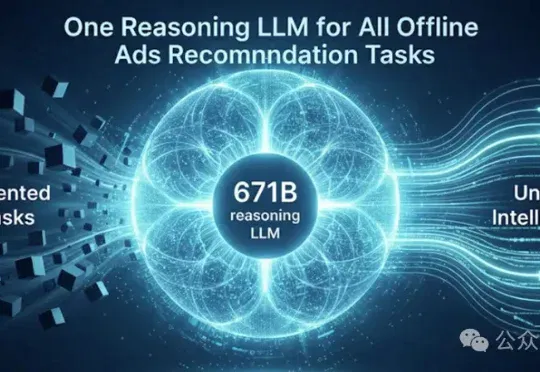
近日,微软Bing Ads与DKI团队发表论文《AdNanny: One Reasoning LLM for All Offline Ads Recommendation Tasks》,宣布基于DeepSeek-R1 671B打造了统一的离线推理中枢AdNanny,用单一模型承载所有离线任务。这标志着从维护一系列任务特定模型,转向部署一个统一的、推理中心化的基础模型,从
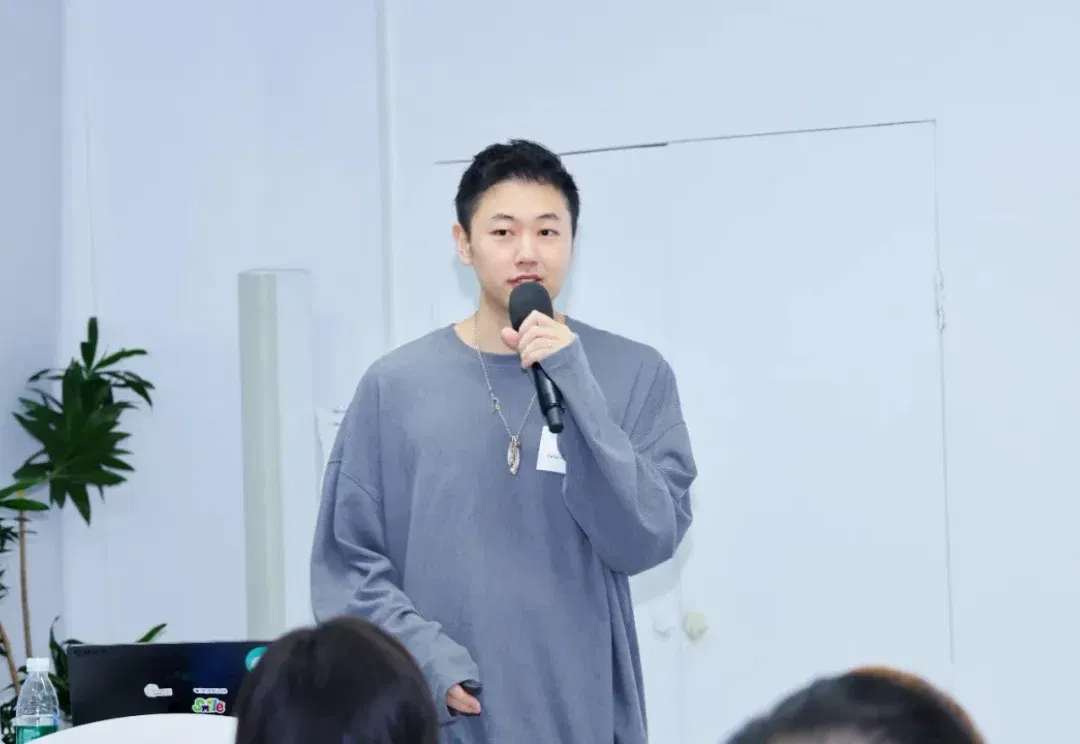
AI 时代,别搞虚的,真实才是必杀技。 最近,A 股市场上演了一出关于 GEO(生成式引擎优化)的概念热潮,20 多家公司股价坐上过山车,但这背后的焦虑却是真实的:在 AI 时代,如果豆包或 DeepSeek「不认识」你的品牌,你是否就被时代抛弃了? 这种焦虑切中了很多商家的痛点。GEO 到底是什么?它是真正的营销利器,还是又一轮割韭菜的把戏? 为了厘清这个概念,我们找到了深耕该领域的 Pallas AI 创始人、CEO Ethan。他在阿里待了十年,从阿里到达摩院到蚂蚁,最后一年担任 Ling 大模型首席架构师。从 2025 年 5 月开始,当 GEO 这个概念还只有极少人知道的时候,他已经
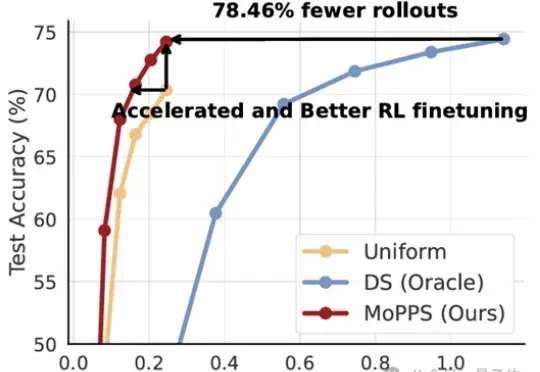
以DeepSeek R1为代表的一系列基于强化学习(RLVR)微调的工作,显著提升了大语言模型的推理能力。但在这股浪潮背后,强化微调的代价却高得惊人。
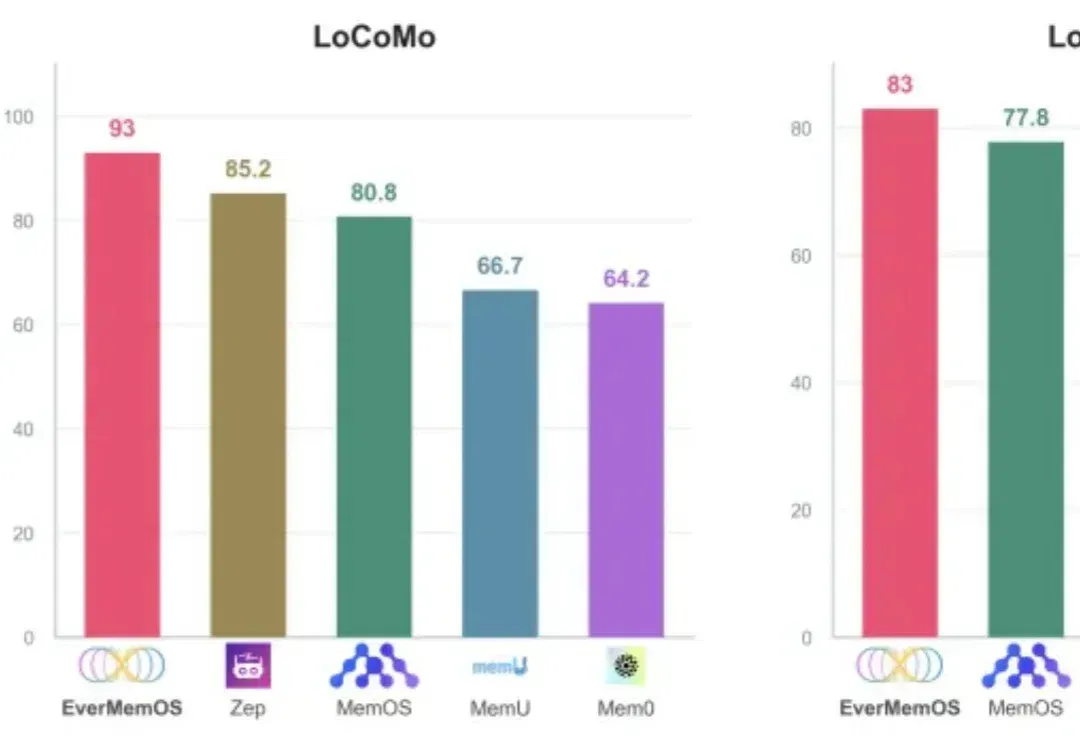
开年,DeepSeek论文火遍全网,内容聚焦大模型记忆。