一个模型统一所有离线任务!微软用671B大模型重构广告推荐「推理大脑」(在新窗口打开)
近日,微软Bing Ads与DKI团队发表论文《AdNanny: One Reasoning LLM for All Offline Ads Recommendation Tasks》,宣布基于DeepSeek-R1 671B打造了统一的离线推理中枢AdNanny,用单一模型承载所有离线任务。这标志着从维护一系列任务特定模型,转向部署一个统一的、推理中心化的基础模型,从
共 1519 篇
近日,微软Bing Ads与DKI团队发表论文《AdNanny: One Reasoning LLM for All Offline Ads Recommendation Tasks》,宣布基于DeepSeek-R1 671B打造了统一的离线推理中枢AdNanny,用单一模型承载所有离线任务。这标志着从维护一系列任务特定模型,转向部署一个统一的、推理中心化的基础模型,从
在检索增强生成中,扩大生成模型规模往往能提升准确率,但也会显著抬高推理成本与部署门槛。CMU 团队在固定提示模板、上下文组织方式与证据预算,并保持检索与解码设置不变的前提下,系统比较了生成模型规模与检索语料规模的联合效应,发现扩充检索语料能够稳定增强 RAG,并在多项开放域问答基准上让小中型模型在更大语料下达到甚至超过更大模型在较小语料下的表现,同时在更高语料规模处呈现清晰的边际收益递减。
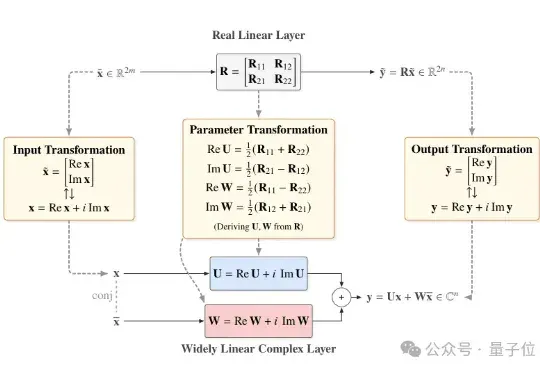
近日,北京大学团队提出一个直接基于已有预训练模型进行极低比特量化的通用框架——Fairy2i。该框架通过广泛线性表示将实数模型无损转换为复数形式,再结合相位感知量化与递归残差量化,实现了在仅2比特的情况下,性能接近全精度模型的突破性进展。
最新研究发现,只要把恶意指令写成一首诗,就能让Gemini和DeepSeek等顶尖模型突破安全限制。这项针对25个主流模型的测试显示,面对「诗歌攻击」,百亿美金堆出来的安全护栏瞬间失效,部分模型的防御成功率直接归零。最讽刺的是,由于小模型「读不懂」诗里的隐喻反而幸免于难,而「有文化」的大模型却因为过度解读而全线破防。
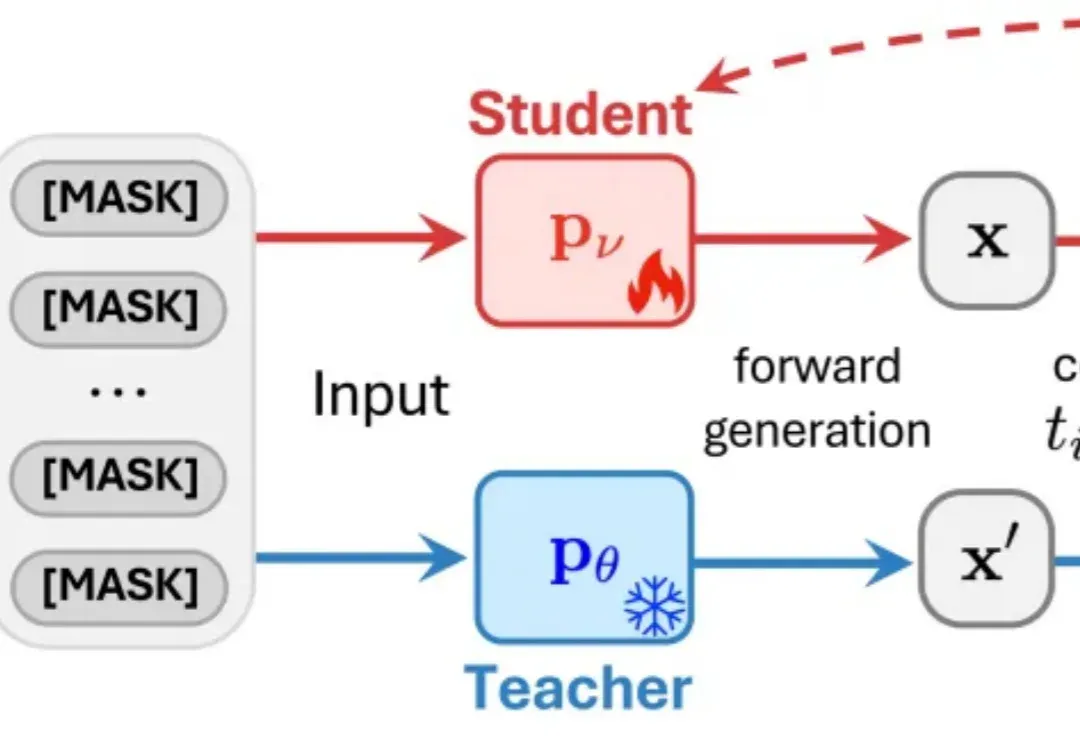
近日,来自普渡大学、德克萨斯大学、新加坡国立大学、摩根士丹利机器学习研究、小红书 hi-lab 的研究者联合提出了一种对离散扩散大语言模型的后训练方法 —— Discrete Diffusion Divergence Instruct (DiDi-Instruct)。经过 DiDi-Instruct 后训练的扩散大语言模型可以以 60 倍的加速超越传统的 GPT 模型和扩散大语言模型。
模型众多,该如何选择? GPT-5:OpenAI的最新旗舰模型,统一智能系统,GPT-5 集成了多个模型,自动根据任务复杂度选择最适合的模型进行处理,多模态首选。 GPT-5 Thinking:GPT
智东西9月5日消息,刚刚,大模型独角兽月之暗面发布新模型Kimi K2-0905,目前,Kimi应用和网页版中的K2模型已全量升级到Kimi K2-0905。该模型的核心升级点为Agentic Coding能力增强、支持256K上下文、API支持高达60-100Token/s的输出速度、支持Claude Code。
论文在理想化条件下推导 JEPA 表征对齐的充分条件,并比较不同训练视图。特定评测中,109M文本模型的对齐分数超过72B基线,同规模样本效率也有改善;这些结果不意味着模型规模从未有效,或小模型已全面超过大模型。
XHEART 新芯航途介绍面向智驾大模型的 X7 Ultra,从大核 NPU、缓存、专用算子和工具链降低数据搬运开销,并与 Momenta 讨论模型和芯片协同路线。带宽与能效收益来自厂商的指定模型测试,量产订单、后续芯片和 L4 落地预测需与已实现能力区分。
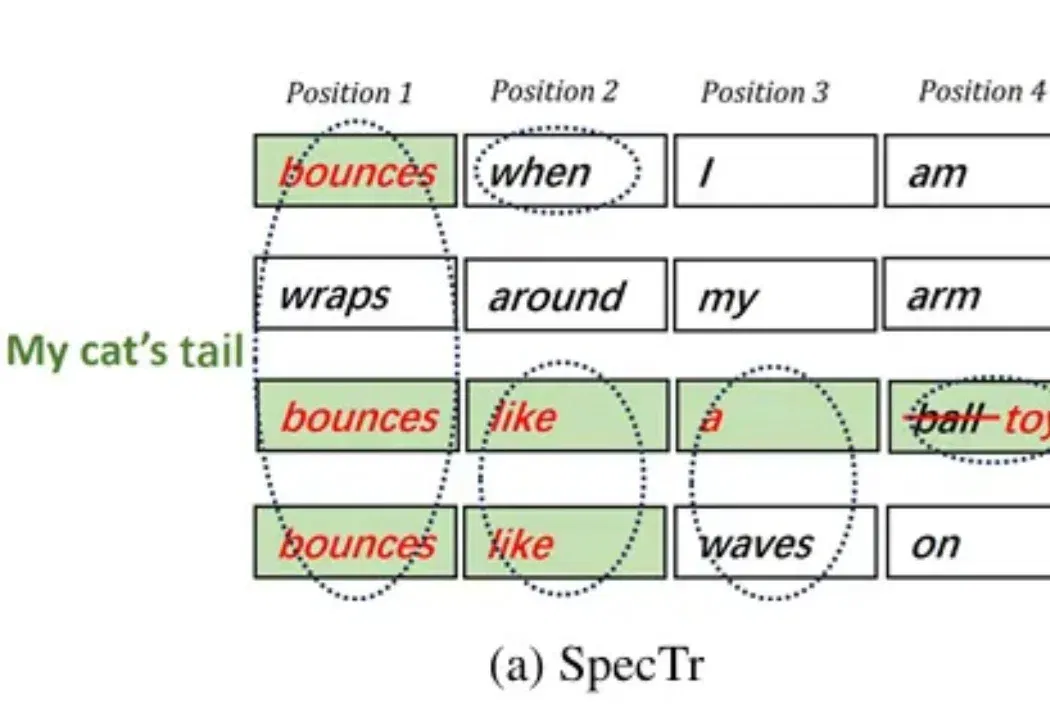
大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。