
DeepSeek V4.1 Flash实测,花3亿token,14组任务,居然比上代贵(在新窗口打开)
家人们,DeepSeek V4.1 Flash 开启内测了。
共 619 篇
家人们,DeepSeek V4.1 Flash 开启内测了。

这几天,大家应该都用GPT-6 Astra了吧。

视觉编程成绩超GPT-5.4。 智东西9月9日报道,今日,蚂蚁百灵正式开源其首个原生多模态大模型Ling-3.0-flash-VL。Ling-3.0-flash-VL是一款1240亿总参数的MoE模型,单次推理激活5.5亿参数,原生支持图像、文本和视频输入,上下文窗口达到256K Tokens。 此次蚂蚁同步开放了模型的BF16和FP8版本,开发者已经可以在Hugging Face和ModelScope下载模型权重,FP4和INT4版本也将在近期上线。 ▲Ling-3.0-flash-VL开源主页(图源:Hugging Face) 这款模型基于此前的Ling-3.0-flash拓展而来。相比纯
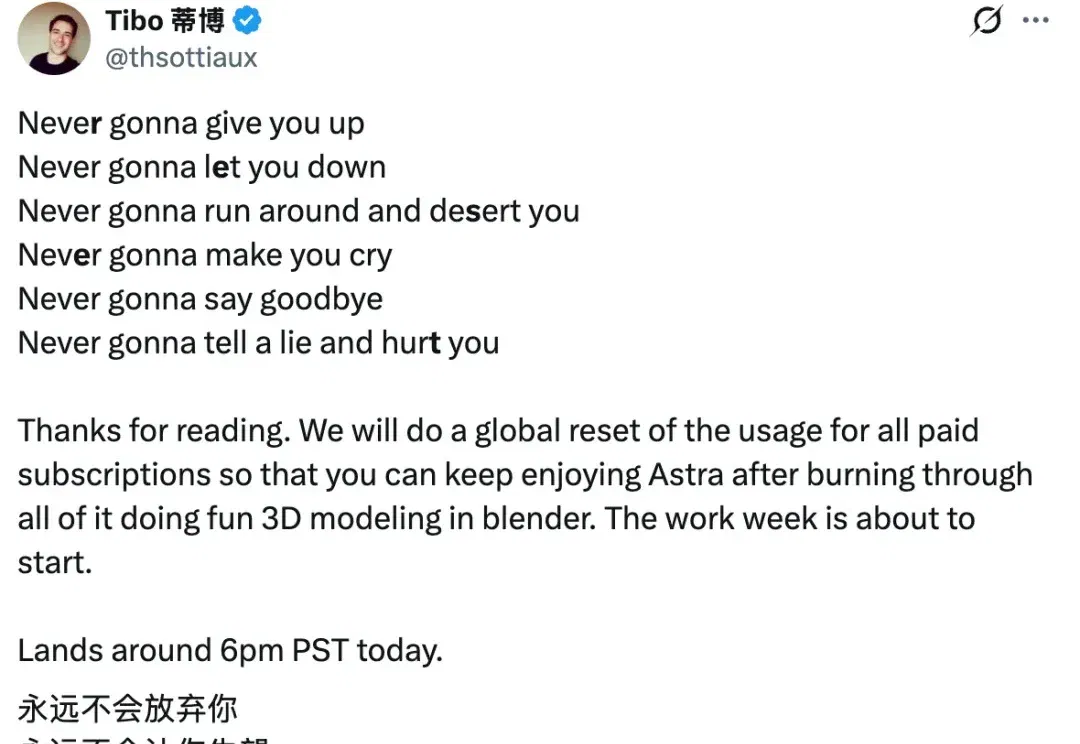
赛博义父Tibo,又来给大家送温(重)暖(置)了!!
“AI PC是个人计算的基础设施,而非云端AI的替代品。”
坚持 1 晚通宵,烧掉 2 亿 Token,用上 3D 打印,掏出 4 千账单,购置 512GB 内存 Mac Studio,Vibe Coding 到 6 神无主,7 荤 8 素,最终获得 0 个用户......
沙特人工智能公司HUMAIN基于中国MiniMax的开源旗舰模型MiniMax M3推出阿拉伯语大模型HUMAIN M3,使用超过1万亿Token阿拉伯语数据进行后训练,在七项阿拉伯语基准测试中等权平均分达89.37%,标志着中国开源模型正成为全球AI生态的底层技术基础。
清华姚班出身的彭天翼带队,Anthropic旗下Claude仅用11天、消耗60亿Token和1300万行代码,首次端到端形式化证明了困扰数学界350年的费马大定理,并产出29500条可验证中间定理,成为迄今为止最大的Lean证明。
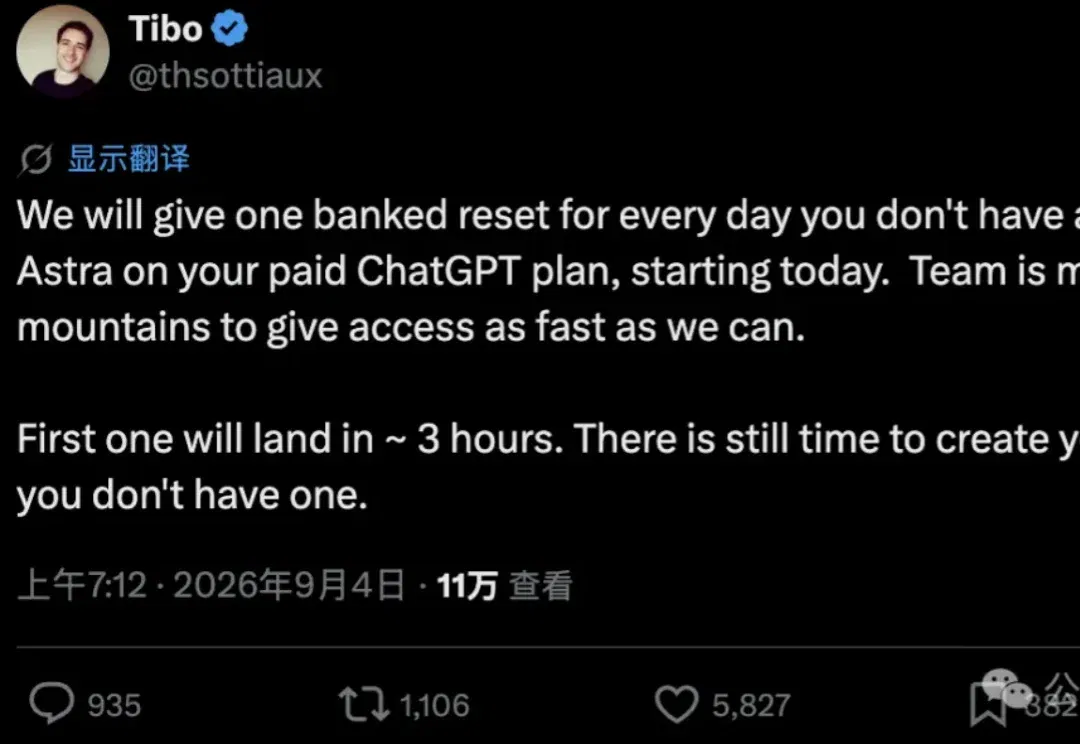
赛博义父Tibo这下升级赛博亲祖宗了。 只要你付费了但还没法用GPT-6 Astra,那么每天都能重置额度一次。 从今天起,第一个额度还有不到3个小时就发放了,没注册的抓紧注册吧。 而且是发放重置次数,可以自选重置时间。 那还等什么了?5.6 Sol Ultra+极速模式+/goal模式开蹬! 就这还有人不满足,还想要Pro用户提前体验GPT-6。 另外还有一个好消息,GPT-6 Astra在做长程任务时超过272K tokens上下文的部分,不再增加额度消耗倍率。 那么说了这么多,GPT-6 Astra什么时候能开放呢? 具体也没定好,只能说尽快,下次一定。 在GPT-6来之前,可以先做3件
训练一个大模型之前,语料需要经过解析、清洗、去重、质量评分、Token化和样本组装。