产品经理就别出来装AI 人才了(在新窗口打开)
前“华为天才”李博杰的一条吐槽小作文,喜提热搜。相信大家都看了,我就不在这里写了。这个事儿上热搜能理解的,一个是前“华为天才”的标签(虽然也有人说华为天才也不少),一个是当红国产模型炸子鸡deepseek
共 530 篇
前“华为天才”李博杰的一条吐槽小作文,喜提热搜。相信大家都看了,我就不在这里写了。这个事儿上热搜能理解的,一个是前“华为天才”的标签(虽然也有人说华为天才也不少),一个是当红国产模型炸子鸡deepseek
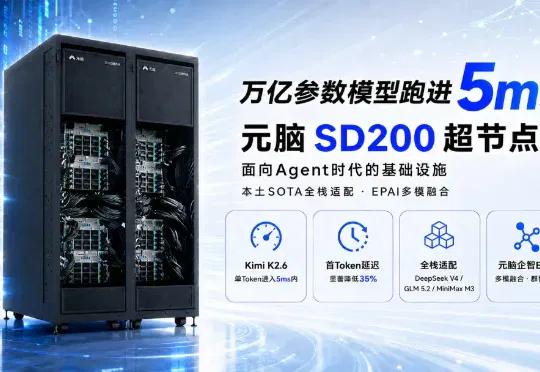
浪潮信息宣布,元脑SD200超节点AI服务器率先完成主流领先开源大模型Kimi K2.6、DeepSeek V4、GLM 5.2、MiniMax M3等的高性能优化,并在Kimi K2.6万亿参数大模型上实现Token生成时间快达4.77ms,为Agent场景应用的高效运行提供强大算力支撑。
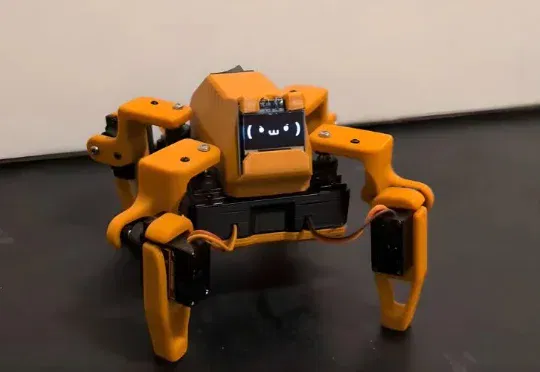
乐鑫喵伴 EchoEar EchoEar 喵伴 AI 机器人搭载的 ESP-Brookesia 框架实现全双工语音交互、多模态识别与智能体控制,构建更具沉浸感的人机交互体验。 EchoEar 套件以端
2026 年,风向掉头了。几个最受关注的年轻 AI 人才,开始走进大厂。罗福莉,四川宜宾乡村出身,北大硕士,DeepSeek-V2 作者之一。被雷军点名后,“天才少女”四个字在热搜上挂了很久。她去了小米,负责大模型 MiMo。
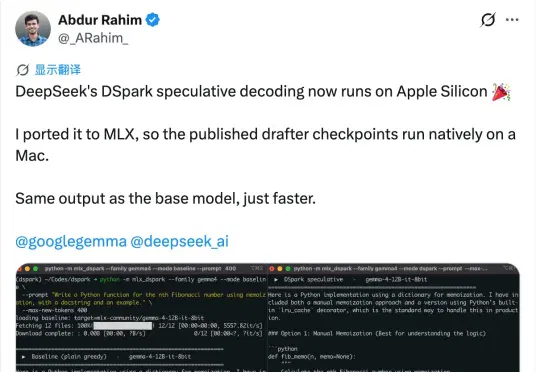
DSpark刚开源一周,就被搬进了苹果电脑。移植版本叫mlx-dspark,跑的是Gemma-4 12B和Qwen3-4B这两个模型。装上之后,这两个模型在Mac上的生成速度分别提了1.6倍和1.4倍。
7月2日,据大厂日爆消息,美团内部开始限制使用豆包大模型。消息称,美团向所有涉及到豆包大模型的业务部门下发通知,要求自查并规划迁移至LongCat、DeepSeek等模型,若无法迁移,需单独走审批流程。对此消息,截至发稿,美团暂无官方回应。据媒体报道,这并非美团首次收紧外部大模型的使用。今年4月,美团对内部大模型使用做出调整,不再推荐业务使用阿里云提供的Qwen模型。若业务仍需使用,需上报审批。
你有没有想过一个问题: 我们平时选模型,到底有多少是因为它真的好用,又有多少是因为它便宜?
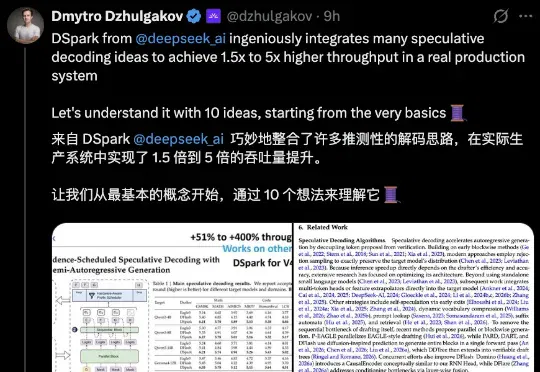
Fireworks AI的联合创始人兼CTO、PyTorch核心维护者Dmytro Dzhulgakov将整篇论文梳理成了10个概念,从最底层的GPU访存特性讲到最上层的在线自适应调度。DeepSeek这套方案真正的精髓在于系统工程和模型协同设计。
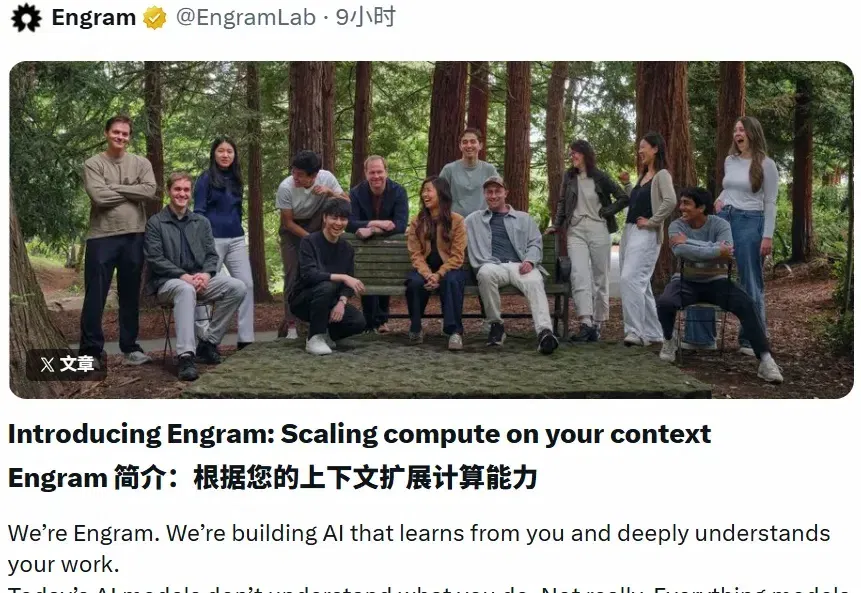
当大模型公司还在竞争更长的上下文窗口、更强的推理能力和更复杂的 Agent 工作流时,一家名为 Engram 的新公司选择押注另一个问题:AI 能不能像人一样,持续从每天接触到的资料、对话和经验中学习?
最新开源的Unlimited OCR,总参数3B,实际激活仅500M——放在大模型时代几乎是个零头。但就是这个小到离谱的模型,在OmniDocBench v1.5上拿下93.23%的综合分,v1.6更是达到93.92%,直接刷新了端到端SOTA。