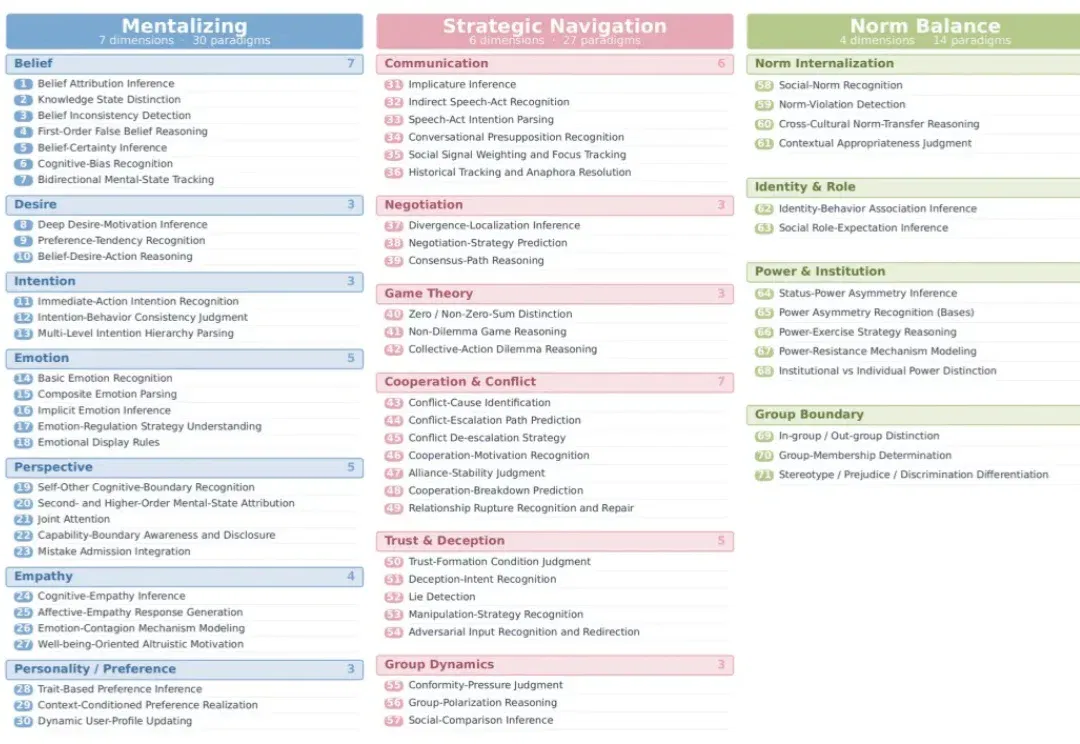
AI最尴尬的短板,中国科学院出手了(在新窗口打开)
GPT-5.5能写专业论文,DeepSeek-V4-Pro能生成复杂代码,具身机器人能完成基础物理操作,语言智能和工具智能都已经跑出了自己的赛道。
共 530 篇
GPT-5.5能写专业论文,DeepSeek-V4-Pro能生成复杂代码,具身机器人能完成基础物理操作,语言智能和工具智能都已经跑出了自己的赛道。
一夜之间,Tokenmaxxing成为硅谷热议话题!
2026年WAIC的展厅里,人潮涌动。大模型厂商在秀参数,算力厂商在秀集群规模。
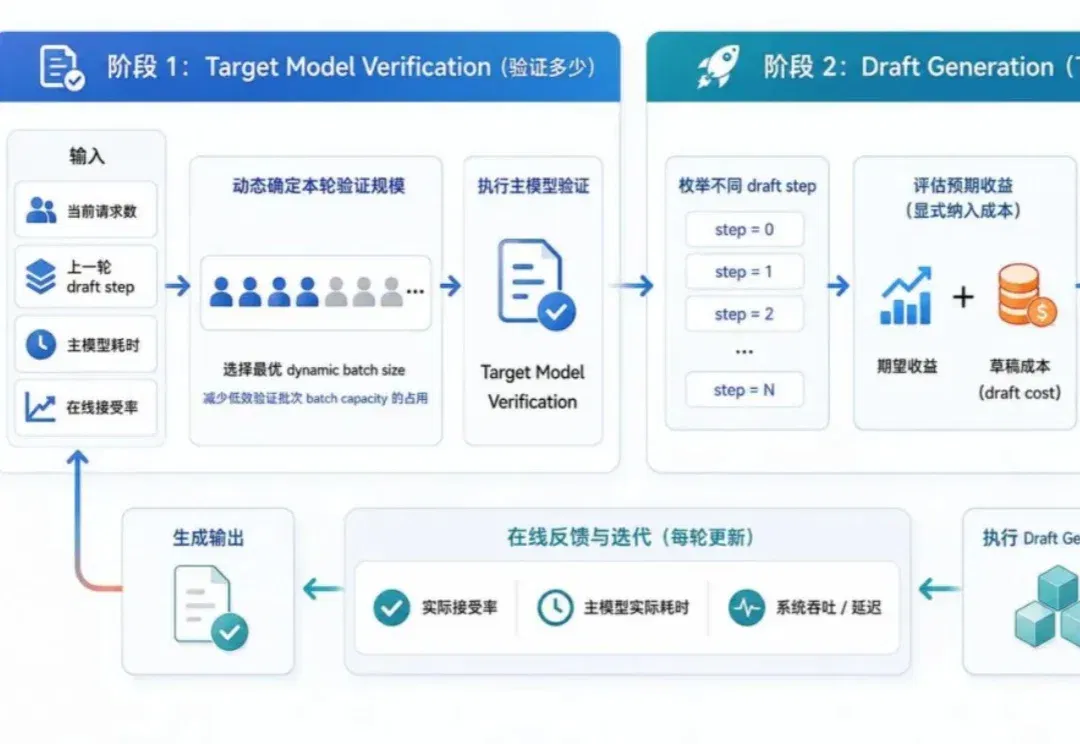
随着 DeepSeek 发布 DSpark,动态 MTP(多 Token 预测)成为了对抗高并发、提升 GPU 利用率的绝对焦点。然而,DSpark 高度绑定特定模型且需要额外训练。
7 月 16 日,月之暗面正式发布 Kimi K3:总参数量 2.8 万亿(2.8T),原生视觉理解,100 万 token 上下文,并且——开源权重。这是历史上第一个摸到 2.8 万亿参数量级的开源模型。前任"开源最大模型"的纪录保持者?也是它自己。
推理大模型 (如 DeepSeek-R1、o1) 靠长思维链拿高分,却普遍「想太多」: 研究统计了五个代表性模型里,发现有 41–52% 的 token 是在模型给出它的最终答案之后生成的。
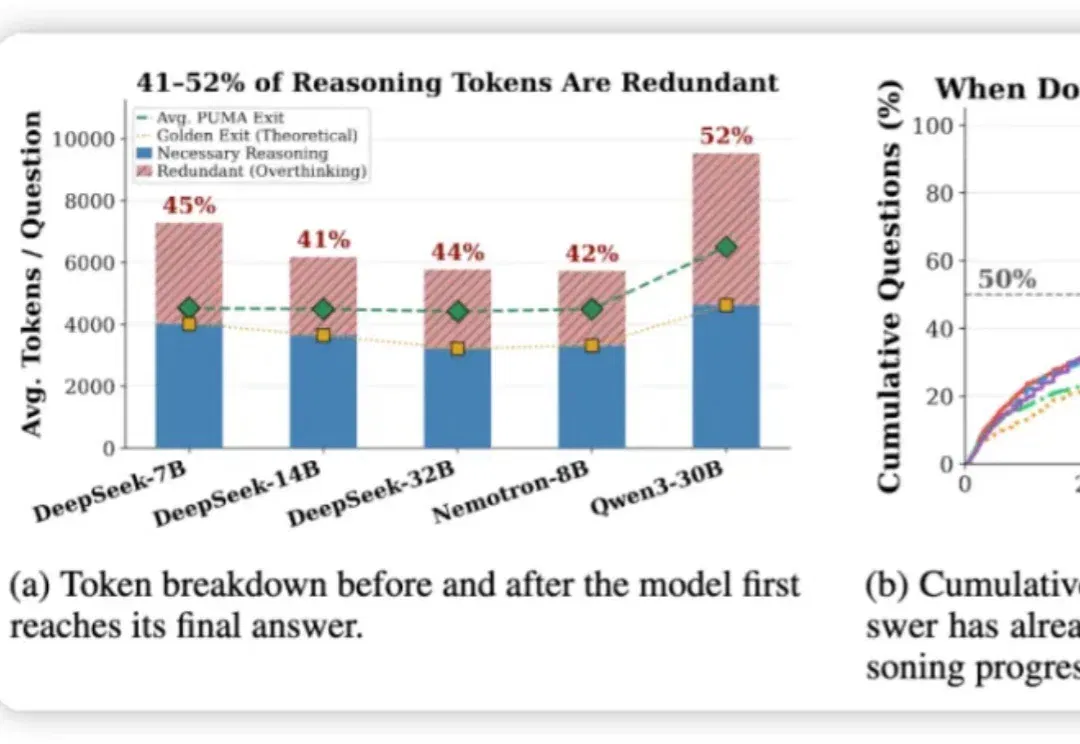
推理大模型 (如 DeepSeek-R1、o1) 靠长思维链拿高分,却普遍「想太多」: 研究统计了五个代表性模型里,发现有 41–52% 的 token 是在模型给出它的最终答案之后生成的。
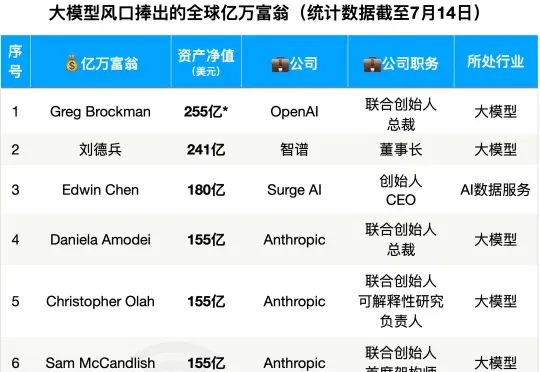
今日,彭博亿万富翁指数的最新数据显示,DeepSeek创始人、CEO梁文锋的资产净值已经达到360亿美元(约合人民币2440亿元),超越OpenAI联合创始人兼总裁Greg Brockman,跻身全球最富有的大模型创始人之列。
过去十几年,程序员面试早就形成了一套成熟的应试套路。背题、刷题、共享面经,一条龙服务,从几块钱的 PDF 到十几万的“包过内推”,每一个价位都有对应的产品。只要你花够时间准备,进大厂的概率不低。
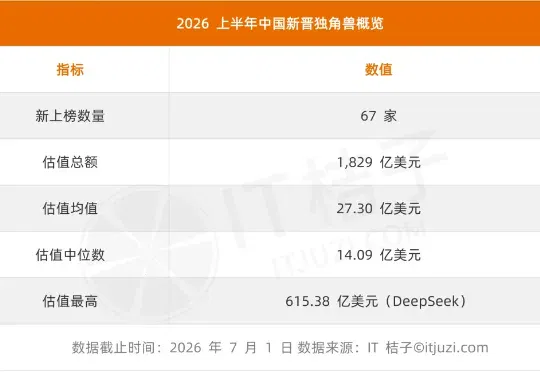
截至 2026 年 7 月 1 日,IT 桔子独角兽数据库信息显示,中国共有 517 家在榜独角兽企业,总估值约 2.39 万亿美元。从估值结构看,呈典型的金字塔分布——57.3% 集中在 10 至 20 亿美元区间,30.8% 在 20 至 50 亿美元,50 亿以上 62 家(12.0%),其中 500 亿美元以上的超级独角兽仅 5 家: