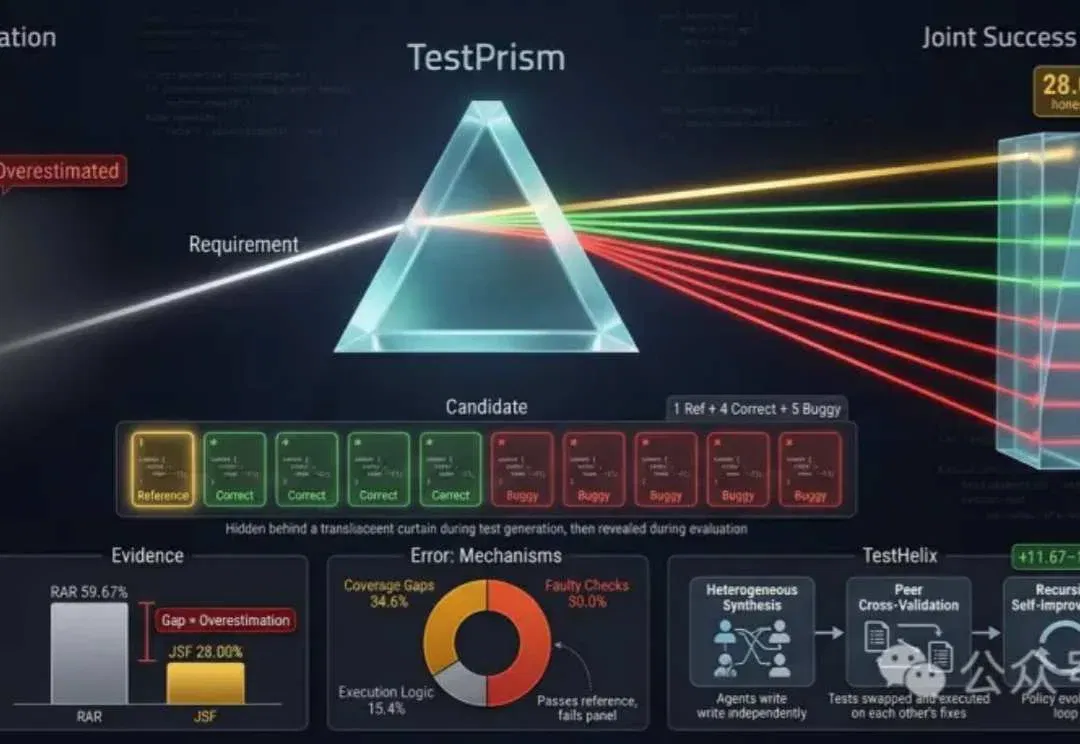
TestPrism 检验智能体生成测试,多实现评测暴露可靠性差距(在新窗口打开)
研究用正确替代实现和错误实现共同检验测试,最强受测配置的联合成功率为28%;TestHelix 通过交叉验证改进结果。
共 921 篇
研究用正确替代实现和错误实现共同检验测试,最强受测配置的联合成功率为28%;TestHelix 通过交叉验证改进结果。
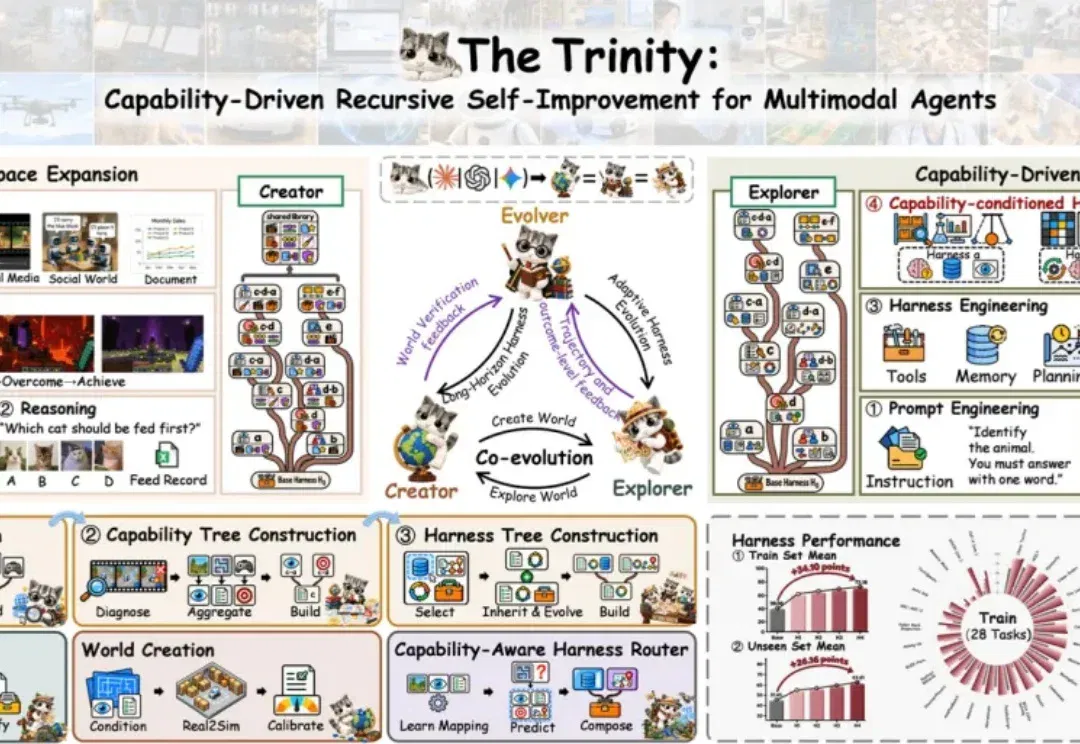
团队让环境生成、探索和框架改进三个角色协作,在固定基座模型下迭代运行框架。论文报告四轮实验和两个真机任务的迁移结果。
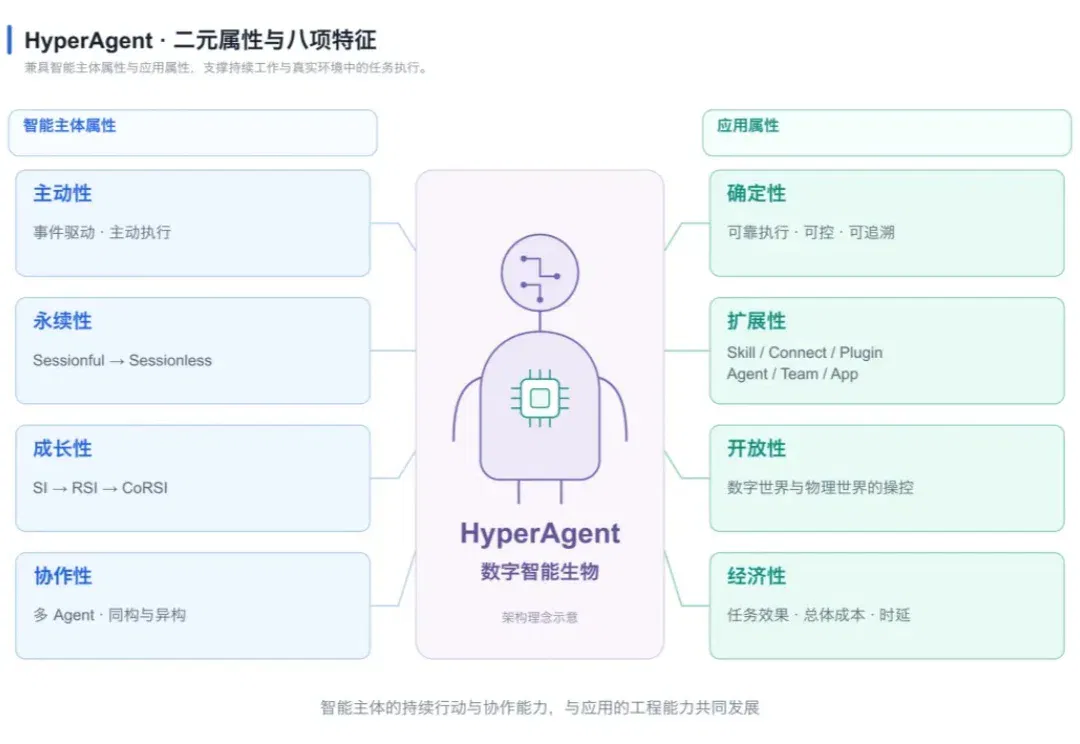
openJiuwen 解读 HyperAgent 的八项特征与 AgentOS 分层,介绍持久状态、多智能体协作和分布式运行,并区分已实现能力与后续架构方向。
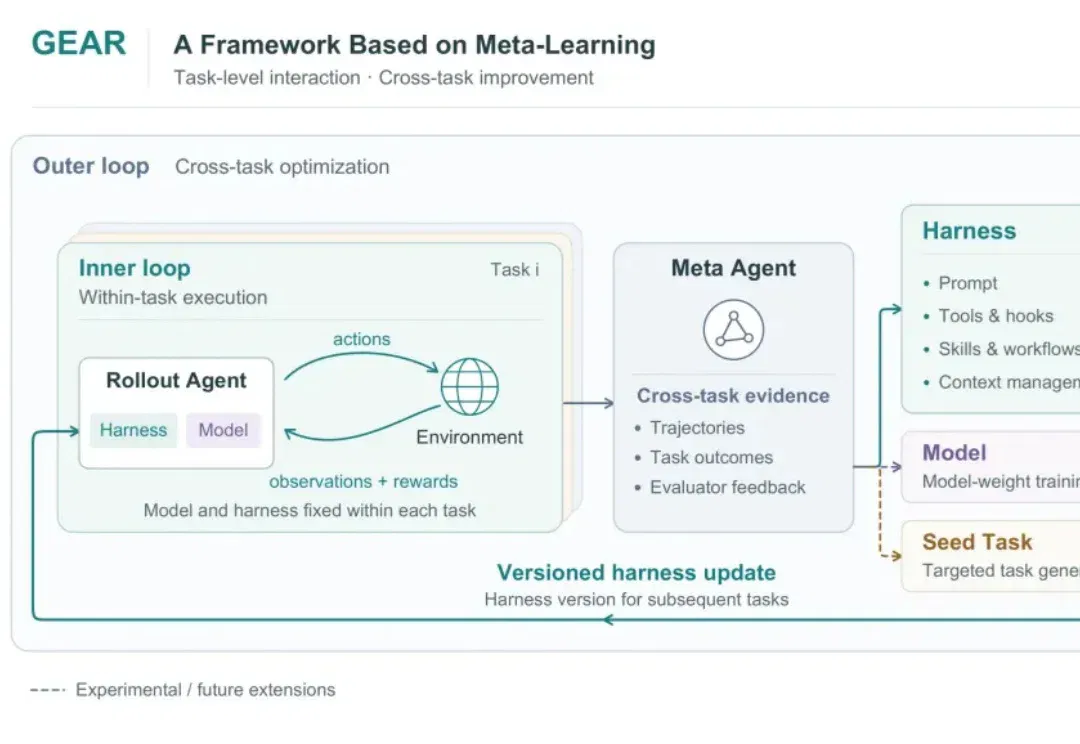
GEAR 将采样、候选评测和多样性管理组织为模块。在固定模型和推理档位的对照中,改进后的运行框架在营销、客服和代码任务上提高了通过率。
Meta 将 Muse Ember 定位于工具调用、代码修复等高频任务。报道引述评测机构的结果,并列出其每百万输入 0.10 美元、输出 0.50 美元的发布价。
智东西采访 dsh-Go 作者小C,回顾其开发移动端应用的过程,并讨论安卓适配、社区协作、AI 辅助编程与个人开发者的需求判断。
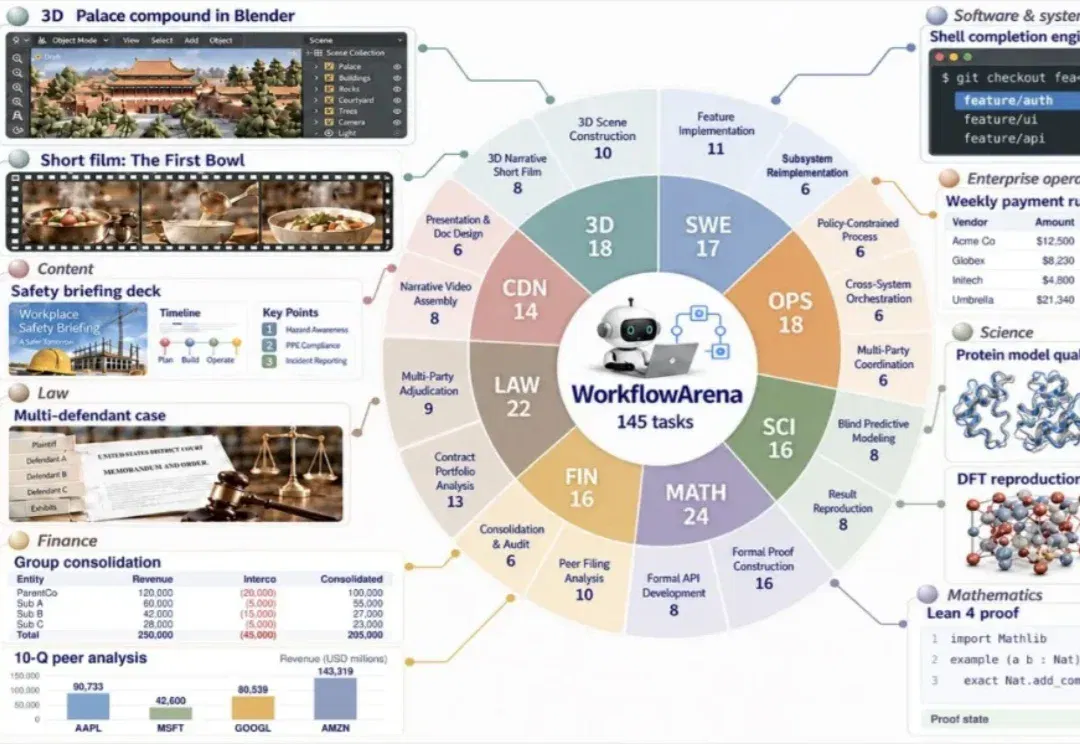
Einsia AI 团队在八个领域比较九个模型的 25 种推理配置。按其完全解决标准,最高配置得分为 36.95%,工作流迁移实验另采用连续得分。
体验者为一家三店茶饮品牌搭建了模拟场景,让智能体分别处理策划、采购、财务和执行。文章记录约两小时的筹备过程与人工复核环节。
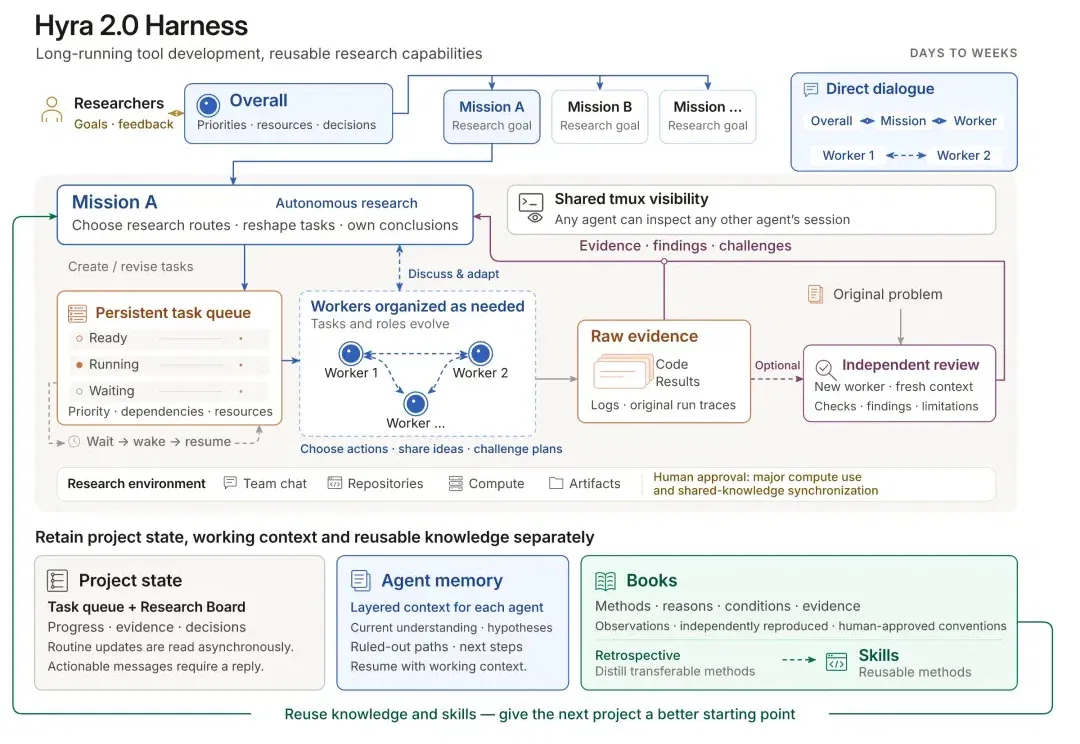
腾讯科研团队展示多智能体分工、模型训练和数学研究案例,并据报道讨论建设自主科学实验室的计划。
InfiniFlow 将文档处理、证据导航、图谱和 Wiki 作为供智能体调用的上下文层。文章介绍流程版本、失败重试及旧版迁移范围。